科学评估因子挖掘LLM样本外检验研究审计
LLM挖出的因子,为什么要先审计再谈收益?
一篇因子挖掘审计论文发现:统计总体混用、按样本外结果删记录,会让漂亮报告失去解释力。本文结合原表,讨论完整队列、指标口径与增量价值该怎样核验。
让大模型批量提出因子,再交给回测程序筛选,已经能做出很像研究报告的结果:保留了多少因子,平均Sharpe多高,样本外是否发生反转。困难在于,这些数字即使都能追到文件,也未必回答了我们以为的问题。
Yufeng He在2026年10月21日提交的预印本《Auditing LLM Alpha-Factor Mining: Metric Provenance and Full-Cohort Reanalysis》,检查了一个保留有源码与运行产物的项目。它没有提出新的挖掘算法,而是逐项追问:报告到底平均了谁,失败结果去了哪里,重新计算后的正相关又能说明什么。
这是一项具体项目的审计案例,不能据此断言所有LLM挖因子系统都存在同样问题。但其中暴露出的统计习惯,很值得放进自己的研究流程里检查。
图封面
封面
两个平均Sharpe,可能根本不在比较同一件事
历史项目包含三角色流水线与二十专家工作流。三个运行报告各有20轮,分别记录67、20、11次保留决策。这里的“保留次数”还不能当成最终因子池中互不重复的有效因子数。
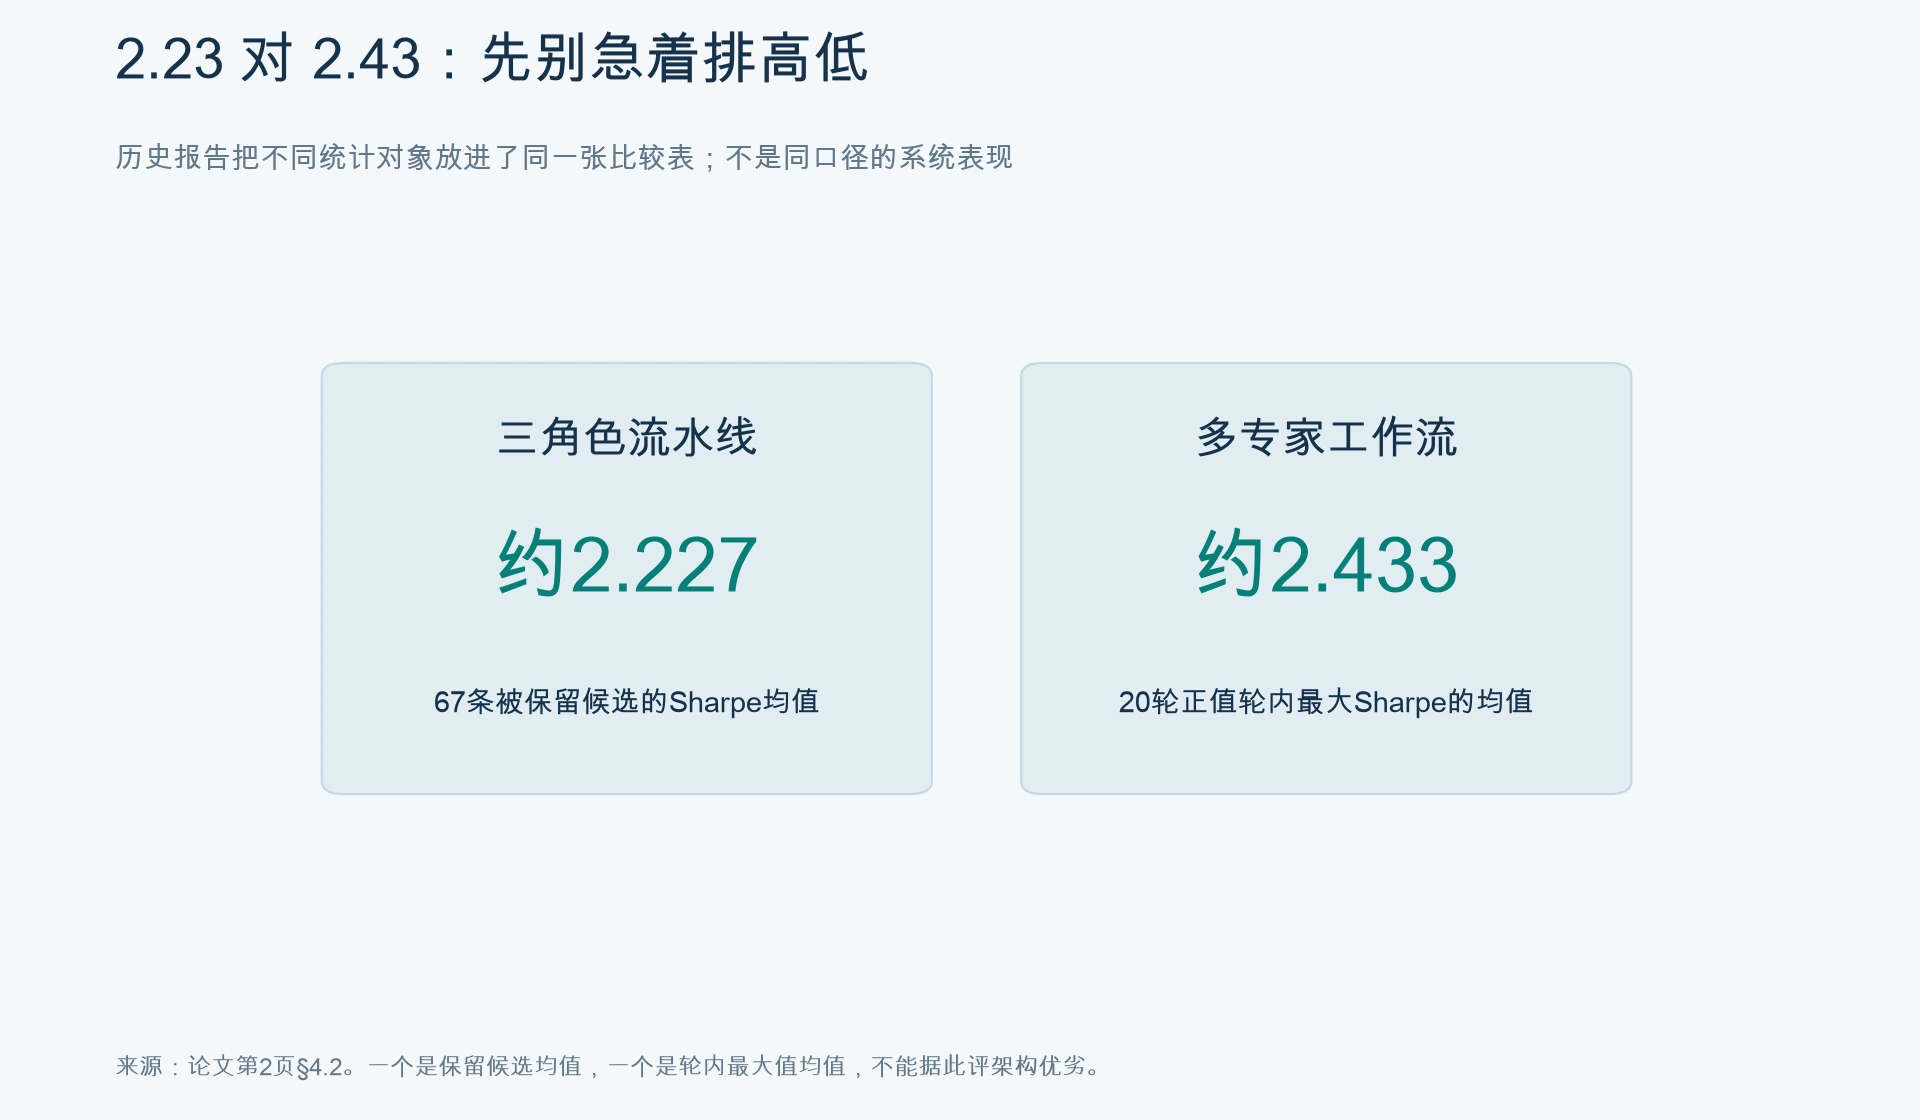
更关键的是平均Sharpe。流水线把被保留候选的Sharpe放进集合,多专家工作流收集的却是每轮正值的最大Sharpe。论文根据打印到三位小数的报告条目,重算出约2.227与2.433,对应原先显示的2.23与2.43。
比较对象一边是候选,一边是轮内冠军。即使每个数字都算对了,把二者放在一起仍然不能证明后一个架构更强。最大值也有类似问题:流水线被保留候选的最大值为2.449,但它的已评估轮摘要最高达到3.171;多专家的4.206来自已评估轮内最大值,未必进入了保留集合。
分母同样需要检查。234是流水线报告的成功结果数,816是另一工作流返回的结果数,可能含失败与额外的符号翻转评估。直接算67/234与20/816,看起来像接纳率比较,实际上还没有建立统一分母。
读报告时,可以先追问一句:一行记录对应一次提案、一次计算、一个成功结果,还是一次入池决策?这一步没有说清,多跑几个随机种子也修不好统计对象错位。
图统计口径
统计口径
样本外没有反转,先看失败结果是否还在
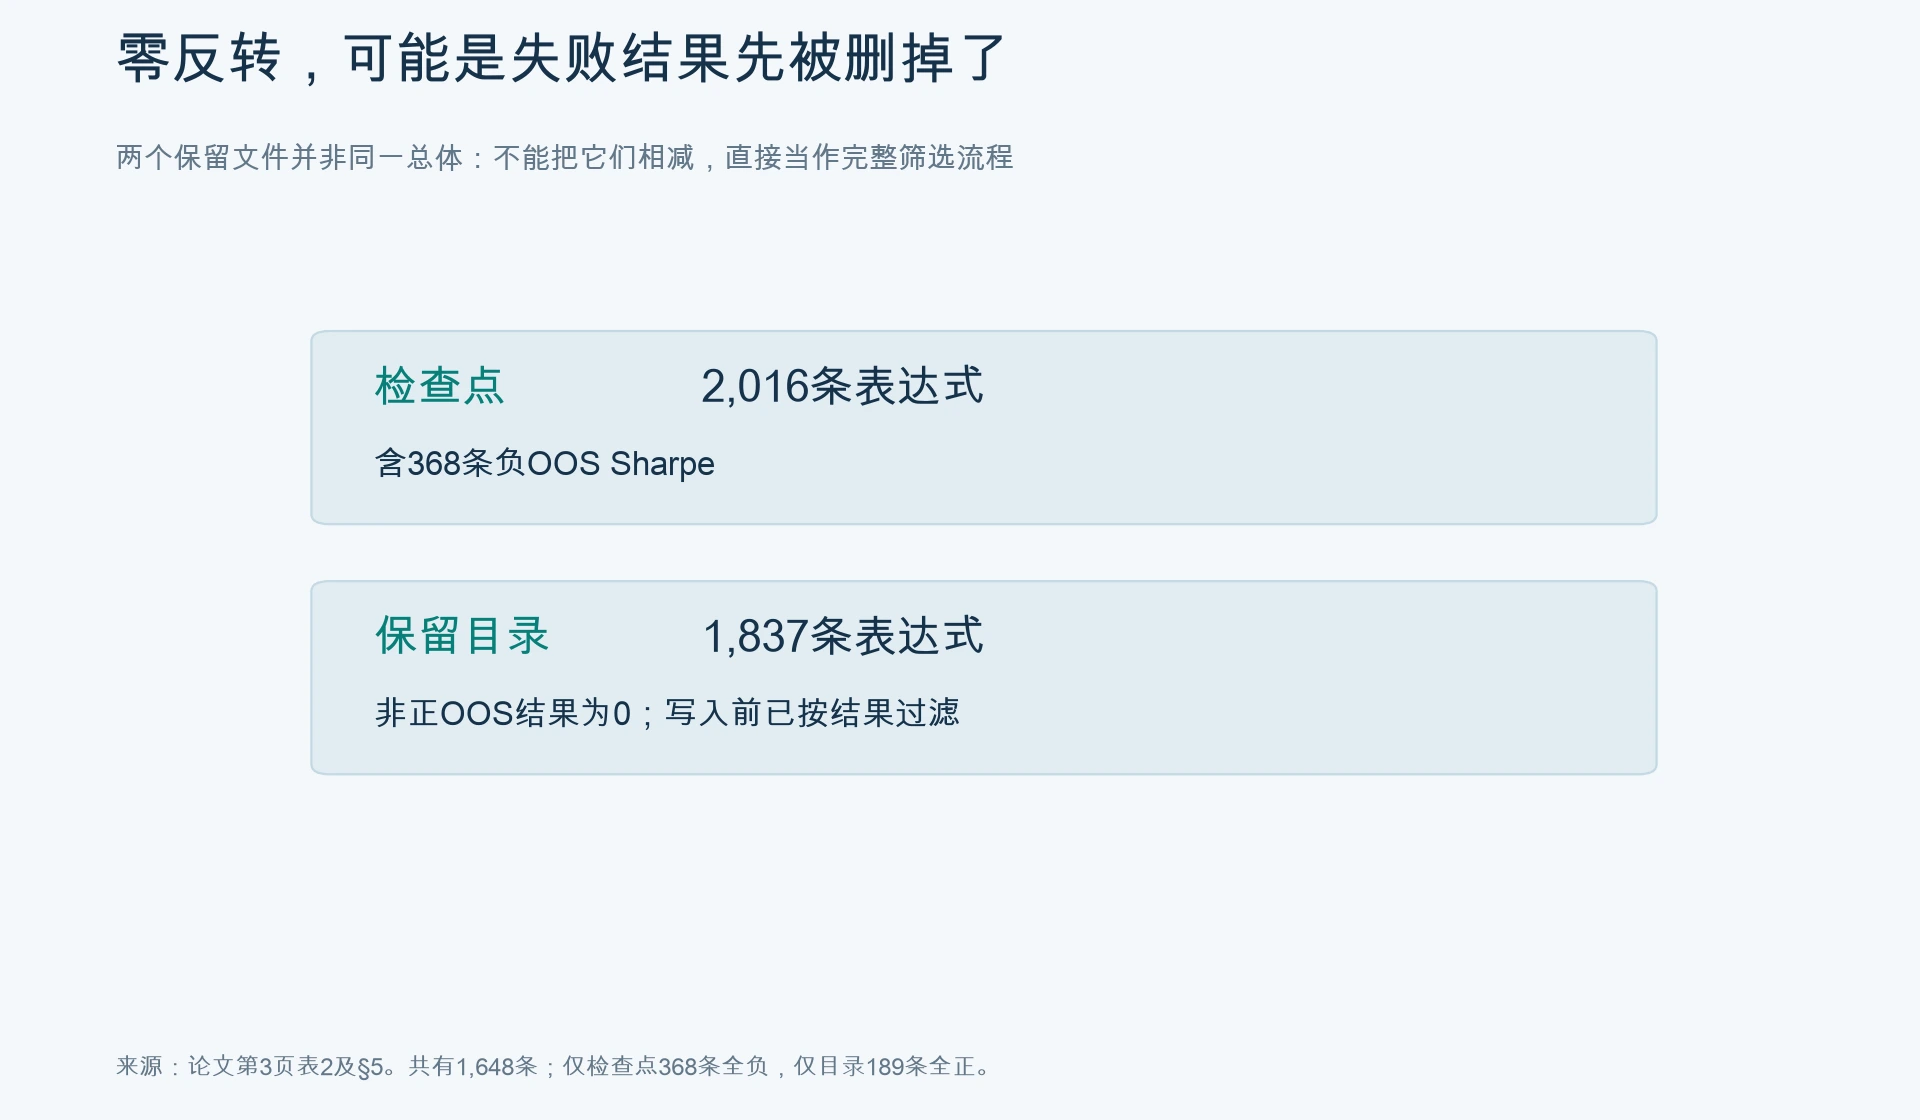
论文检查的另一份目录包含1,837条表达式,曾被解释成样本外验证集。审计发现,程序写入这个目录之前,会删掉样本外Sharpe小于等于零的结果。
这样得到“没有非正结果”,只是筛选规则的直接后果。再用它证明样本外稳健,评价过程已经把答案写进了样本选择。
表2保留了核对关系:检查点有2,016条唯一表达式,其中368条样本外Sharpe为负;保留目录有1,837条,非正样本外记录为零。两个文件共有1,648条,符号没有分歧;仅在检查点出现的368条全为负,仅在目录出现的189条全为正。因此,不能简单用两个总数相减,假设它们是一条完整筛选链。
目录中还有另一个口径问题:只有1,037条满足文稿写明的样本内规则,即Sharpe≥2、Fitness≥0、Turnover≤500。这说明文字描述的筛选规则与落地文件也需要对照。
这很像只保存通过质检的产品,再根据出库名单宣布“生产过程没有不良品”。类比只解释记录选择偏差;金融样本还有时间依赖、重叠收益和市场状态变化,不能拿工业抽检公式直接替代因子检验。
图结果保留偏差
结果保留偏差
重算时,先把算不出来的表达式也留下
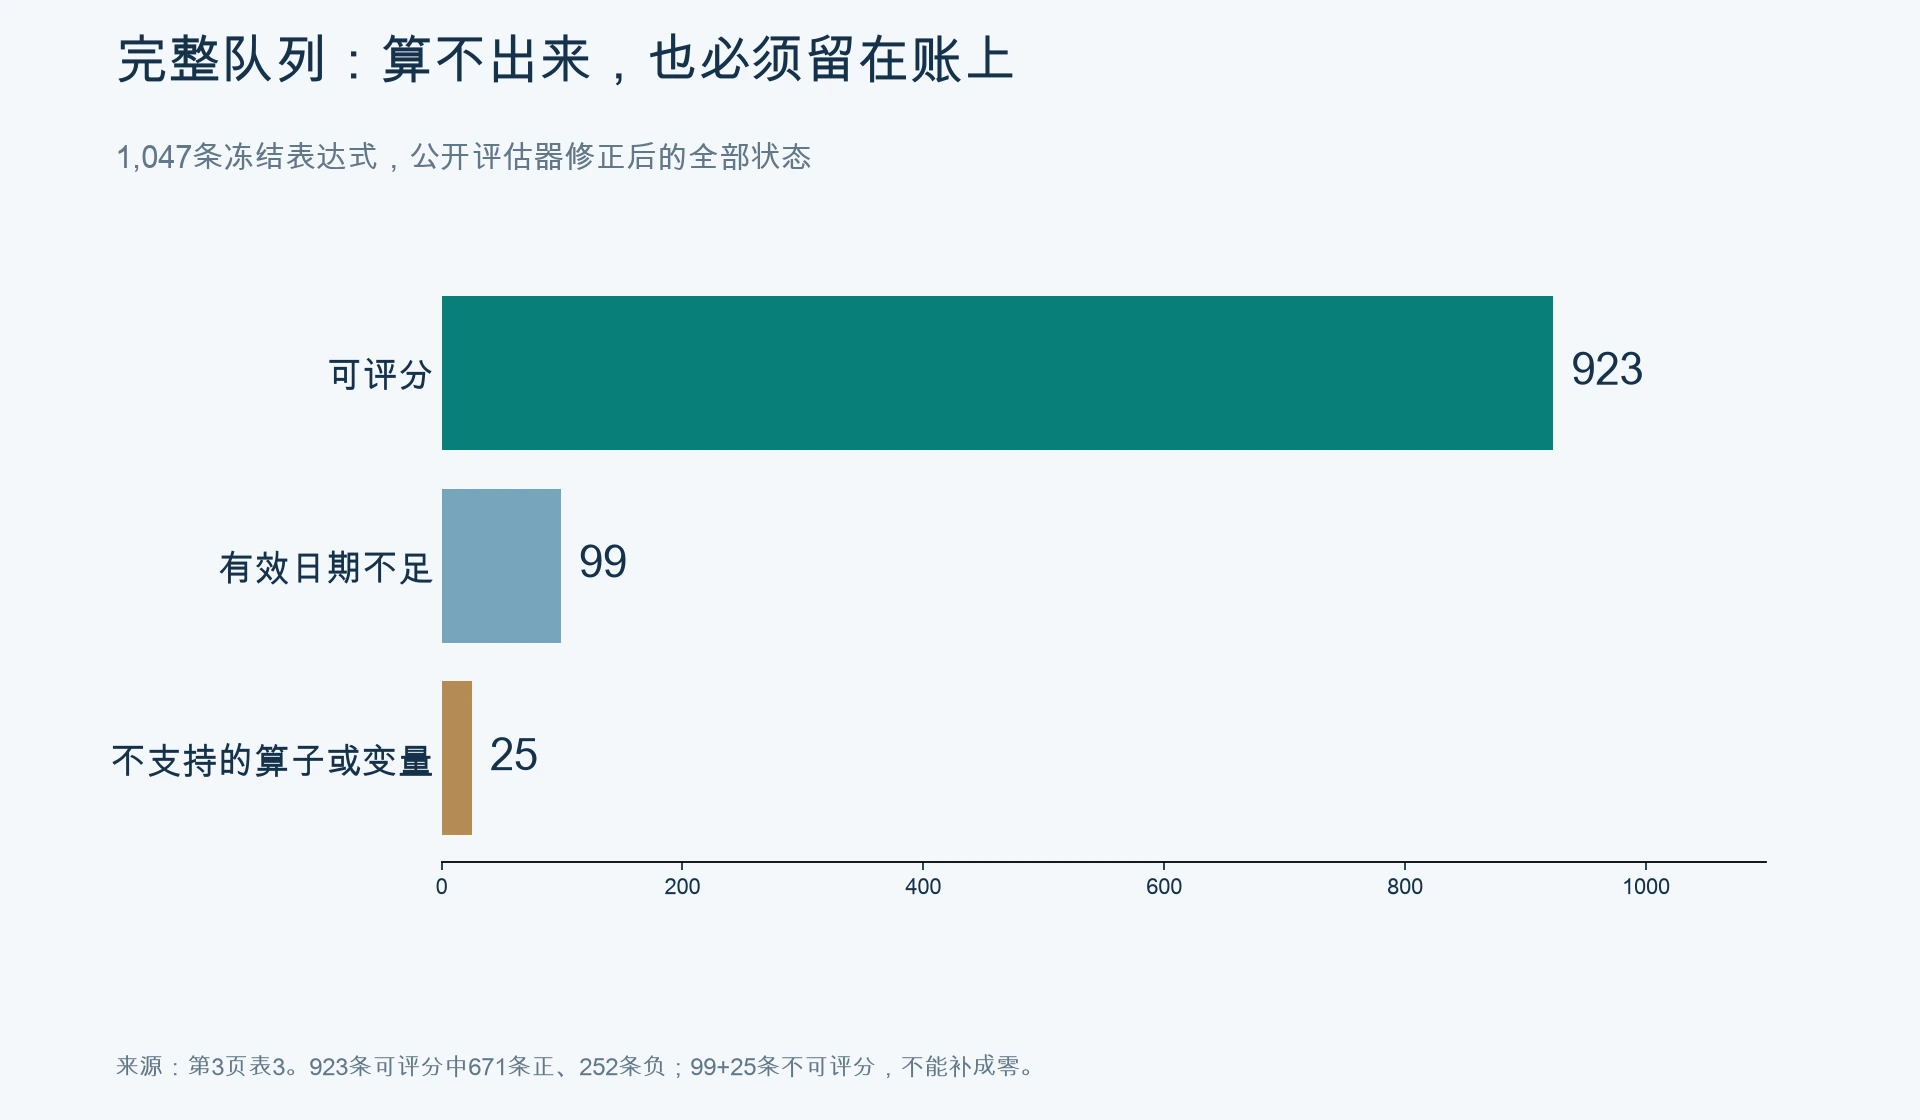
作者另行冻结了1,047条唯一表达式,它们由3,114条保留输入记录按所述样本内规则选出。这个队列不同于前面的1,837条目录,也不能回填成三个历史运行的同口径重赛。
公开重分析采用40只A股的便利样本,数据快照覆盖2023—2025年727个交易日,目标评分日期在2024—2025年。标签是供应商复权收盘价跨五个交易日历行的变化;它不是投资者总回报,也不是可执行交易损益。最后五个快照日期没有标签。
评分使用每日横截面rank-IC,也就是信号排名与未来收益排名之间的相关性。每天至少要有五只合格股票、三种不同信号值和两种不同标签值;因子至少有20个有效日期才评分。三种信号值是本文采用的诊断规则,不表示二元信号在数学上不能计算相关性。
最初的公开评估器出现57条数值错误:条件算子在真分支为标量时,错误地把整个面板当成一个布尔值。作者保留了初版,增加标量广播修正,再重算全部1,047条,而非只挑值得期待的失败案例重跑。其余990条诊断记录保持不变,修正的57条中有56条变得可评分,一条仍然有效观察不足。
修正后,可评分923条,有效日期不足99条,算子或变量不支持25条。三类加总仍是1,047。没有结果的124条留在总账中,但不被填成零IC,也不被悄悄丢弃。
这比一张漂亮的平均指标表更基础:每一个冻结ID最后都能对上状态,研究者才知道自己评价的总体是否发生了变化。
图完整队列账目
完整队列账目
671条正IC,并没有证明智能体产生了增量价值
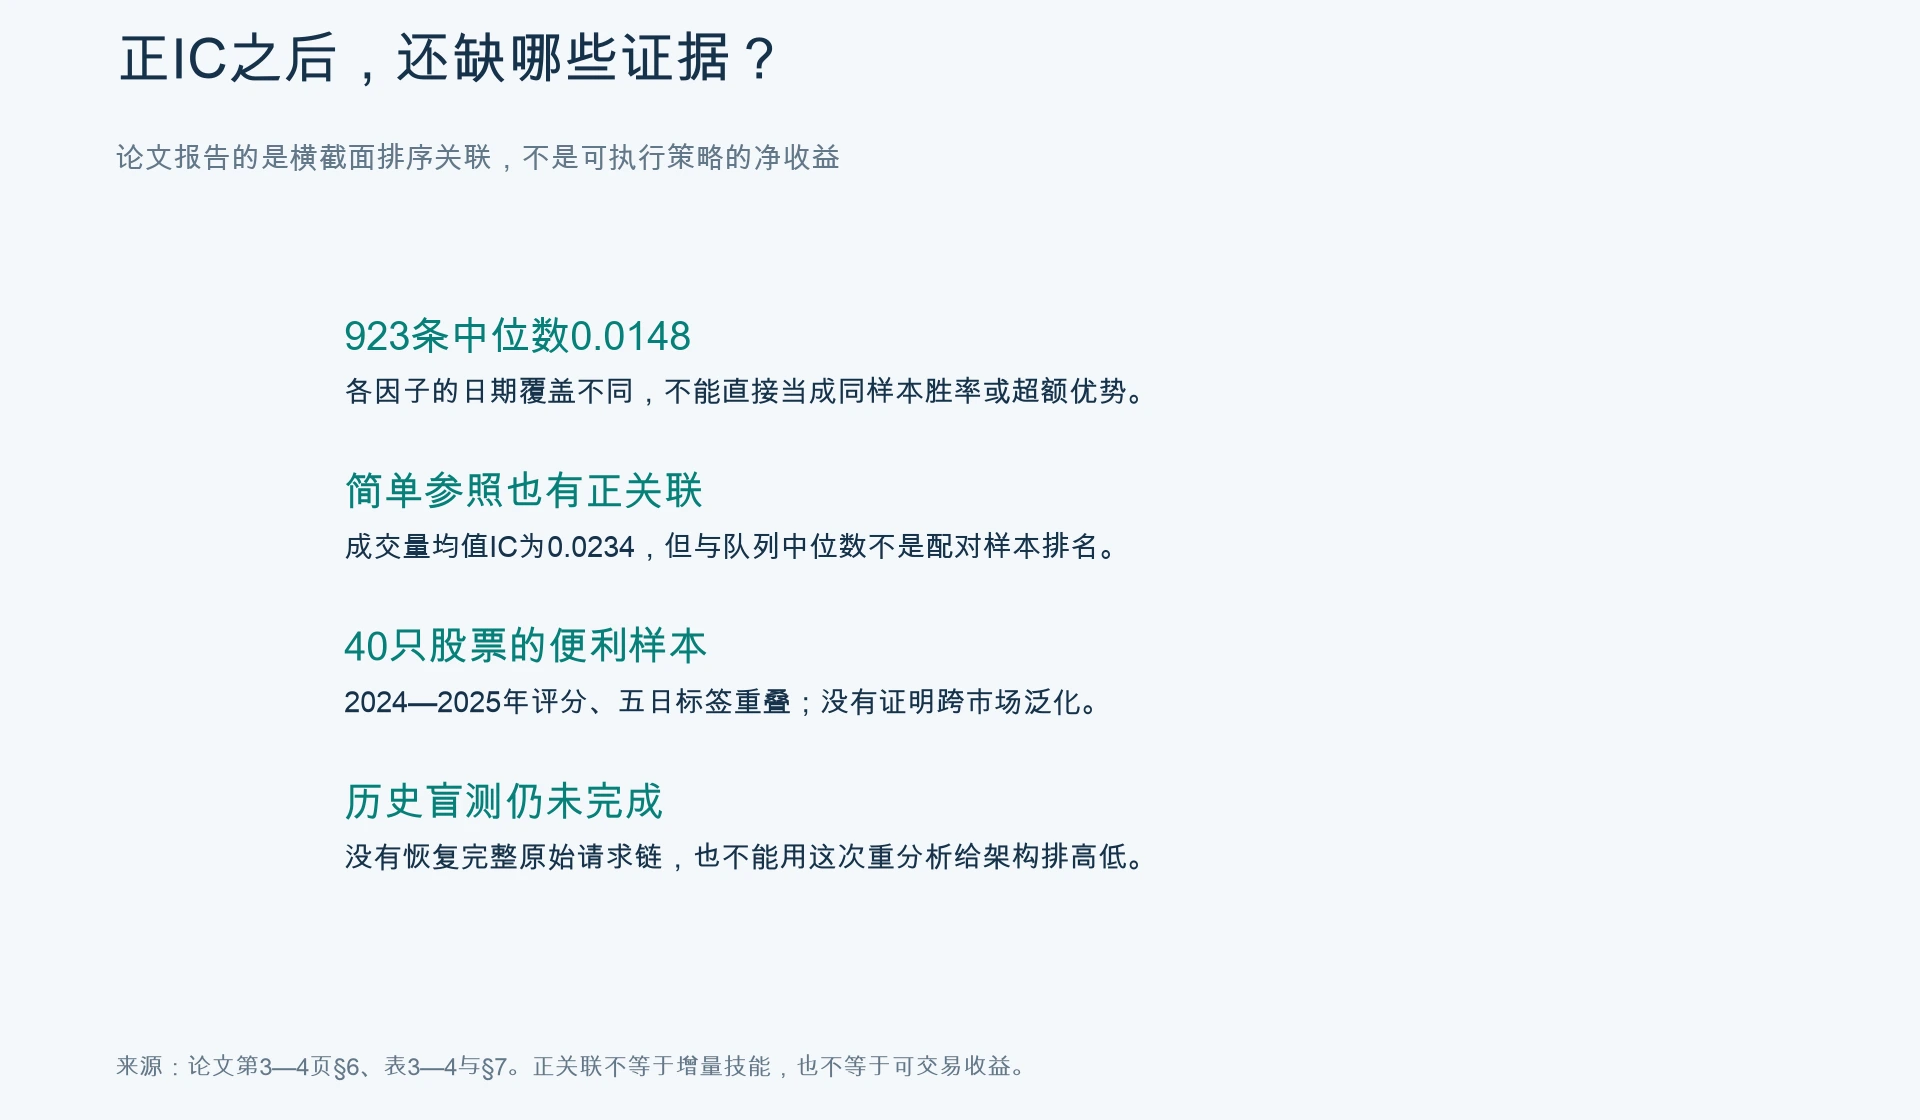
923条可评分表达式中,671条平均有符号rank-IC为正,252条为负;平均rank-IC的队列中位数为0.0148。这个结果可以描述当前队列,不能直接翻译成盈利能力。
作者还报告六个未训练的固定参照信号。成交量的平均有符号rank-IC为0.0234,二十日名义价格变化为0.0229,二者也为正。这让“因子有正IC,所以智能体有效”的推理显得不够完整:还没有测量它超越这些简单参照的增量预测信息。
但也不要把0.0234与0.0148直接相减,宣布成交量赢了挖掘因子。前者是单个参照信号的均值,后者是因子队列中位数;各因子的可用股票与日期还可能不同。923条中835条覆盖全部480个有标签目标日,其余88条覆盖不一致。参照结果也是队列分析后才计划的描述性检查,不能改写成预先设计的配对竞赛。
五日标签相互重叠,因子之间也有关联。把每个因子当成独立试验,再给671条正值套一个独立样本显著性结论,并不合适。论文没有提供真实交易成本后的盈利证据,也没有完成原历史项目的干净盲测。
图解读边界
解读边界
给自己的因子工厂留一份能查清的账
如果正在搭建LLM因子挖掘流程,这篇论文最直接的用处是改记录结构。候选生成、表达式去重、评估成功、符合筛选、最终入池,应分别计数;每个指标明确统计单位与分母。不同架构比较前,还要绑定起始池、实际代码版本、筛选政策与资源预算。
样本外访问之前冻结表达式列表与样本内筛选规则。计算返回后保留所有数值、负结果、错误和不可评分原因。修算子时保留版本,并对完整冻结队列重跑,核验未受影响记录是否保持一致。评价新因子时,使用共同的日期与股票掩码,并加入简单参照,进一步检查成本、换手与执行约束。
这项审计尚未解决“哪种智能体更会挖因子”。它先划清了可支持的结论:现有文件足以发现统计总体混用、按结果删记录和算子缺陷,却不足以建立架构优劣或真实盈利判断。把这些边界说明白,后续实验才不会在错误的分母上继续堆规模。
原文:Yufeng He,Auditing LLM Alpha-Factor Mining: Metric Provenance and Full-Cohort Reanalysis,arXiv:2610.29500v1,2026年10月21日。历史比较见第2页§4及表1;保留偏差见第3页§5及表2;公开重分析与限制见第3—4页§6—7及表3—4。本文仅基于这份预印本解读,未独立取得并复算作者的底层运行产物。
本文由AI辅助整理,配图依据论文数字与方法重新绘制。内容仅供研究方法交流,不构成投资建议;历史关联与回测结果不代表未来收益。
资料与阅读边界
本文为方法讨论与教学说明。文中示例不等于经独立验证的收益实证;如需具体数据、计算口径或资料来源,可通过官方渠道提出核对请求。
历史结果不代表未来表现。使用前请检查数据时间边界、样本独立性、交易成本及适用条件。
关键结论
- 比较指标前先统一统计对象、分母与初始状态。
- 冻结样本外队列后保留所有数值、错误和不可评分原因。
- 正IC需要在共同样本和简单参照下检验增量价值,不能直接当作盈利。