 进阶
因子工程因子血缘因子溯源依赖管理量化工程
大规模因子如何做血缘关系与溯源设计
系统讲解大规模因子体系中的血缘关系设计、依赖追踪、版本管理与可追溯计算,帮助量化团队降低重复计算成本并提升部署效率。
在单个研究员手工管理几十个因子时,很多问题都还能靠记忆和脚本命名解决。但一旦团队开始批量生产因子、做模板化衍生、做多版本实验,因子的父子关系、共享中间节点和公式变种就会快速失控。
真正难的地方不只是“记录一个因子来自哪个公式”,而是要明确它依赖了哪些基础字段、哪些中间特征、哪些滚动窗口与标准化步骤。只有把这条血缘链条建清楚,后续的重算、调试、回溯和风控才有可能做好。
- 看清因子依赖关系,避免重复计算相同中间结果
- 定位异常因子时,可以快速追溯到具体字段、公式版本和处理步骤
- 上线部署时,只计算变化节点及受影响的最小闭包
一个可落地的血缘建模方式
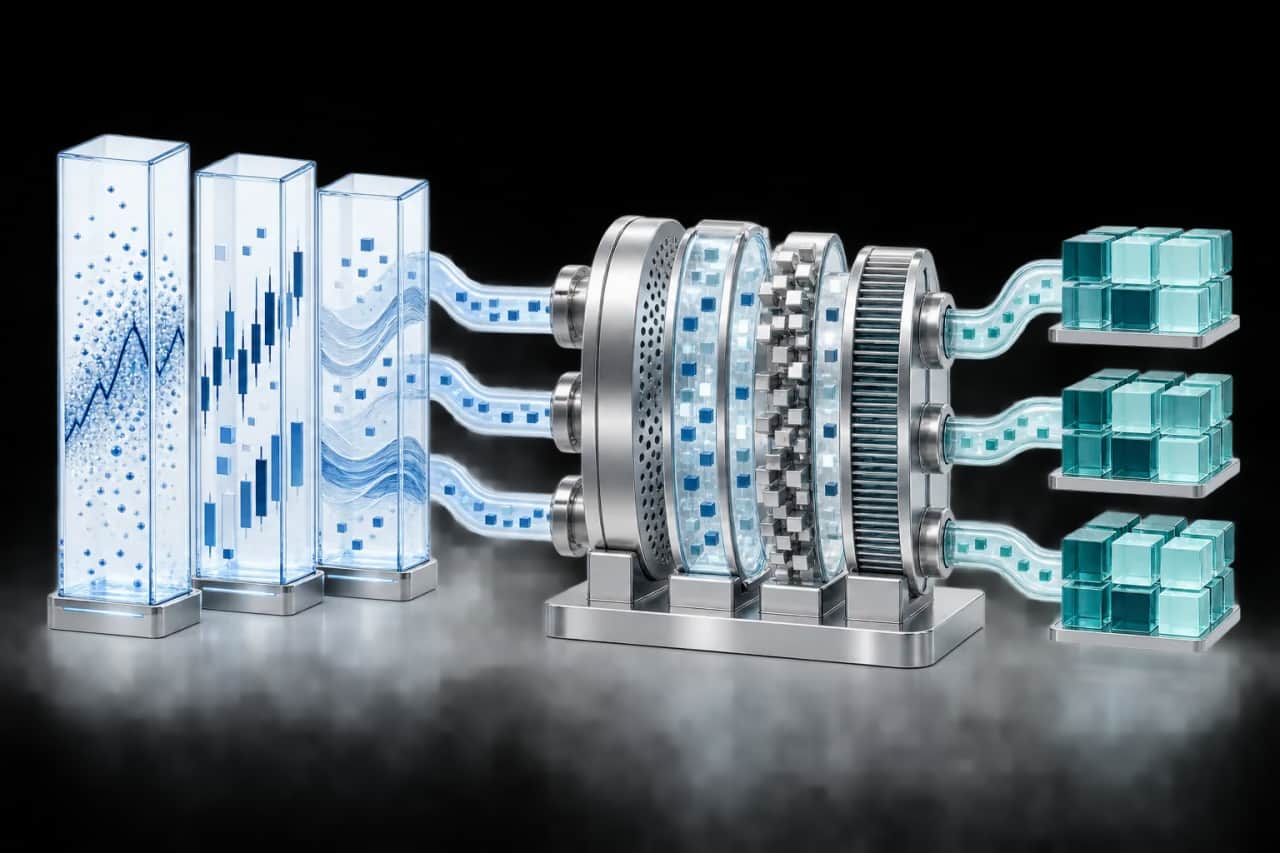
比较实用的做法是把因子拆成若干层级节点,例如原始字段层、中间特征层、标准化层、组合层和最终信号层。每个节点都应该有稳定 ID、输入依赖、处理逻辑摘要和版本信息。
当你把这些节点组织成 DAG 以后,就可以从“公式文本”升级到“可执行依赖图”。这不仅方便研究,还能直接服务于调度系统,让生产环境根据依赖关系决定需要重算的最小节点集合。
- 节点层级化:原始字段 → 中间特征 → 标准化 → 组合 → 信号
- 每个节点保留版本、参数、数据窗口和来源说明
- 把血缘图和调度图统一,减少研究与部署之间的断层
如何把血缘体系真正用于执行提效
血缘体系最大的价值,不是为了画出一张漂亮的依赖图,而是为了在每日更新和回测重算时只做必要工作。比如原始行情字段没有变化时,就不需要重算所有依赖于其他分支的因子;参数只改动某个窗口时,也只需要重算相关子图。
这类最小重算思路对大规模因子工厂特别重要。它会直接降低 CPU 与存储开销,也会让研究迭代速度更快。对于已经开始做因子生产线和版本治理的团队来说,这往往比多写几个新因子更能提升整体效率。
资料与阅读边界
本文为方法讨论与教学说明。文中示例不等于经独立验证的收益实证;如需具体数据、计算口径或资料来源,可通过官方渠道提出核对请求。
历史结果不代表未来表现。使用前请检查数据时间边界、样本独立性、交易成本及适用条件。
关键结论
- 把因子从公式升级为可追踪节点,才是真正可运营的因子工程
- 血缘图的核心价值在于定位问题和最小重算,而不是展示关系图
- 研究、版本、调度和部署最好共用同一套血缘语义
关联课程
如果你想把这篇文章里的方法系统化学习,可以从这些课程继续深入。