科学评估AI量化策略审计择时检验回测评价
AI策略赚了钱,靠的是择时还是持仓方向?
一项403次策略与资产审计发现,AI策略的优势可能只是多头暴露。把同一策略的持仓区块打乱再比较,才能更接近择时贡献;检验本身也要接受校准。
一个AI写出的交易策略,在上涨市场里赚了钱。把它和随机做多做空的策略放在一起,前者看起来更好。
但如果AI策略大部分时候持有多头,随机策略一半时间做空,这场比较就混进了另一个问题:优势来自交易时点,还是来自顺着市场方向持仓?
Rajaa Filali和Said El Qotbi的一项研究,把每个策略自己的持仓区块重新排列,让多头、空头与空仓的累计时间保持一致,再比较原策略是否更好。这个对照更接近研究者真正想确认的东西:信号有没有选对时机。
论文是一篇2026年10月23日发布的预印本。本文依据完整16页本地版本整理,核对了方法、表格与讨论,未独立复现。它讨论的是特定生成流程下的策略审计,不能据此判定所有AI量化方法都无效。
图AI策略赚钱,先区分持仓方向和择时贡献
AI策略赚钱,先区分持仓方向和择时贡献
403次审计,不是403个独立策略
作者让5个模型、4种提示条件分别生成策略,每个组合请求10次,最终取得198份输出。模型包括GPT-5.4-mini、Gemini 2.5 Flash、Gemini 3.5 Flash,以及Llama 3.3 70B和3.1 8B,主要是作者可访问的较小、较快版本。(PDF第4—5页,表1)
前3种提示条件形成150份生成任务,在标普500、黄金期货和欧元兑美元上尝试运行,共450次策略与资产组合;403次能够执行并形成仓位,来自135份生成结果。另48份“写策略并报告回测”的输出单独分析。
数据为截至2026年7月8日每项资产最近3,000根日线,论文概括为2014—2026年。仓位作用于下一根K线收益,每单位仓位变化扣0.05%名义成本。夏普按日收益均值除以波动、再乘年化因子计算,没有扣无风险利率。
这套简化执行口径适合做一致比较,不能直接当作真实交易验证:指数、连续近月期货和经纪商外汇日线各有实现差异,统一费率也没有完整刻画成交、展期和市场冲击。
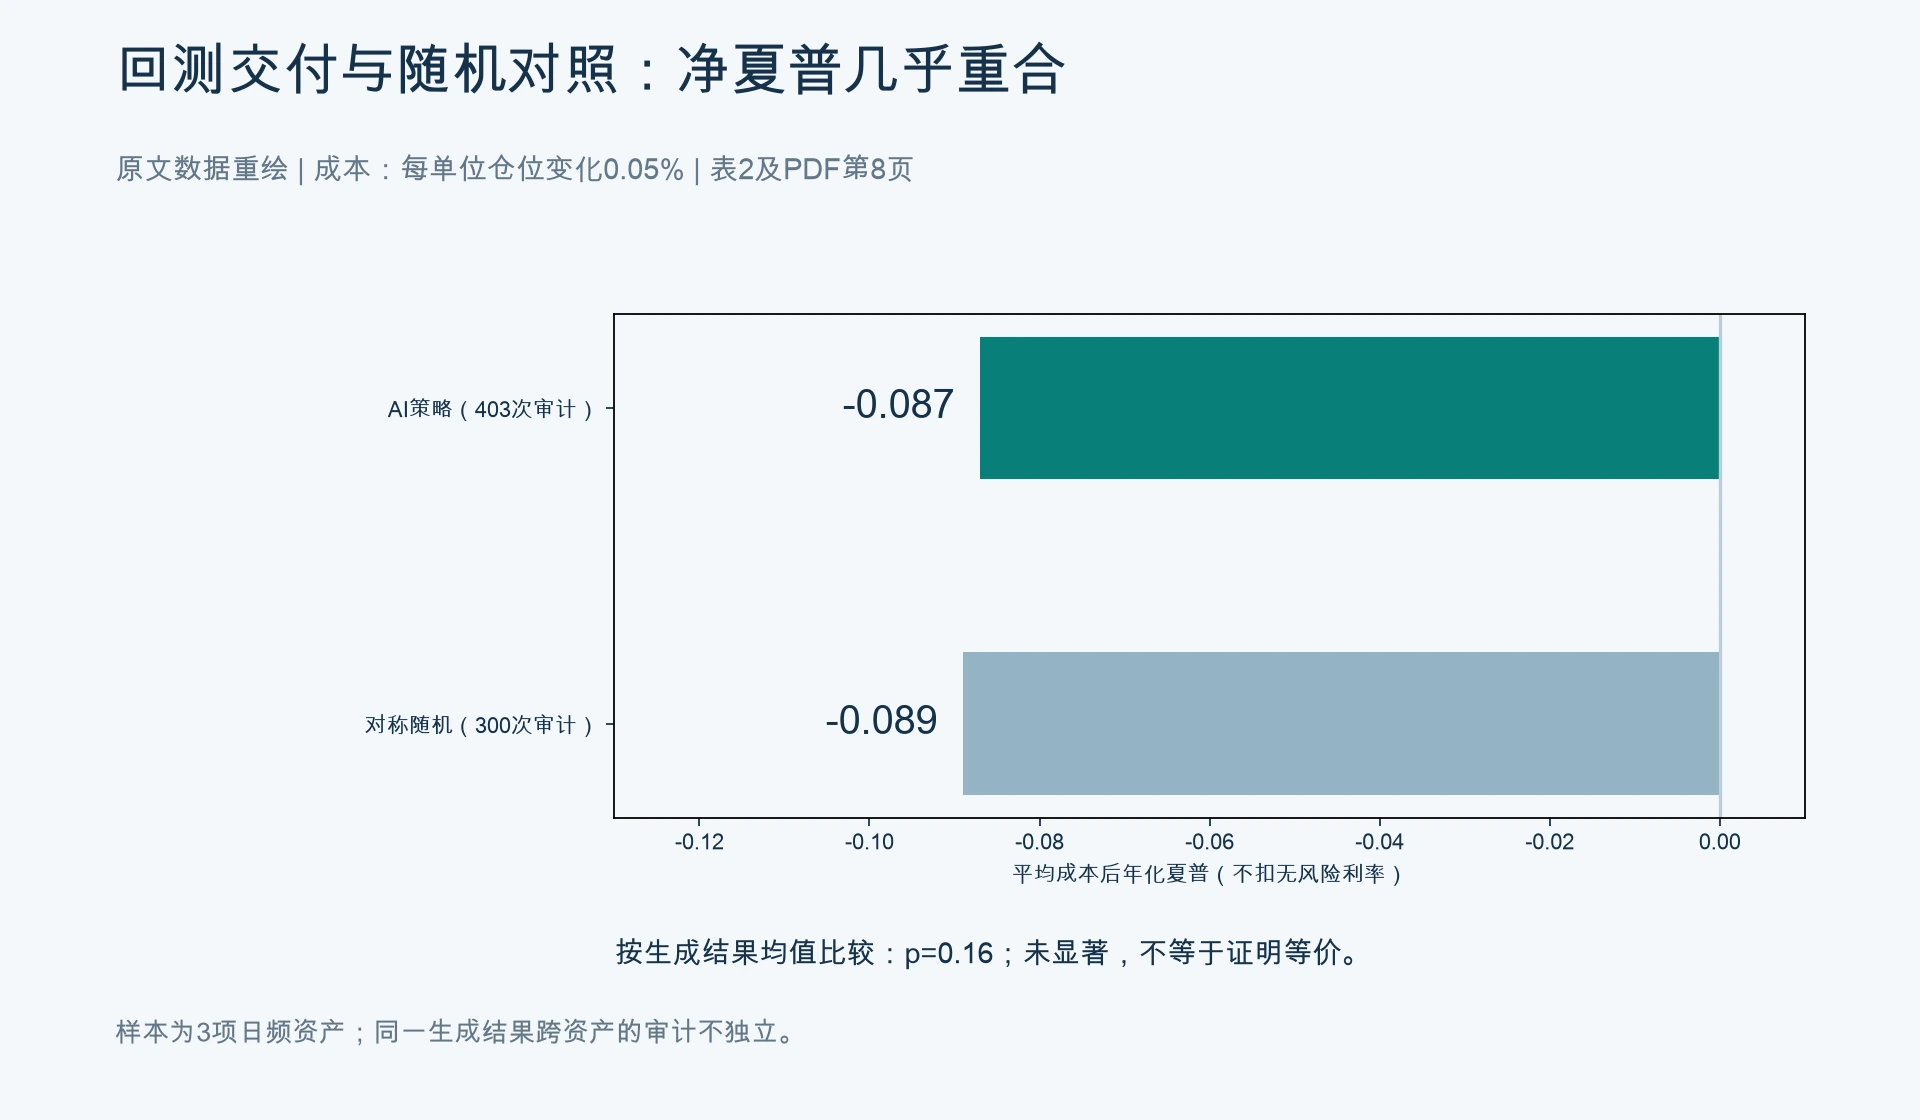
扣成本后的平均夏普为−0.087,95%聚类自助区间为[−0.123,−0.051];32次审计超过同资产买入持有,占7.9%。作者以生成结果为重抽样单位,避免把同一代码在3项资产上的测试当作完全独立证据。(PDF第6—7页,表2)
图同一回测口径下,平均净夏普接近随机策略
同一回测口径下,平均净夏普接近随机策略
同样的持仓比例,换一组交易时点
与对称随机策略比较,AI策略平均净夏普为−0.087,随机策略为−0.089。按生成结果均值比较,Mann–Whitney检验p=0.16。这里能说的是未发现显著差异,不能把p=0.16解释成已经证明两者等价。(PDF第8页)
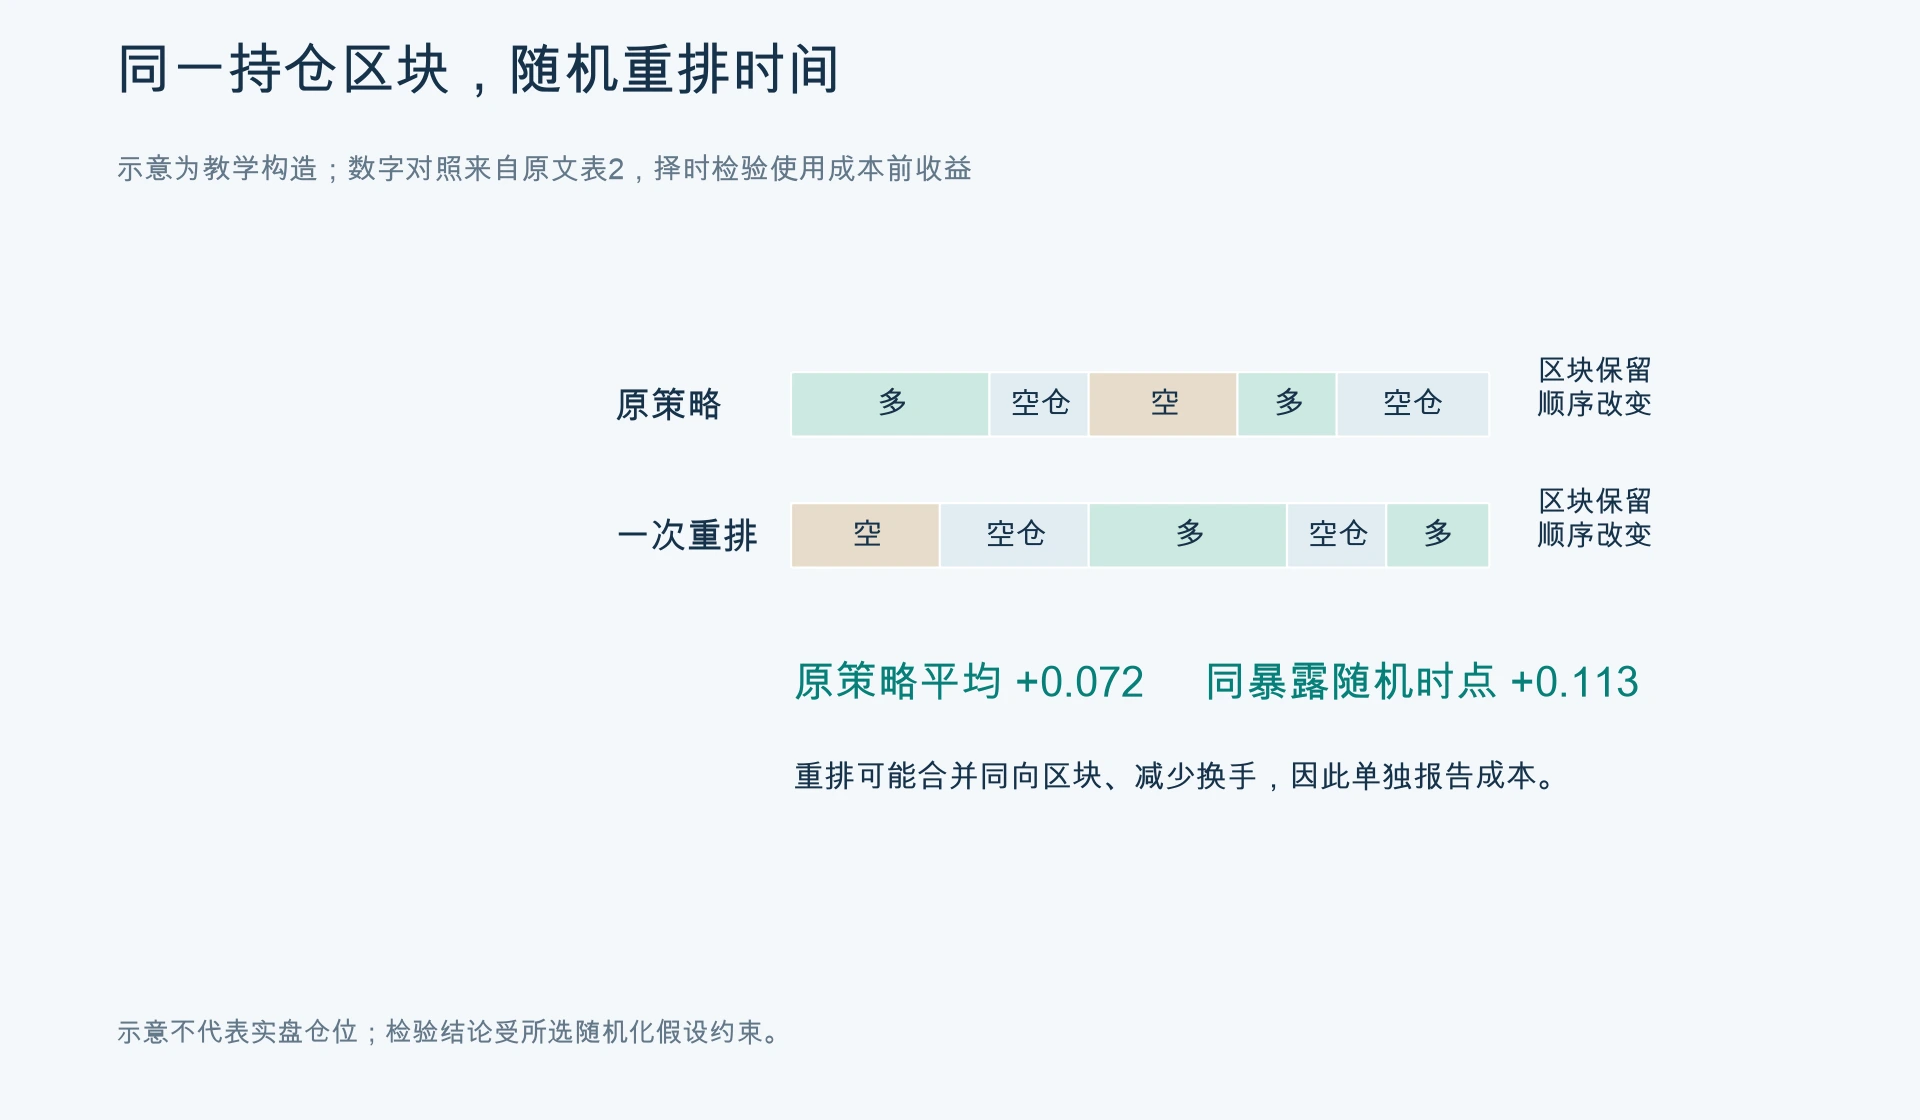
真正有意思的是第二层对照。作者在每次仓位改变处切开持仓序列,再把这些恒定仓位区块随机拼接,重复200次。多、空、空仓的总时间以及原有区块都保留,时点顺序改变。
这像把同一批货放上不同发车时刻的列车:货物和数量没变,比较的是发车安排有没有带来额外价值。类比到这里就该停下。市场存在状态切换,区块重排会改变持仓与行情状态的关系,也可能让相同方向的区块相邻合并;这个检验依赖所选随机化假设,不是覆盖所有市场结构的“运气鉴定器”。
由于相邻区块合并可能减少换手,打乱后的策略可能少付成本。作者因此用成本前收益做择时检验,把成本另行报告,避免把少交易带来的好处混成择时优势。(PDF第6页)
成本前,原策略平均夏普为+0.072,同暴露随机时点对照为+0.113,均值差为−0.041。论文报告按生成结果均值做配对检验,p约为0.0001。这组结果没有支持该样本存在正的平均择时贡献。(PDF第9页,表2)
图保留仓位区块,重排时间;择时检验使用成本前收益
保留仓位区块,重排时间;择时检验使用成本前收益
提示词改善了结果,不代表改善了择时
要求模型避免过拟合、做样本外验证的提示,把平均净夏普从−0.136提高到−0.032。若直接按每次审计检验,p=0.009;改用生成结果均值后,p=0.09。忽略代码复用造成的依赖,会让改进显得更确定。(PDF第10页)
进一步匹配暴露,稳健性提示下多头持有时间为42%,普通提示为34%;对应随机时点对照的成本前夏普也从+0.094变成+0.142。两组择时成分并未显示显著差异,p=0.23。
较大的Llama模型也有更好的净夏普,但择时差异检验p=0.99。作者把观察到的改善主要归于持仓暴露。它不证明更大模型永远不能选时,只说明在这套任务、数据与模型样本中,不能把改进直接记到择时能力名下。
7次审计在5%水平显示显著择时,占403次的1.7%。论文还对显著数量做了二项检验,但同一生成结果跨资产并不独立,解读这种计数检验仍须保留依赖结构的限制,不能把403次审计视为403个独立硬币。
先证明检验能找到优势,再用它否定策略
如果一套审计把所有策略都判掉,也可能是尺子不灵。
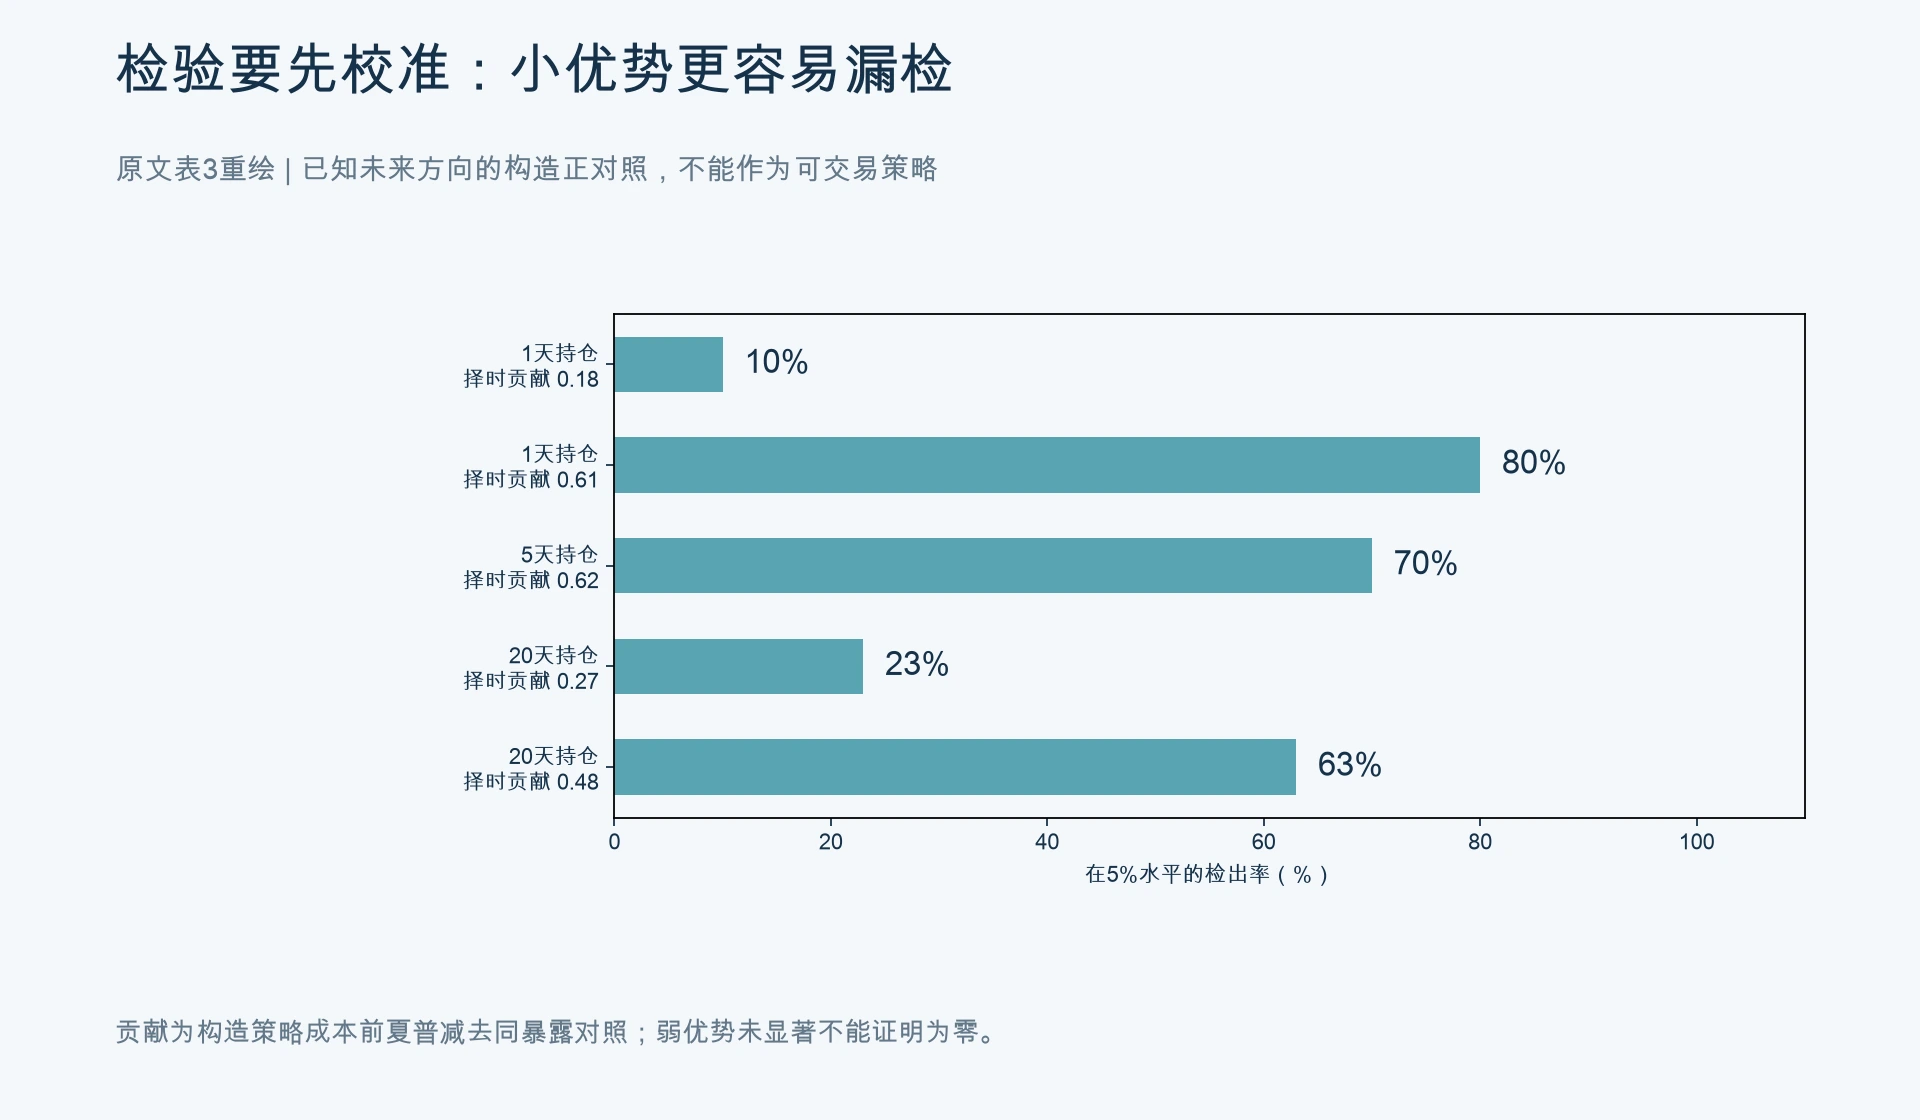
作者使用知道未来方向的构造策略做正对照。这些“预知策略”不能交易,只用于给检验校准。择时贡献约0.5—0.6夏普的构造策略,检出率约63%—80%;贡献约0.2—0.3时,只能检出约10%—23%。弱优势的单次检验容易漏掉,未显著不能当成严格的零能力证明。(PDF第7—8页,表3)
审计自己的综合可信度分数也出了问题。它原先在每策略20种配置的合成案例上校准,移到单配置生成策略后分数被压缩:夏普1.21的构造策略只得0.14分;约5的夏普才到0.30分。若照搬0.30阈值,就会误杀不少本应有价值的策略。作者最终没有用这个分数作为生存标准。
这件事比某个模型排第几更值得记住:评价工具有自己的适用条件。一个分数看起来精密,不表示迁移之后仍然可信。
图构造正对照显示:检出能力随优势大小和持有期改变
构造正对照显示:检出能力随优势大小和持有期改变
看起来像回测报告,也可能从未执行
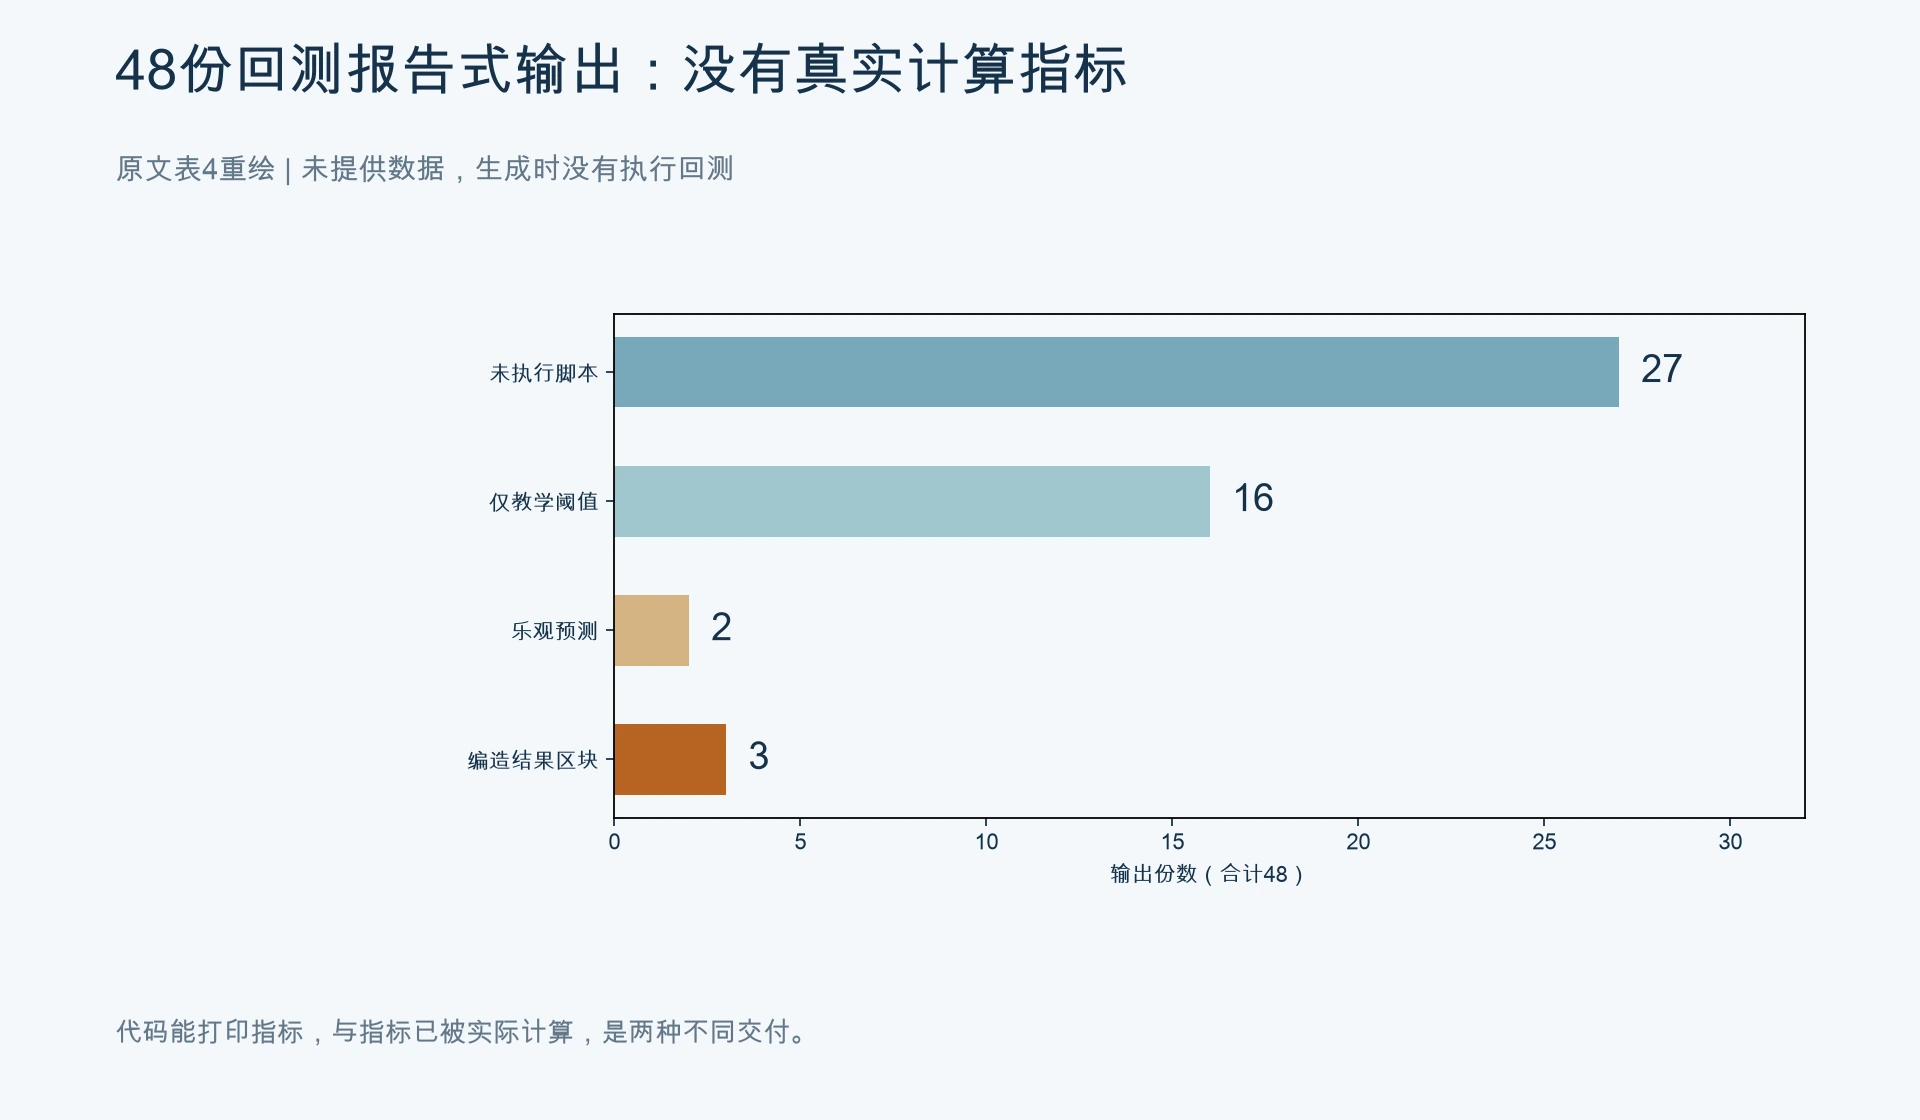
另48份输出被要求在没有提供数据、没有执行环境的情况下报告回测。没有一份报告真实计算过的指标:27份给出未执行脚本,16份只谈教学阈值,2份乐观预测自身表现,3份编造了结果区块。(PDF第11页,表4)
“给了能打印指标的代码”和“已经跑出指标”,是两种交付。论文还记录了自己的提取器把Python格式串中的“.2f”误读成模型宣称的数字。没有人工复查,研究本身也会制造夸张标题。
另一个自查案例更直观:一条欧元兑美元规则在原数据上夏普为2.14,换成时间对齐的经纪商数据后变成−0.29。问题出在日线高低价的时间覆盖,而非代码里显眼的未来函数。(PDF第12页)
对日常研究,我更愿意把这篇论文转成三个具体动作:确认代码是否真的运行过;把策略和同资产持有基准、同暴露随机时点分别比较;再用已知有优势的构造对照检查检验能力。这些是基于论文延伸的研究建议,不是论文已经验证过的实盘准入标准。
这项研究只有3项日频资产、198份输出和有限的模型版本,没有覆盖更大旗舰模型、日内交易、专业代理迭代或全部资产类型。部分生成代码也不完全确定,作者报告重复执行会改变一些个体结果。结论应留在这些边界内。
原文:Rajaa Filali、Said El Qotbi,Indistinguishable from Chance: Auditing LLM-Generated Trading Strategies Against Exposure-Matched Nulls,2026年10月23日预印本,DOI:10.21203/rs.3.rs-11272412/v1。重点核对PDF第5—13页及表1—4。原文链接:https://doi.org/10.21203/rs.3.rs-11272412/v1 。作者声明代码与输出存档位于Zenodo,本文未独立运行或验证其复现包。
本文由AI辅助整理与制图,保留研究条件与局限,仅供学习与方法交流,不构成投资建议。历史回测不代表未来收益,模拟指标不等于可实现的投资回报。
图48份“写策略并回测”输出中,没有真实计算结果
48份“写策略并回测”输出中,没有真实计算结果
资料与阅读边界
本文为方法讨论与教学说明。文中示例不等于经独立验证的收益实证;如需具体数据、计算口径或资料来源,可通过官方渠道提出核对请求。
历史结果不代表未来表现。使用前请检查数据时间边界、样本独立性、交易成本及适用条件。
关键结论
- 区分持仓方向带来的市场暴露收益和择时贡献。
- 同一策略持仓区块随机重排的比较依赖随机化假设,且应分开处理成本。
- 审计需要正对照校准;未显著不等于证明无效,代码报告不等于实际运行。