科学评估股票预测模型评价注意力机制量化研究
预测效果相近,模型就值得换吗?
一篇股票预测研究发现,低秩注意力在部分设定下可保持排序指标,但小股票池反而更慢,换预处理后等价证据也会变弱。模型替换要同时核对效果、速度与边界。
一个股票预测模型,把最昂贵的一部分计算换成近似算法,排序指标几乎没有变化。这听起来是一项很容易通过的工程优化。
但继续往下看:在300只股票的计算测试里,近似算法的单次前向反而更慢;改用另一种特征标准化后,原先的排序等价检验也不再通过。把“预测接近”“计算复杂度更低”和“值得部署”写成同一句话,就会漏掉这些条件。
Kunhan Guo的论文《Nyström Attention Matches Full Attention for Cross-Sectional Stock Prediction》研究了MASTER模型中的跨股票注意力。它给出的结果,适合拿来讨论怎样评估模型替换,而不是直接抄成一条“压缩以后更快、更赚钱”的结论。
这是一篇2026年9月的arXiv预印本,结论主要来自单一模型和A股数据。本文依据完整14页论文整理,未独立复现;IC与Rank IC是预测评价指标,不等于投资收益。
图模型替换,需要一起看效果、速度和适用边界
模型替换,需要一起看效果、速度和适用边界
看起来差不多的权重,也可能保留关键差异
跨股票注意力,让一只股票的表示吸收其他股票的信息。MASTER这一步包含约32.9万个参数,占整模型42.5%。研究者想知道,它究竟在处理什么,是否能简化。(第2页)
在约300只股票的实验中,注意力分布看起来很平均:以分布熵计算的“有效关注数量”约为278只。这个数字说明权重分布很分散,不表示模型恰好只读取了278只股票。
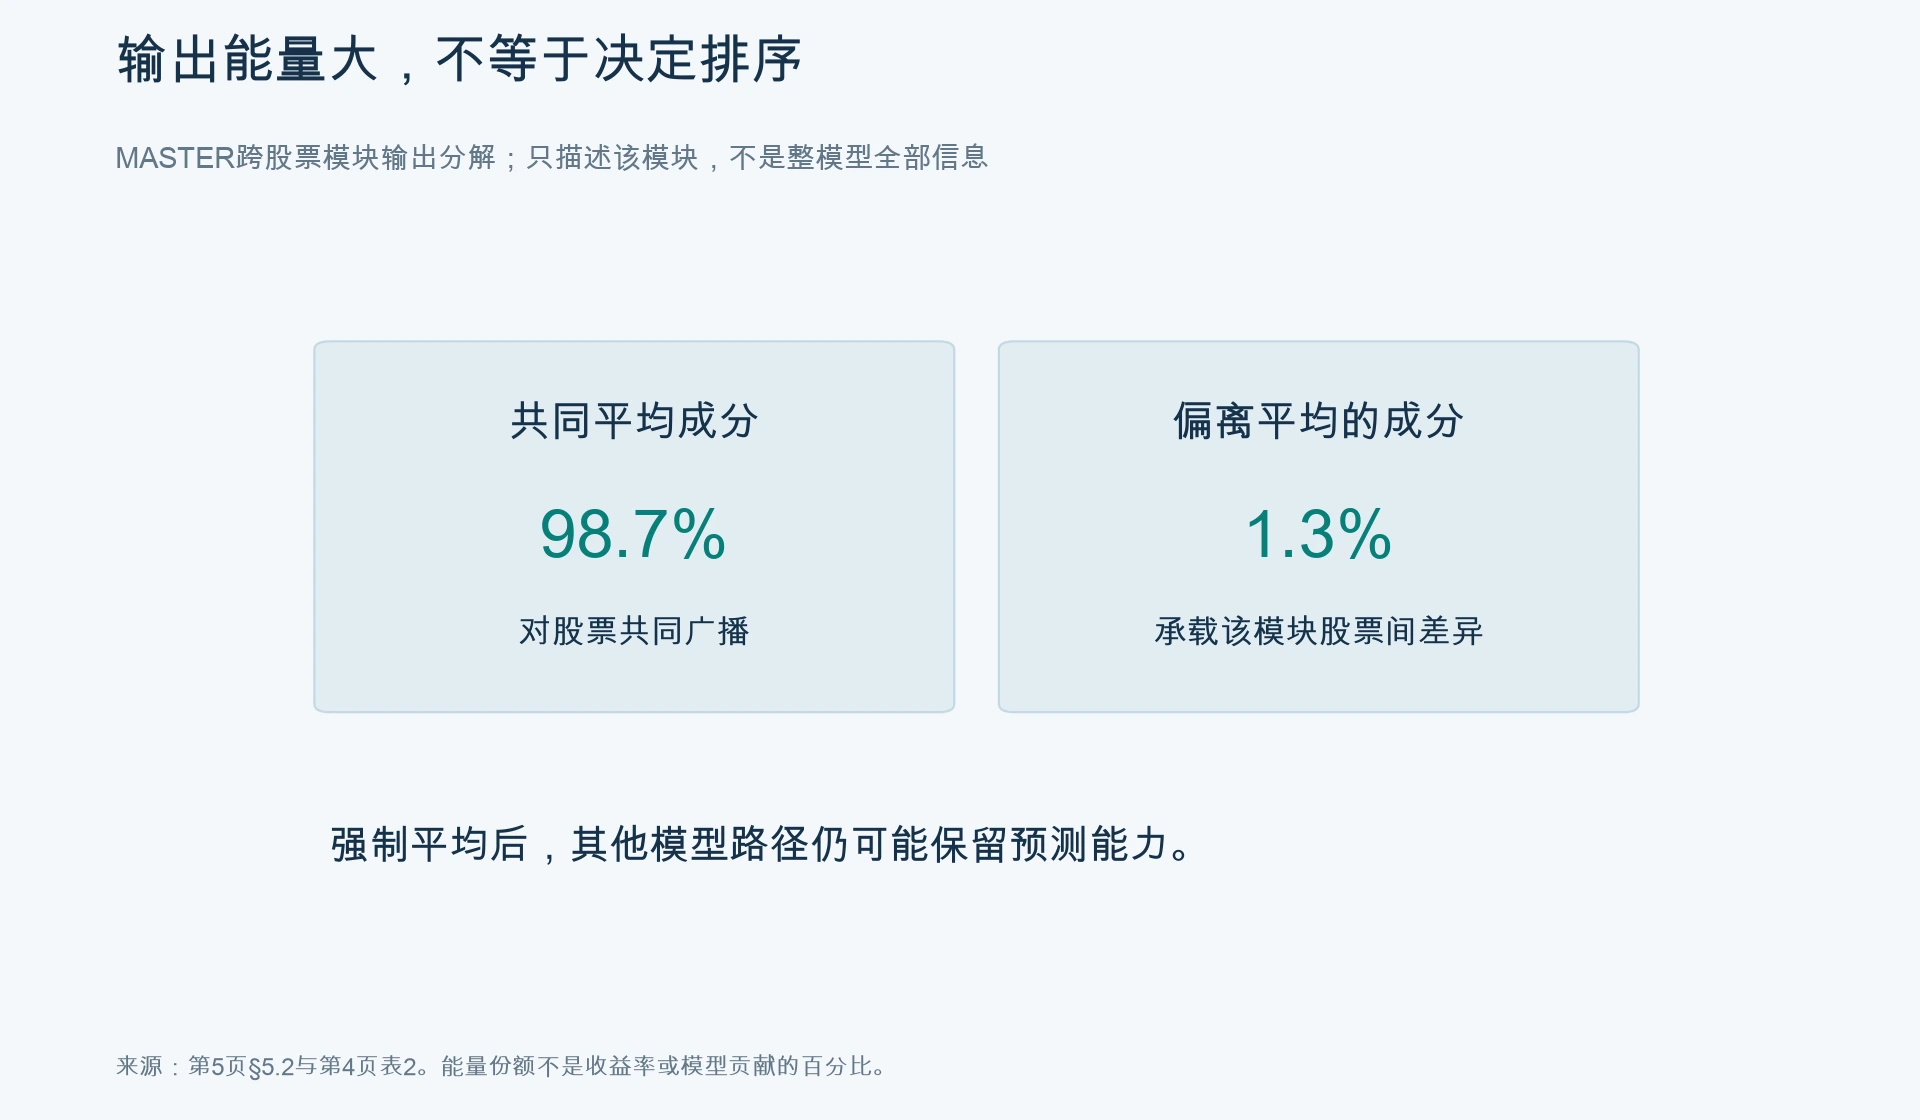
作者把该模块输出拆成两部分:大家都收到的平均信息,以及每只股票相对这个平均值的偏离。前者占98.7%的输出能量;后者只有1.3%,却承载该模块输出中的股票间差异。(第3—6页)
这里的限定很关键:强制平均会让这一模块的输出失去股票特异性,不代表整个模型的所有区分能力都归零。原文表2的UniformAttn仍有非零预测指标,其他路径依然在工作。
可以借用班级成绩理解:给每个学生都加上相同的基础分,会显著改变分数总量,却不会改变名次;决定名次的是学生之间的分差。这个类比解释“共同成分大,不代表差异成分可删”,但神经网络后续还有非线性和其他信息路径,不能把它当作模型精度的数学证明。
作者进一步观察到,偏离矩阵可用较少的主要方向近似。Nyström方法据此用少量“地标”帮助近似完整注意力,并保留随输入变化的信息分配,而非把关系固定成一张永久邻接表。
这是该模型上的实验观察。论文也发现随机初始化时存在类似低秩现象,但这不足以推出“所有softmax注意力都由数学保证低秩”,更不能保证任何市场上的32个地标都足够。
图公共平均与个股偏离,作用不能只按能量大小判断
公共平均与个股偏离,作用不能只按能量大小判断
“等价”必须带上容许差异和比较对象
主要实验用MASTER的CSI300数据和原训练流程,标签为close(t+5)/close(t+1)−1,即隔一天起算的四日未来收益。论文报告IC、Rank IC,并用多个随机种子检查模型差异。
IC看预测分值与实际收益的线性相关;Rank IC更侧重排序。一次模型替换在这两个指标上的结论可能不同。
在CSI300五个种子的比较中,完整注意力IC均值0.058、Rank IC均值0.066;32地标Nyström分别为0.059和0.066。表内“±”是跨种子标准差,不是置信区间。(第7页表3)
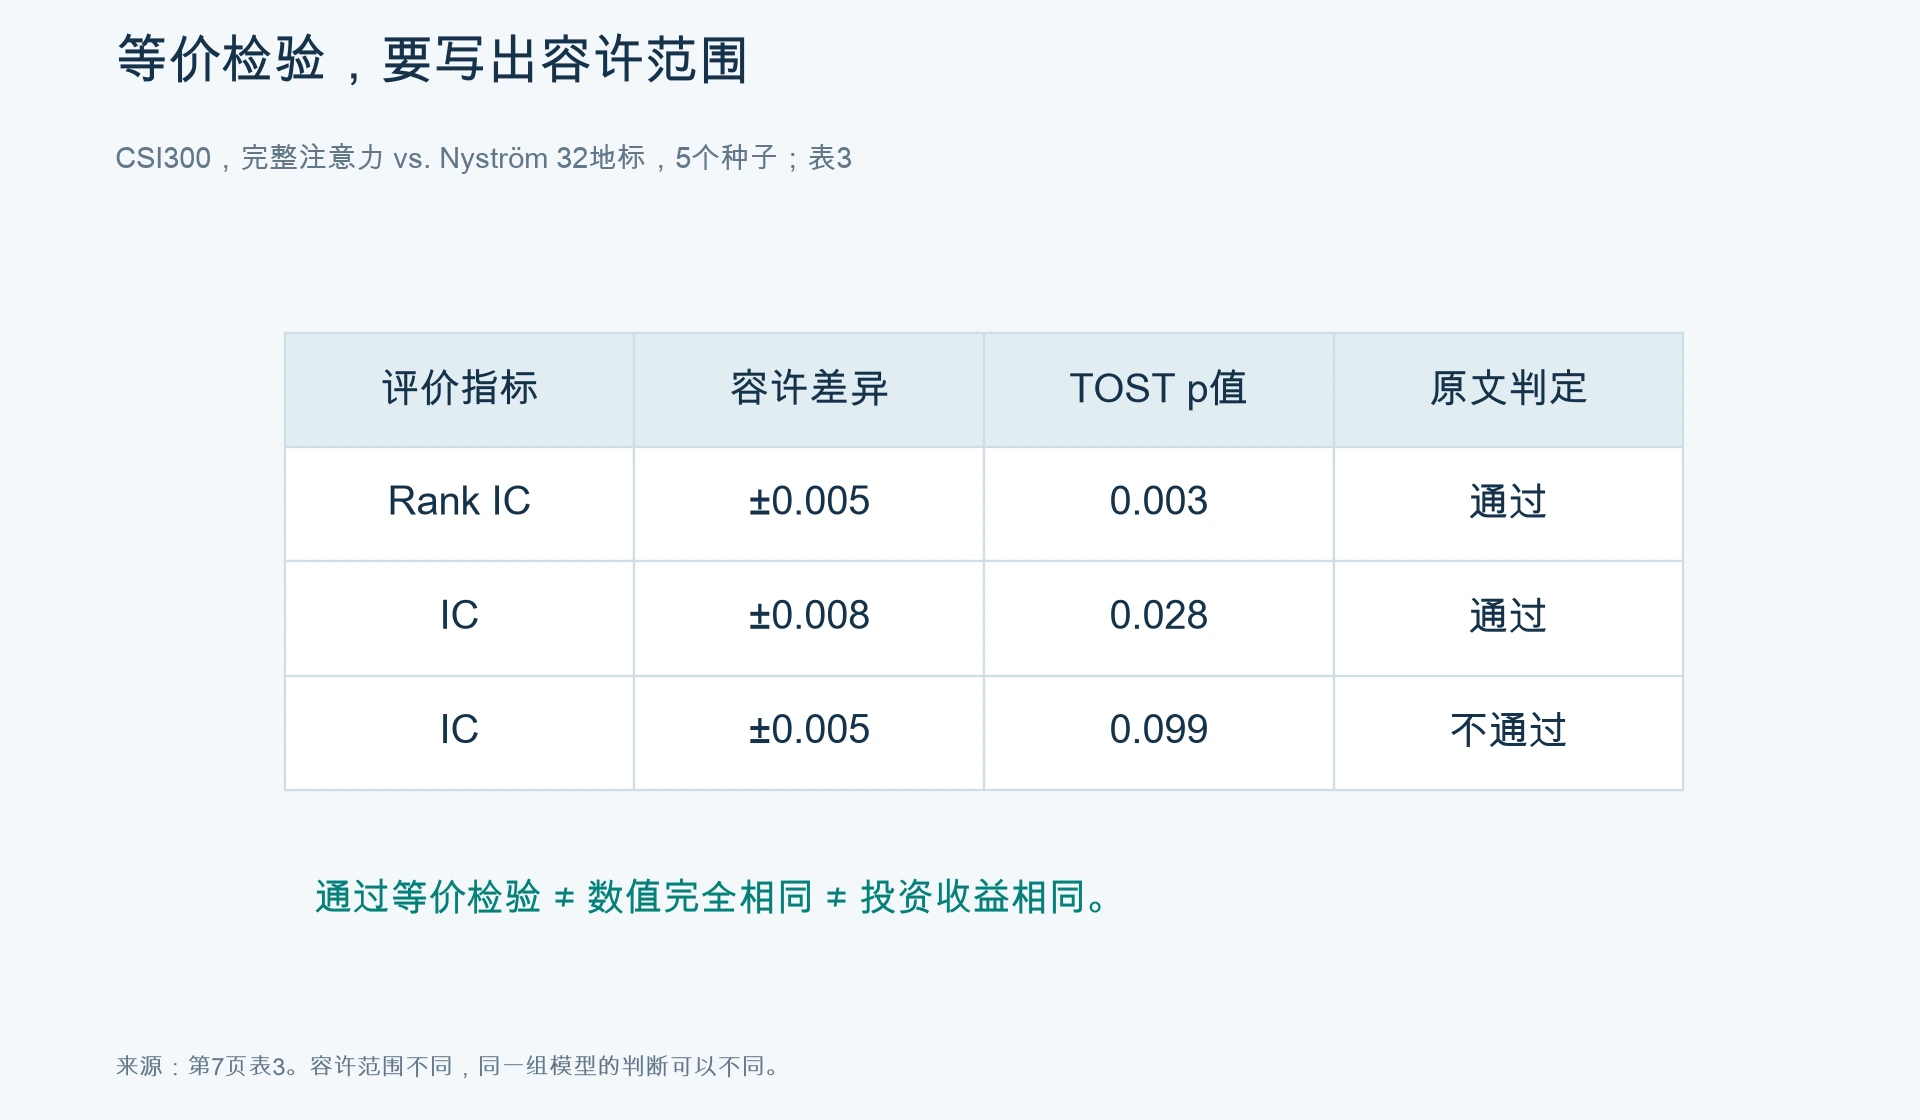
作者进一步做TOST等价检验:它检验差异能否落在给定容许范围内,而不只是“没有发现显著差异”。Rank IC在±0.005范围内通过,p=0.003;IC在更宽的±0.008范围内通过,p=0.028,但收紧到±0.005时不通过,p=0.099。
所以,不能把这组结果写成“所有预测能力完全相同”。800只股票的同架构实验增加到10个种子后,IC与Rank IC都在±0.005范围内通过等价检验,但结论仍对应那套数据、特征和训练流程。(第9页表6)
稀疏替代也要逐项看数值。原文倾向把稀疏化描述为失败,但表4的TopK方法Rank IC为0.064,完整注意力为0.066,二者并非原始分值相差一半;TopK的IC为0.052,对照完整注意力0.058。本文不沿用原文“至多保留50%”的笼统表述,按表中指标分别报告,也不为没有给出的等价检验补结论。
图同一组模型,在不同指标与容许范围下结论不同
同一组模型,在不同指标与容许范围下结论不同
复杂度下降,小规模计算却更慢
完整注意力的核心计算随股票数N大致按平方增长,32地标近似的对应计算大致按32N增长。这描述规模变化趋势,不能代替墙上时钟测量。
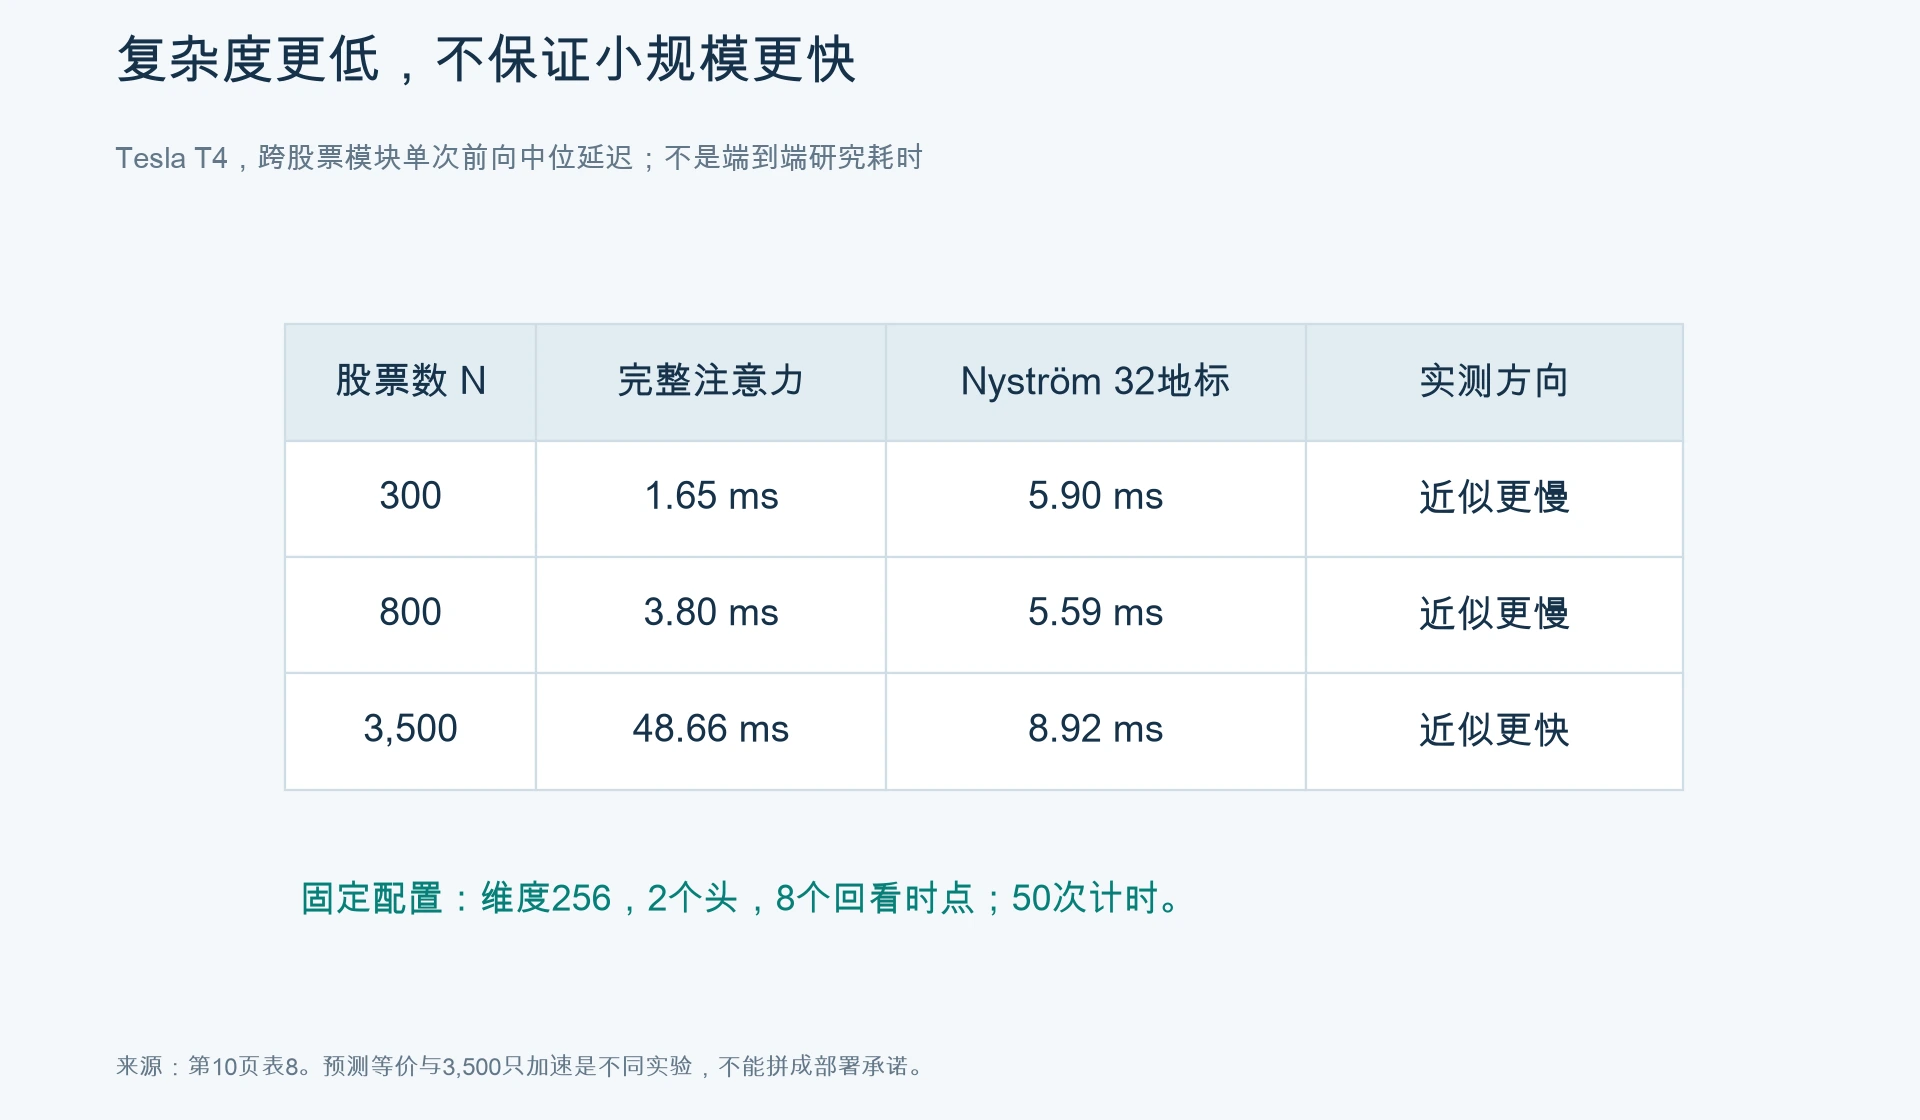
论文在Tesla T4上单独测试跨股票模块前向,配置为表示维度256、2个头、8个回看时点,预热10次后计时50次,报告中位延迟。(第10页表8)
300只股票时,完整注意力1.65毫秒,Nyström 5.90毫秒;800只时分别3.80与5.59毫秒。近似算法要付出伪逆迭代等固定开销,在这些规模上还没有摊薄。
到3,500只时,前向延迟变成48.66与8.92毫秒,表内约5.5倍加速,峰值显存从1,350MB降到298MB。论文估计这套硬件配置的延迟交叉点约在1,300只附近,不能当作其他设备的通用阈值。
这不是完整研究流水线的端到端速度。数据准备、其他模型层、排序和交易系统都不在这张计时表里。作者还报告Nyström每轮训练约慢两倍;如果你的成本主要来自反复训练,不能只拿前向加速宣传总成本下降。(第11页)
更不能把两组结果拼接成“3,500只股票上已证明同等精度且加速5.5倍”。大规模预测实验改了特征和架构,计算基准则使用单独模块配置,它们不是同一项等价性与部署实验。
图同一模块的前向实测,小规模与大规模方向不同
同一模块的前向实测,小规模与大规模方向不同
预处理一改,原有结论就需要重验
论文后半部分保留了一项很有价值的反向结果。
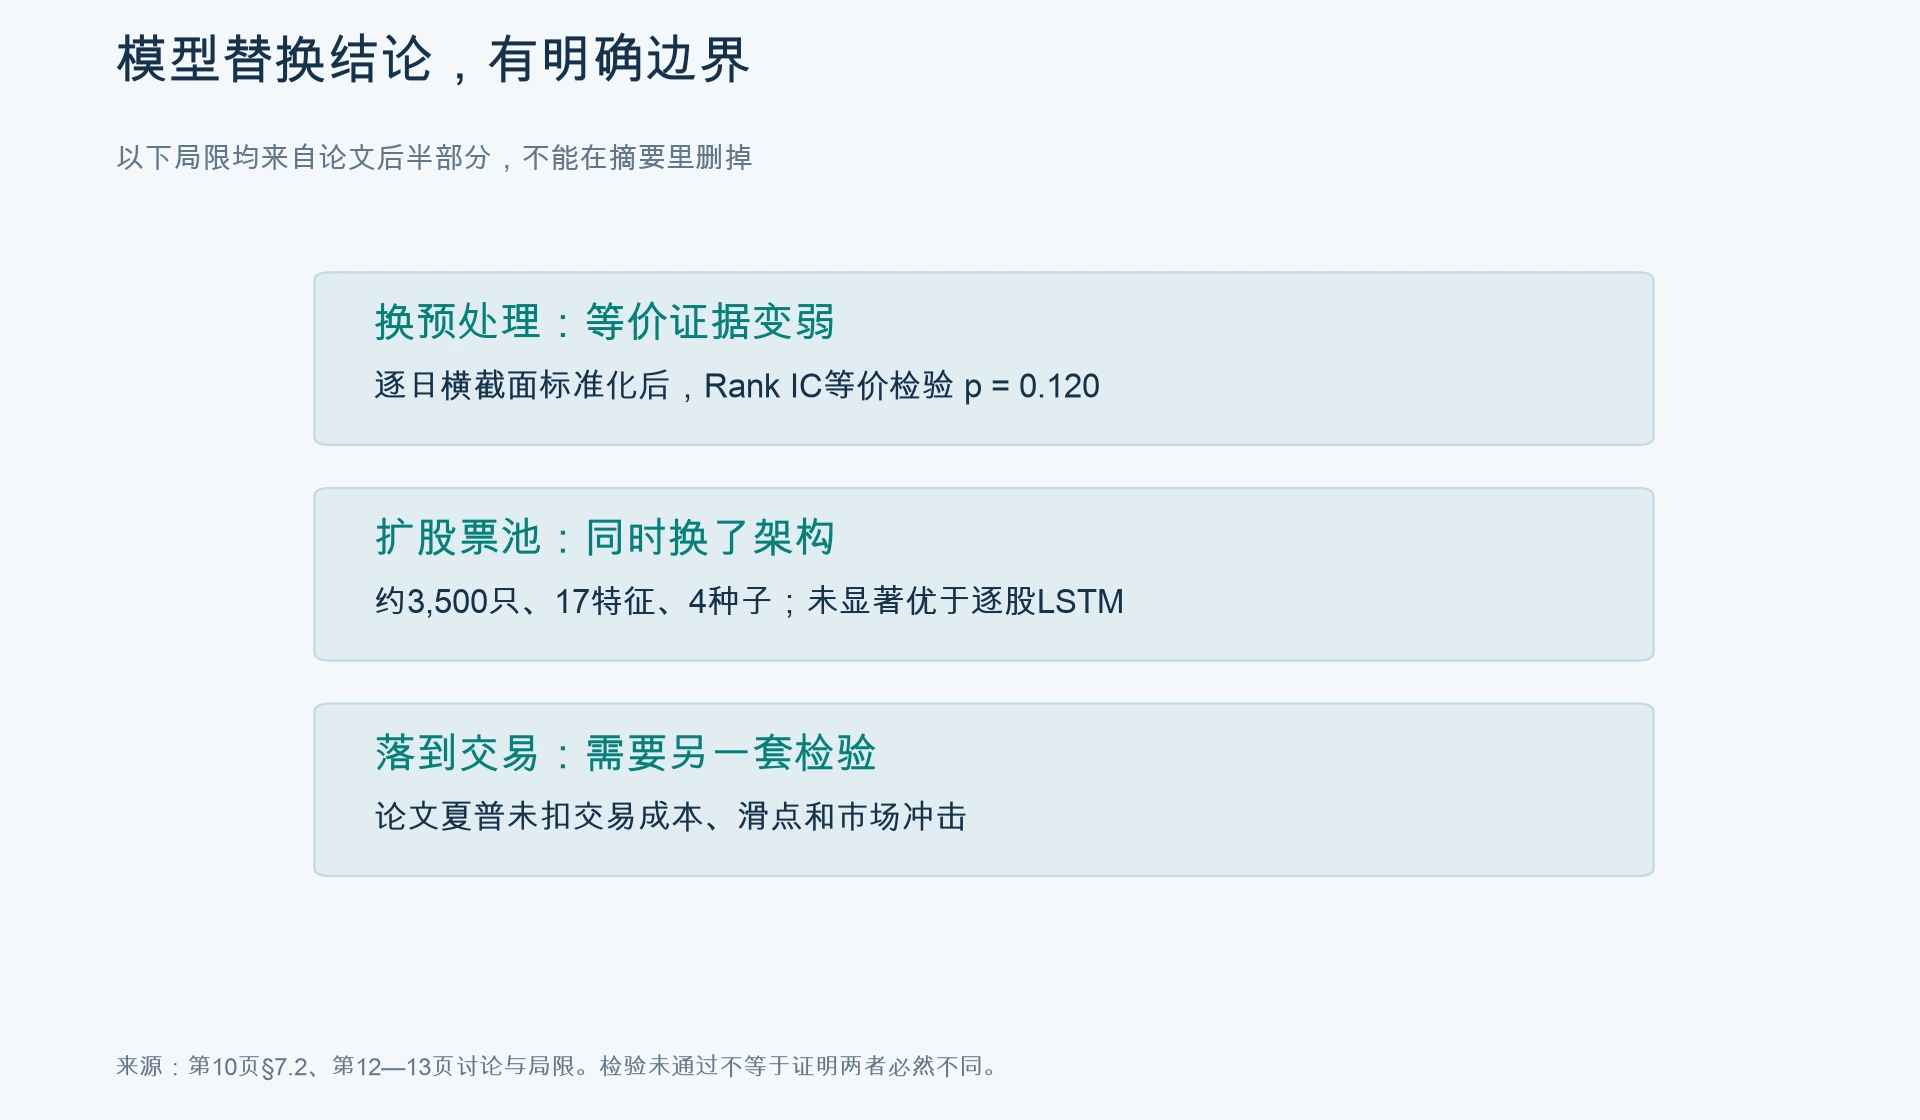
改用逐日横截面z-score等更充分的特征标准化后,完整注意力的IC提高约0.005,Nyström的IC没有相应改善;Rank IC等价检验的p值由0.003变成0.120,原先的等价证据变弱。(第13页)
p值0.120不证明两者一定不同,但意味着不能继续沿用原设定下“已通过等价”的判断。预处理是模型比较条件的一部分,不是可以在报告外随意替换的小步骤。
约3,500只股票的预测实验则使用17个OHLCV衍生特征、较小表示维度,并移除了市场门控。这与CSI300原架构不是单纯把N放大。四个种子的结果中,跨股票模块没有在IC或Rank IC上显著优于逐股票LSTM基线;检验能力也受重复次数限制。(第10页表7)
此外,论文给出的夏普比率没有交易成本、滑点和市场冲击,不能据此推断可获得的实盘收益。低秩结构是否出现在其他模型和市场,作者也明确留作进一步验证。
图替换结论的三道边界:预处理、架构与交易成本
替换结论的三道边界:预处理、架构与交易成本
把模型替换写成一份有条件的验收
从这个案例延伸到日常研究,一个可执行的做法是先固定数据版本、标签、预处理和训练预算,用多个种子比较预测差异;等价检验同时写出指标和容许范围。随后在自己的硬件与股票池规模上测训练、推理、峰值内存和端到端耗时。
如果预处理、架构或股票池变了,重新验收;如果最终目的是组合交易,再加入持仓约束、换手与成本。这些是本文的研究检查建议,不是论文已经验证过的通用部署标准。
这篇研究支持的是一个有条件的判断:某些股票预测设定中的动态注意力可以压缩,但压缩是否有工程价值,还取决于你在哪个规模、哪套预处理和哪条执行流程里使用它。保留这些条件,比记住“32个地标”更有用。
原文:Kunhan Guo,Nyström Attention Matches Full Attention for Cross-Sectional Stock Prediction,arXiv:2609.08106v1,2026年9月8日。依据完整本地14页论文,重点核对第7、9—13页与表3—8。公开原文:https://arxiv.org/abs/2609.08106 。本文未独立运行作者代码;对原文过强措辞与表格口径的差异已在正文说明。
本文由AI辅助整理与制图,保留原研究条件和局限,仅供学习与方法交流,不构成投资建议。预测相关性与历史模拟表现不代表未来投资收益。
资料与阅读边界
本文为方法讨论与教学说明。文中示例不等于经独立验证的收益实证;如需具体数据、计算口径或资料来源,可通过官方渠道提出核对请求。
历史结果不代表未来表现。使用前请检查数据时间边界、样本独立性、交易成本及适用条件。
关键结论
- 预测等价必须保留指标、容许范围、种子数与预处理条件。
- 复杂度降低不代表小规模或端到端速度一定改善。
- 大规模计算基准与改架构预测实验不可拼成部署承诺。