研究方法大模型量化信息泄漏回测验证
AI交易的高收益,藏着历史答案?
解读Profit Mirage:从时间切分、输入扰动与历史问答识别大模型交易回测的记忆依赖,并说明实验边界。
本文要点
模型参数也可能携带测试期历史事实。
预测一致率是排查线索,不能单独等同泄漏概率。
把2022年的新闻交给今天的大模型,请它判断第二天该不该买入,一份漂亮的回测就可能出现。问题是,模型在训练时,可能已经读过后来发生的事。
传统回测会排查行情和财报里的未来信息。接入大模型以后,还需要审查一条更隐蔽的路径:未来事实可能已经进入模型参数。输入文件只截到交易当天,并不意味着整个系统只知道当天的信息。
Xiangyu Li等人在2025年10月提交的预印本《Profit Mirage: Revisiting Information Leakage in LLM-based Financial Agents》中,把这个问题称为“利润幻象”。下面的数据均为作者报告的实验结果,解读基于本地保存的arXiv v1全文,未独立复现实验。
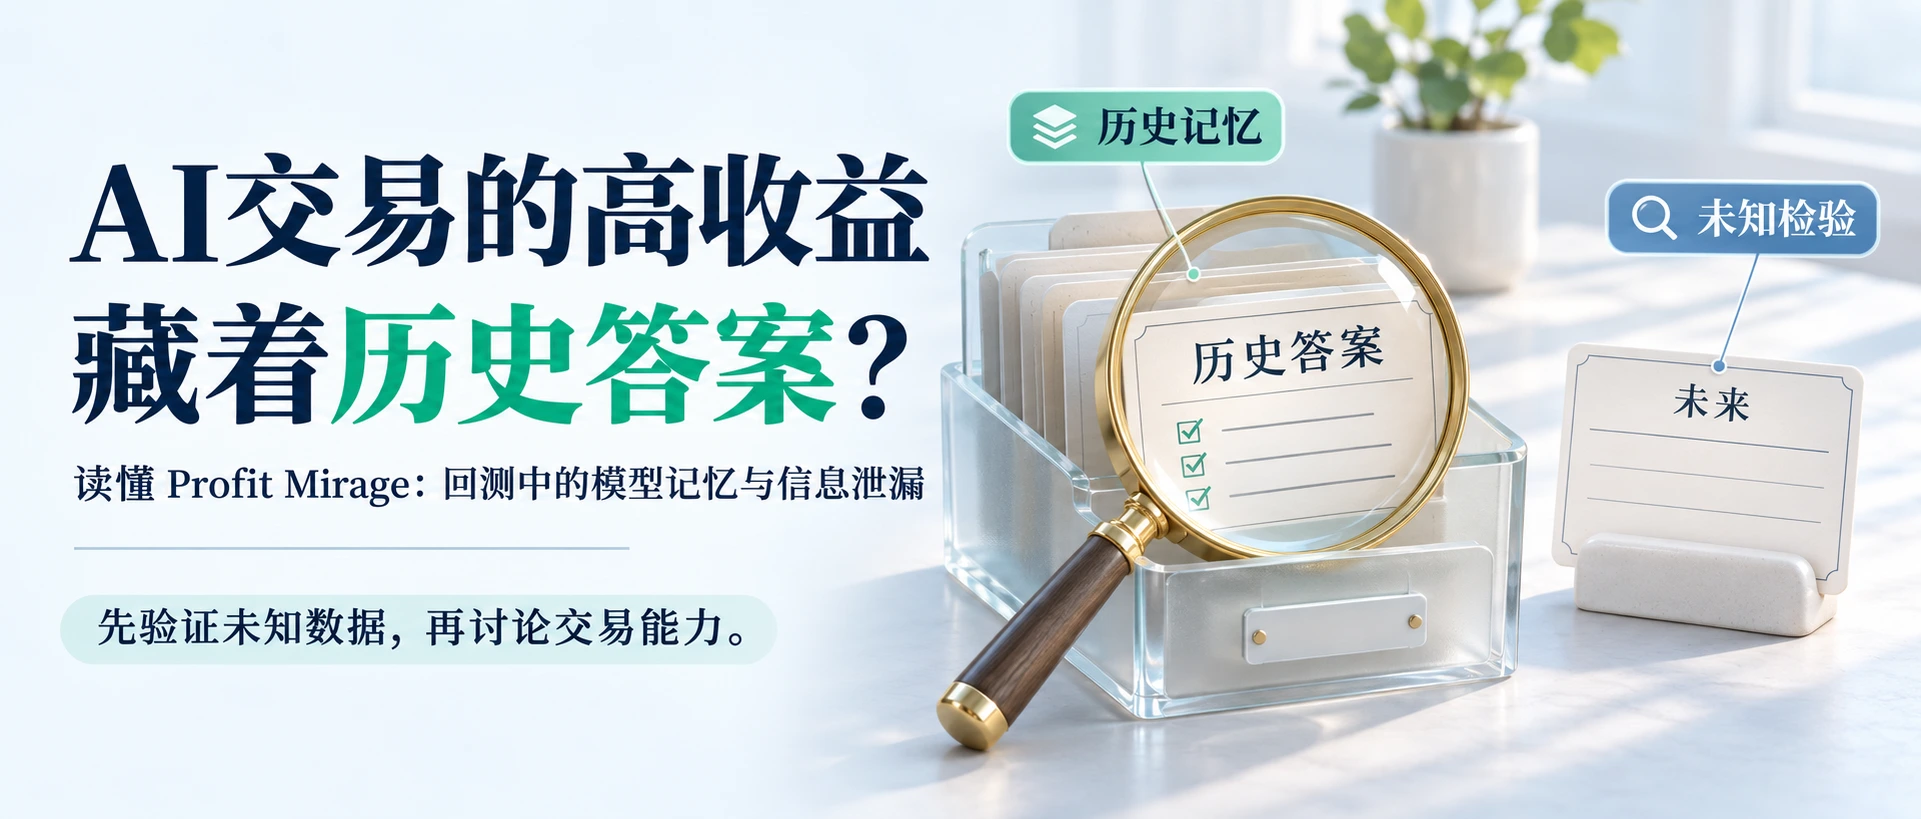
图图1
AI交易回测中的历史记忆与未知检验
时间切开以后,收益发生了什么
作者用GPT-4o作为五种金融代理的底层模型,比较2021年第二、三季度和2024年第三、四季度两个区间。论文称,两个区间的市场收益分别为13.79%和13.35%,希望借此降低市场方向不同造成的干扰。(原文第2页,§2.1)
在这个设置下,五种方法的总收益相对衰减幅度为50.18%至71.85%,夏普比率的相对衰减幅度为51.48%至62.23%。这些是指标相对于前一区间的变化比例,不是账户亏损了相应百分比,也不是收益率下降了相应百分点。
它提醒我们:历史区间的表现,可能混入了模型对历史的熟悉程度。不过,两个区间的市场总收益接近,并不能保证波动、行业结构、新闻环境和交易机会也相同。跨时期表现下降值得调查,尚不足以把全部差异都归因于预训练信息泄漏。
对研究者更实用的做法,是把模型版本、知识截止说明和测试时间一起记下来,并保留模型及研究流程未接触过的后续数据。只给一条收益曲线,读者很难判断策略究竟经历了怎样的考试。
改了题目,它还在回答原来的答案吗
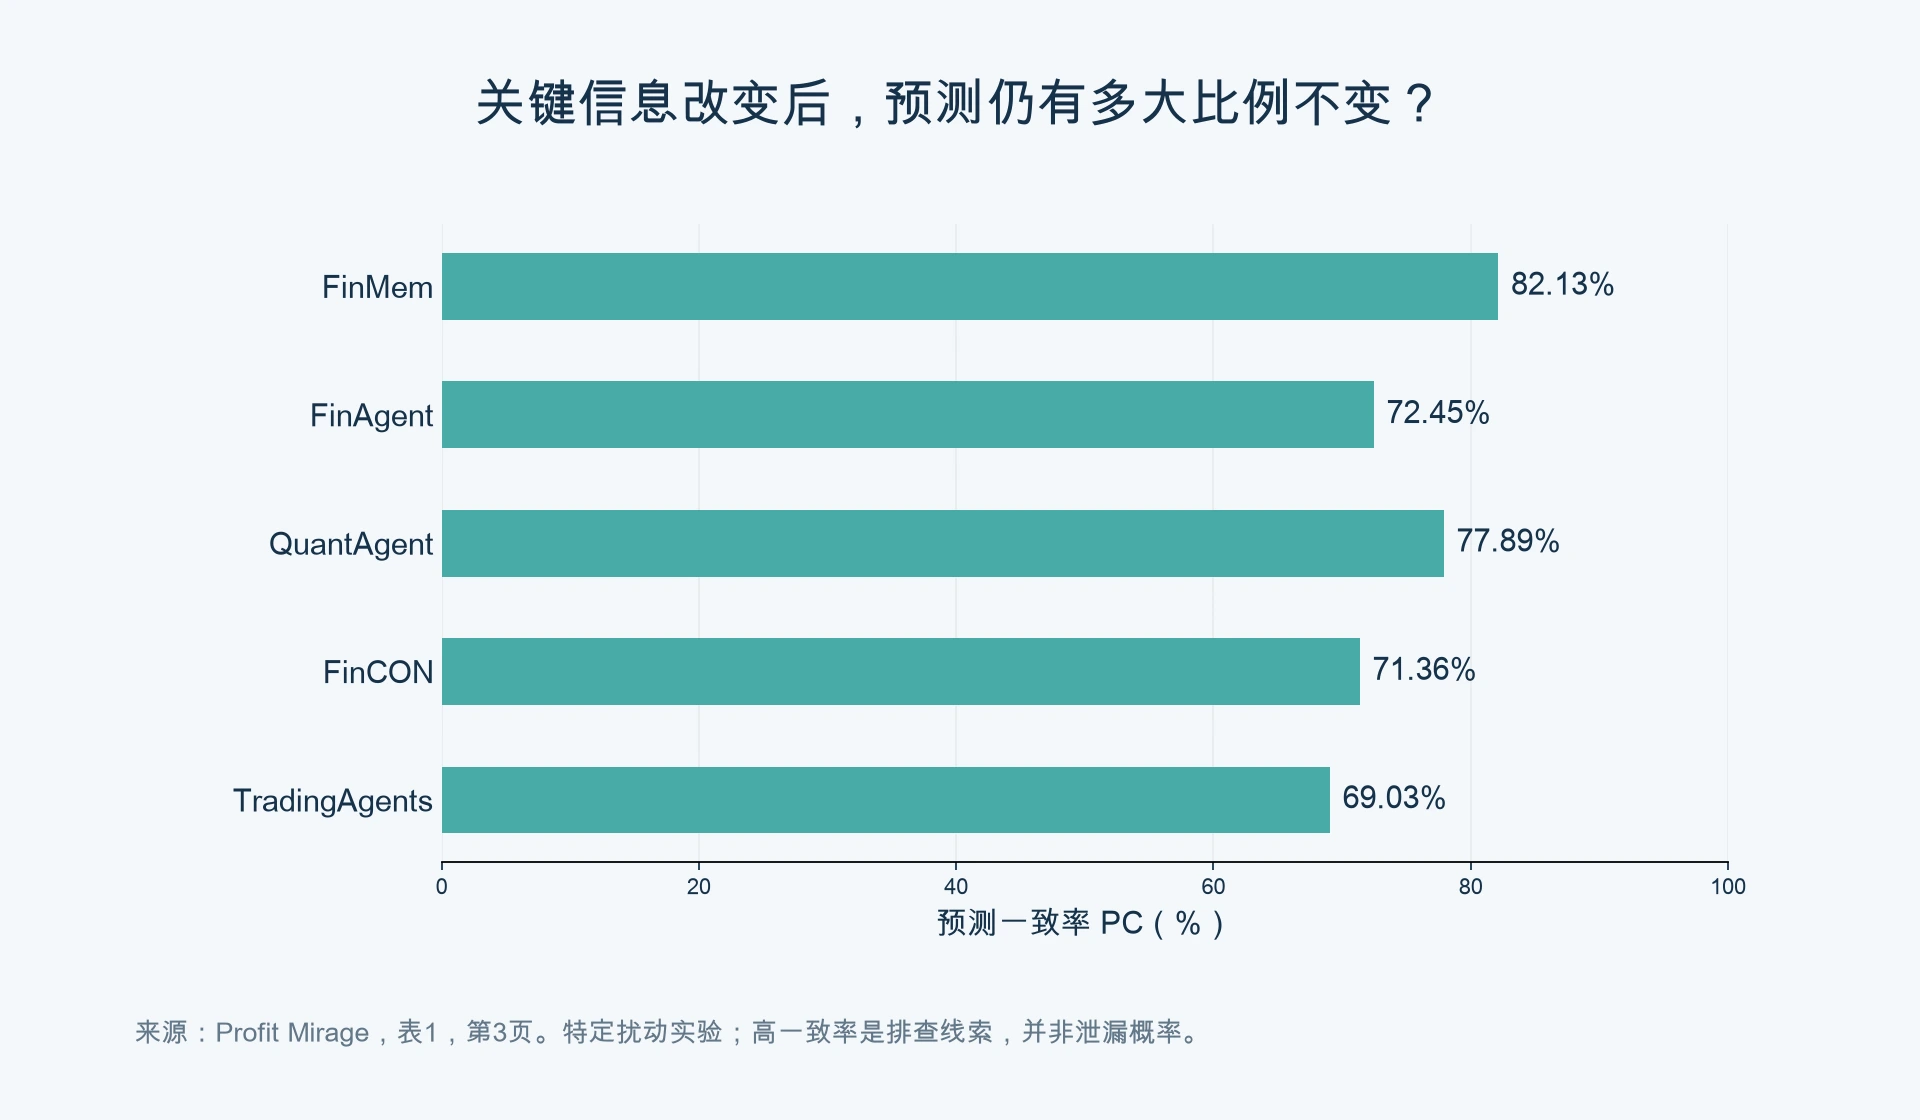
第二组实验改变模型看到的信息:修改新闻事件,替换价格序列,或调整技术指标与基本面因素。作者在10只股票、每只30个关键时点上比较原始情境与扰动情境的预测。(原文第2—3页,§2.2、表1)
FinMem有82.13%的预测在扰动后保持不变;TradingAgents为69.03%。这里的预测一致率PC,统计的是两种情境下答案相同的比例。82.13%不能被解释为“82.13%的交易存在泄漏”。
这个测试的直觉很直接:如果影响决策的重要信息已经变了,系统却几乎不调整判断,就应当检查它有没有真正使用输入。
仍需多问一步:被改变的信息,在该策略里本来就该影响动作吗?一个长期持有策略,面对不重要的短期新闻保持不动,可能完全合理。扰动如果破坏了市场变量之间的关系,也可能把模型推到不自然的情境里。高一致率是排查线索,不能单独当作污染鉴定结果。
图图2
关键信息扰动后的预测一致率
历史问答高分,证明的是哪一种能力
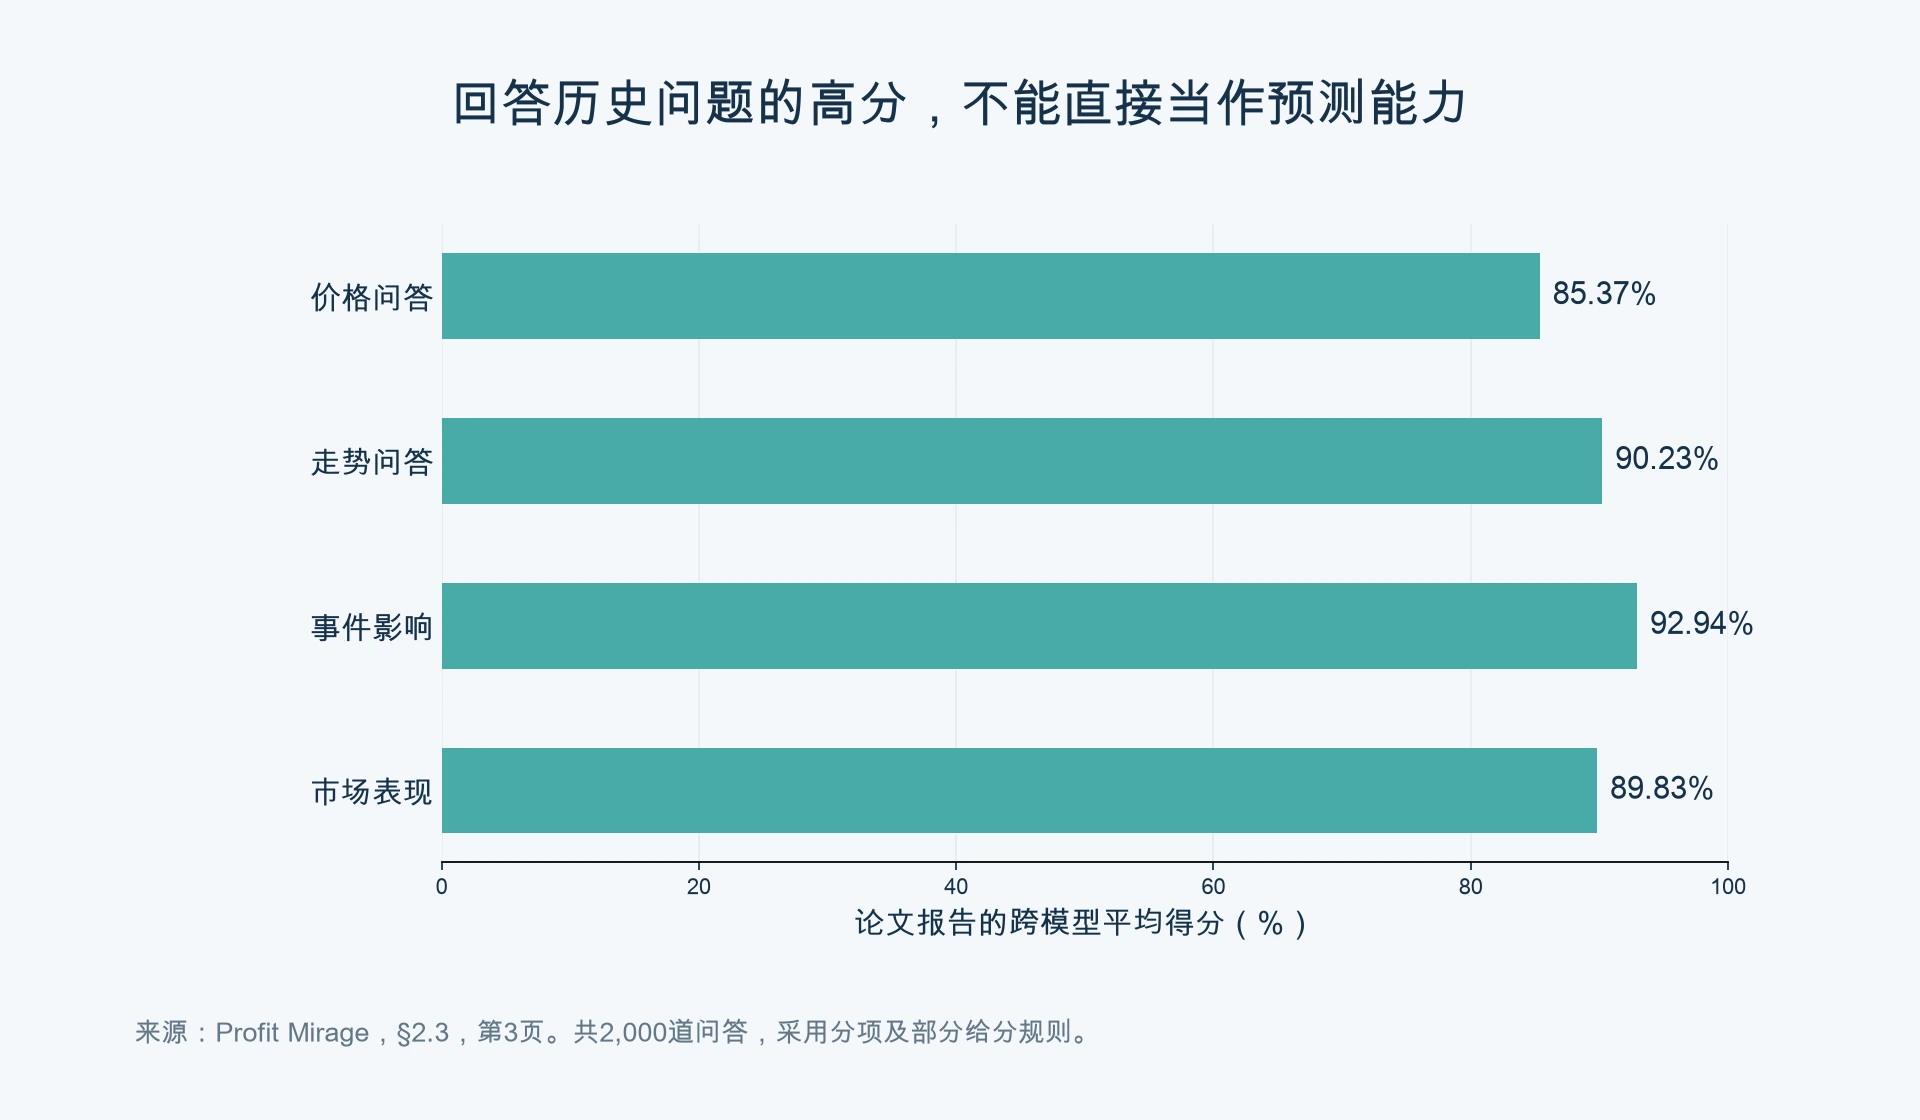
作者还构造了2,000道历史金融问答,覆盖价格、走势、事件影响和市场表现。论文报告的跨模型平均得分,从价格问答的85.37%到事件影响的92.94%不等。(原文第3页,§2.3、图2)
这组结果说明,模型可以回答不少过去发生的金融事实。但按原文评分规则,一些题允许误差范围或部分给分,因此图中的得分不能理解成每个问题都被精确答对的比例。
更关键的区别是任务发生的时间。今天回答“某只股票过去四周涨了多少”,属于历史知识;在那四周开始前作出可执行决策,才属于当时的预测。把两者放在同一张成绩单里,容易把记忆能力当作交易能力。
可以把它类比成考试:做过原题的高分,混合了理解和答案记忆。这个类比到金融市场会遇到边界——新时期还会发生市场分布变化,所以新题考差,不能全怪旧题背得太熟。
图图3
历史问答的平均得分
微调改善历史成绩,也需要独立验收
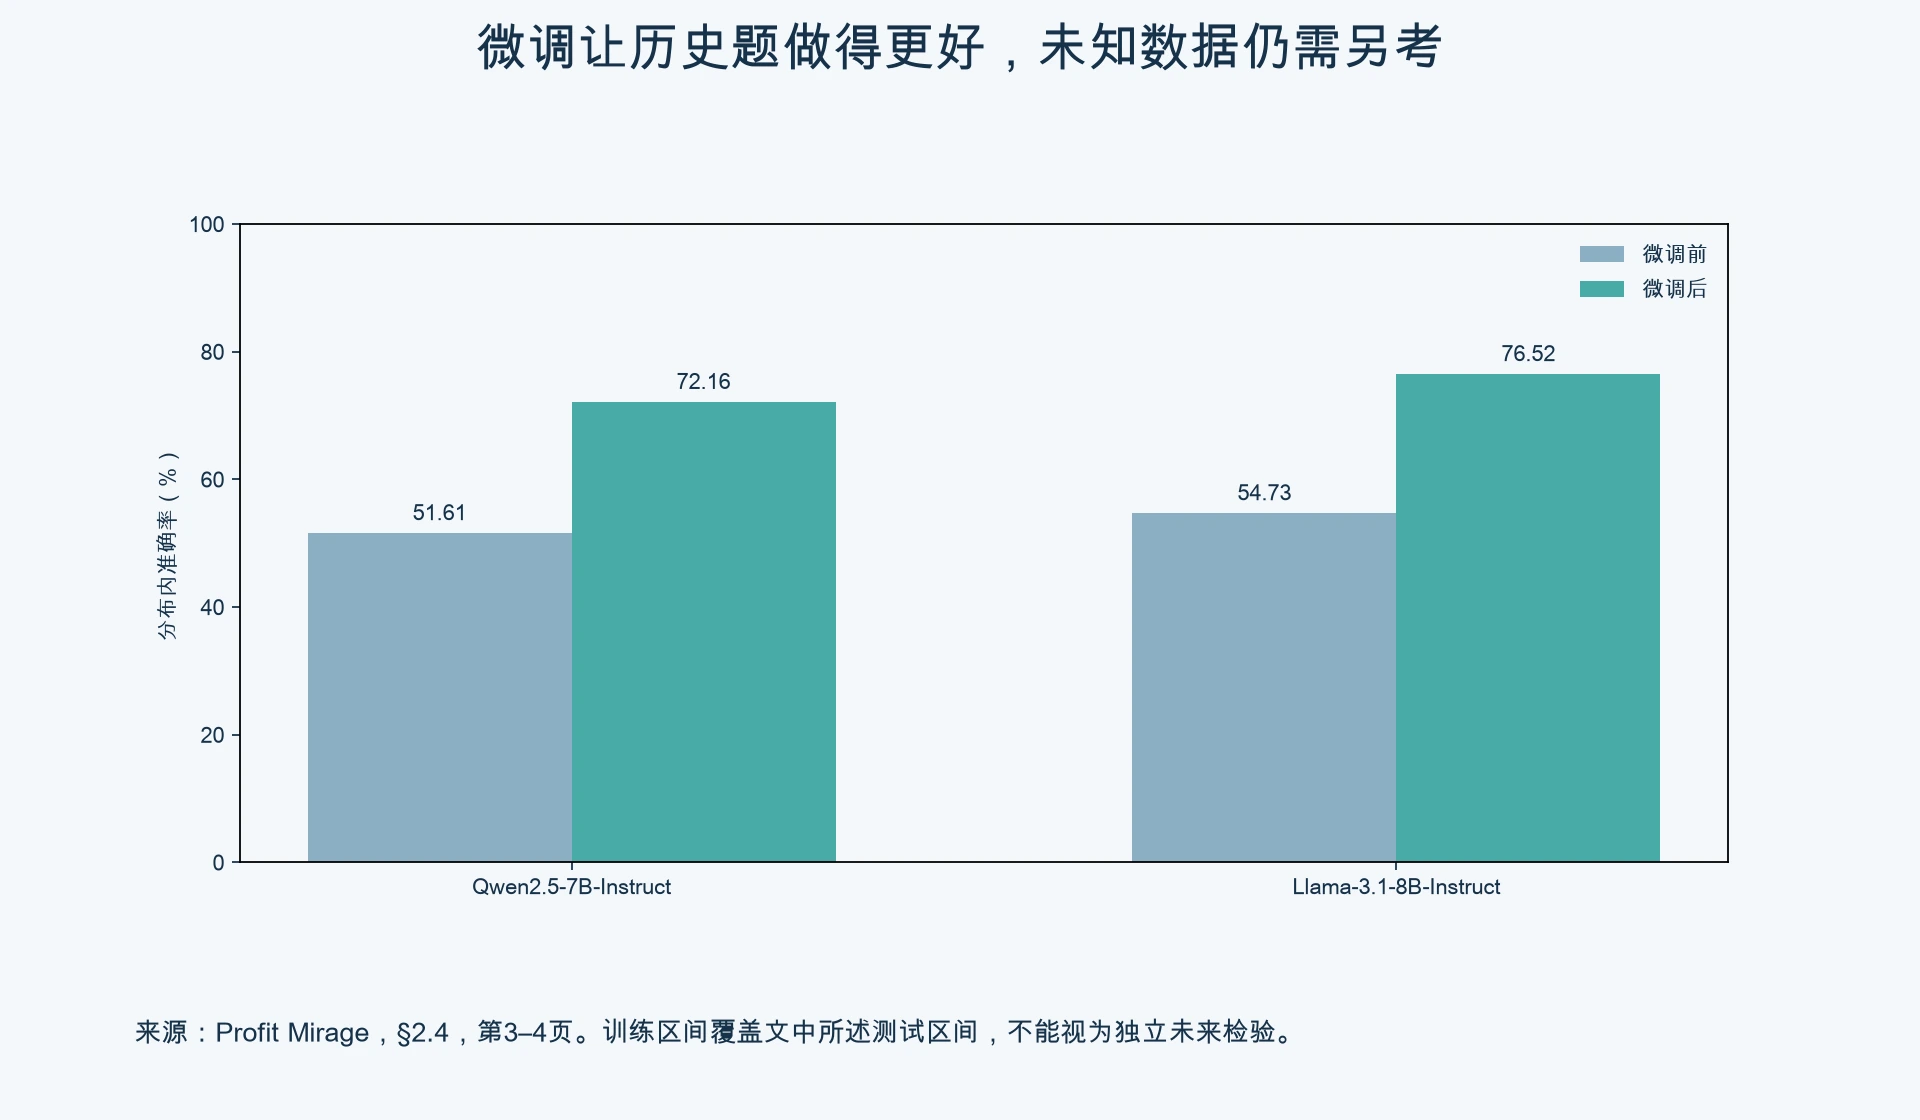
论文的微调实验中,Qwen2.5-7B-Instruct的分布内准确率从51.61%升至72.16%;Llama-3.1-8B-Instruct从54.73%升至76.52%。作者同时报告,未知数据上的准确率出现相对下降。(原文第3—4页,§2.4)
这里有一个不能略过的实验细节:文中写明,微调数据覆盖2020年1月至2022年12月,而所述测试集来自2022年1月至6月。时间区间存在重叠。因此,分布内成绩提高,不能充当严格的未来样本外检验。
对于要落地的系统,微调数据、提示词示例、检索库、代理记忆和策略搜索记录,都值得纳入时间审查。尤其是不断看测试集、不断修改提示词的过程,即使没有重新训练模型,也可能让研究选择逐渐适配那一段历史。
图图4
微调前后的分布内准确率
FactFin给出的方向,以及仍需补上的证据
作者提出FactFin,让大模型更多生成可执行的策略代码,再结合检索增强、蒙特卡洛树搜索和反事实模拟进行迭代。其思路是把“直接猜这次涨跌”,转成“提出能接受输入变化检验的规则”。(原文第5—6页,§3)
这条思路值得借鉴,但不能据此宣称泄漏已经被消除。生成代码同样可能带入历史知识,反复搜索策略也可能过拟合评估数据。
阅读收益结果时还要保留原文中的疑点。例如,表3对部分最大回撤的符号处理不一致;正文部分收益叙述与表格数字也有出入。论文提到标准交易成本和滑点模型,但相关说明不足以让读者仅凭正文重建完整执行条件。因此,本文不把这些收益数字用作策略推荐,也不把作者的模拟结果延伸成实盘能力证明。
评估一套AI交易系统,可以从哪里开始
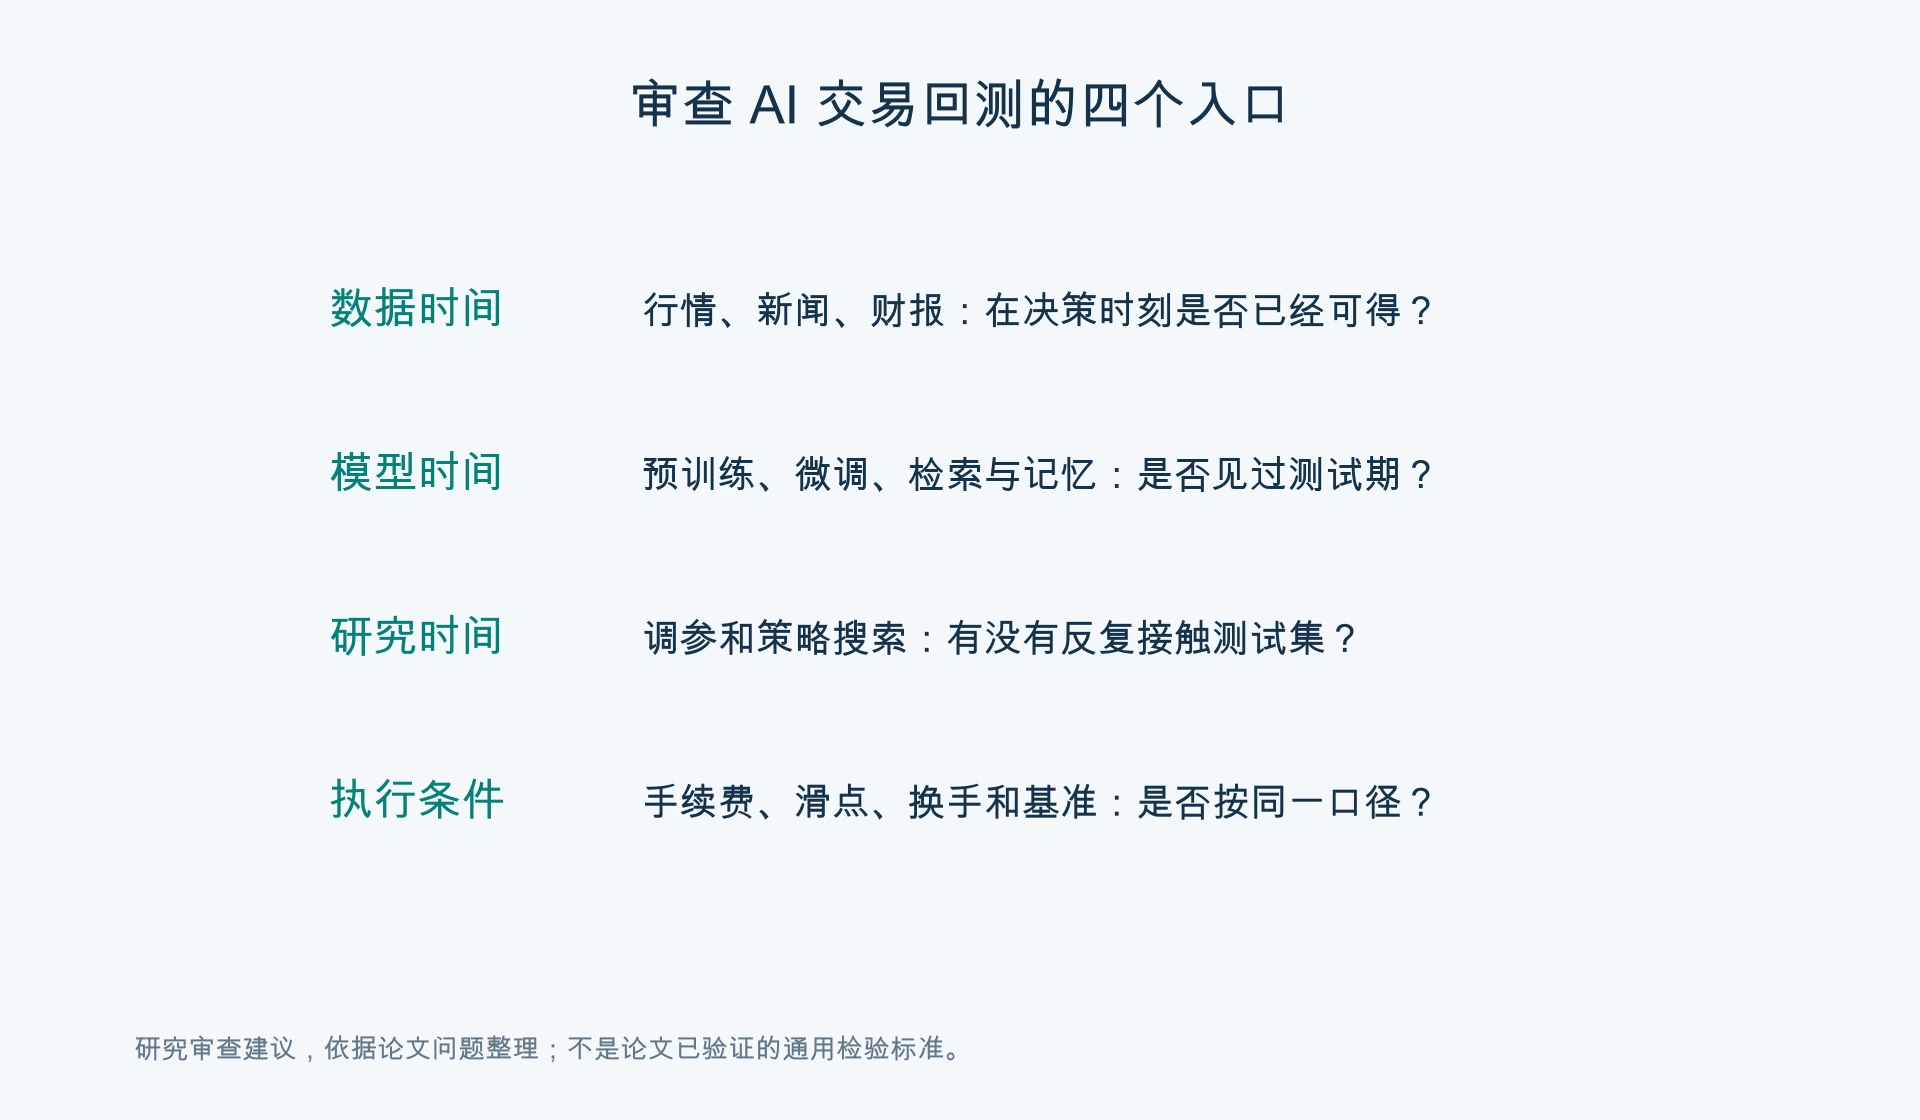
先核对信息时间:行情、财报和新闻在决策时刻是否已经可得,模型和检索库又可能知道什么。然后固定研究流程,把策略搜索和调参留在训练及验证阶段,为最后一次评估保留独立区间。
再检查输入依赖:对确实应该影响策略的信息作合理改变,观察输出和理由是否随之变化。结果需要结合策略机制解释,不能把“变得越多”当成统一的好成绩。
最后回到执行条件。手续费、滑点、换手、风险暴露和买入持有基准,都应当采用可比较的口径。模型能解释历史,不等于它能在未知市场里承担真实资金的决策。
一份可信的回测,需要交代系统当时能知道什么,以及哪些结果是在流程固定以后才第一次看到的。对大模型金融代理,这两项记录往往比一条漂亮的净值曲线更有判断价值。
原文:Xiangyu Li、Yawen Zeng、Xiaofen Xing、Jin Xu、Xiangmin Xu,Profit Mirage: Revisiting Information Leakage in LLM-based Financial Agents,arXiv:2510.07920v1,2025-10-09。https://arxiv.org/abs/2510.07920
本文由AI辅助整理与制图,依据原文核对主要数字,未独立复现实验。内容用于论文与研究方法交流,不构成投资建议。图中数据为论文报告值,审查示意图为本文整理。
图图5
审查AI交易回测的四个入口
资料与阅读边界
本文为方法讨论与教学说明。文中示例不等于经独立验证的收益实证;如需具体数据、计算口径或资料来源,可通过官方渠道提出核对请求。
历史结果不代表未来表现。使用前请检查数据时间边界、样本独立性、交易成本及适用条件。
关键结论
- 模型参数也可能携带测试期历史事实。
- 预测一致率是排查线索,不能单独等同泄漏概率。
- 独立未来数据、固定研究流程和执行成本应一起审查。