科学评估因子挖掘LLM样本外检验研究审计
别急着删除高相关因子:先看它给组合留下了什么
高相关不必然等于冗余,单因子IC很低也不必然没有组合价值。结合KDD 2023论文的对照实验与具体案例,讨论因子入池应怎样评价边际贡献,以及这种做法的适用边界。
因子库越来越大,筛选规则往往也越来越直接:先按单因子IC排序,再删除相互相关性过高的候选。这样能控制规模,却可能顺手删掉对现有组合有用的信息。
2023年发表于KDD的《Generating Synergistic Formulaic Alpha Collections via Reinforcement Learning》,把研究目标从“找到单独表现好的因子”移到了“找到能一起工作的因子集合”。论文的公开实现名为AlphaGen。它采用强化学习生成公式,但更值得讨论的,是如何给新候选打分。
原文并没有证明高相关因子通常更好,也没有证明降低相关性没有意义。它给出了更具体的反例:相似信号的差异部分可能有用;一个单独预测能力很弱的因子,也可能改善已有组合。是否保留,应回到固定组合与样本外评价中判断。
图封面
封面
先看一个被相关性门槛拦住的例子
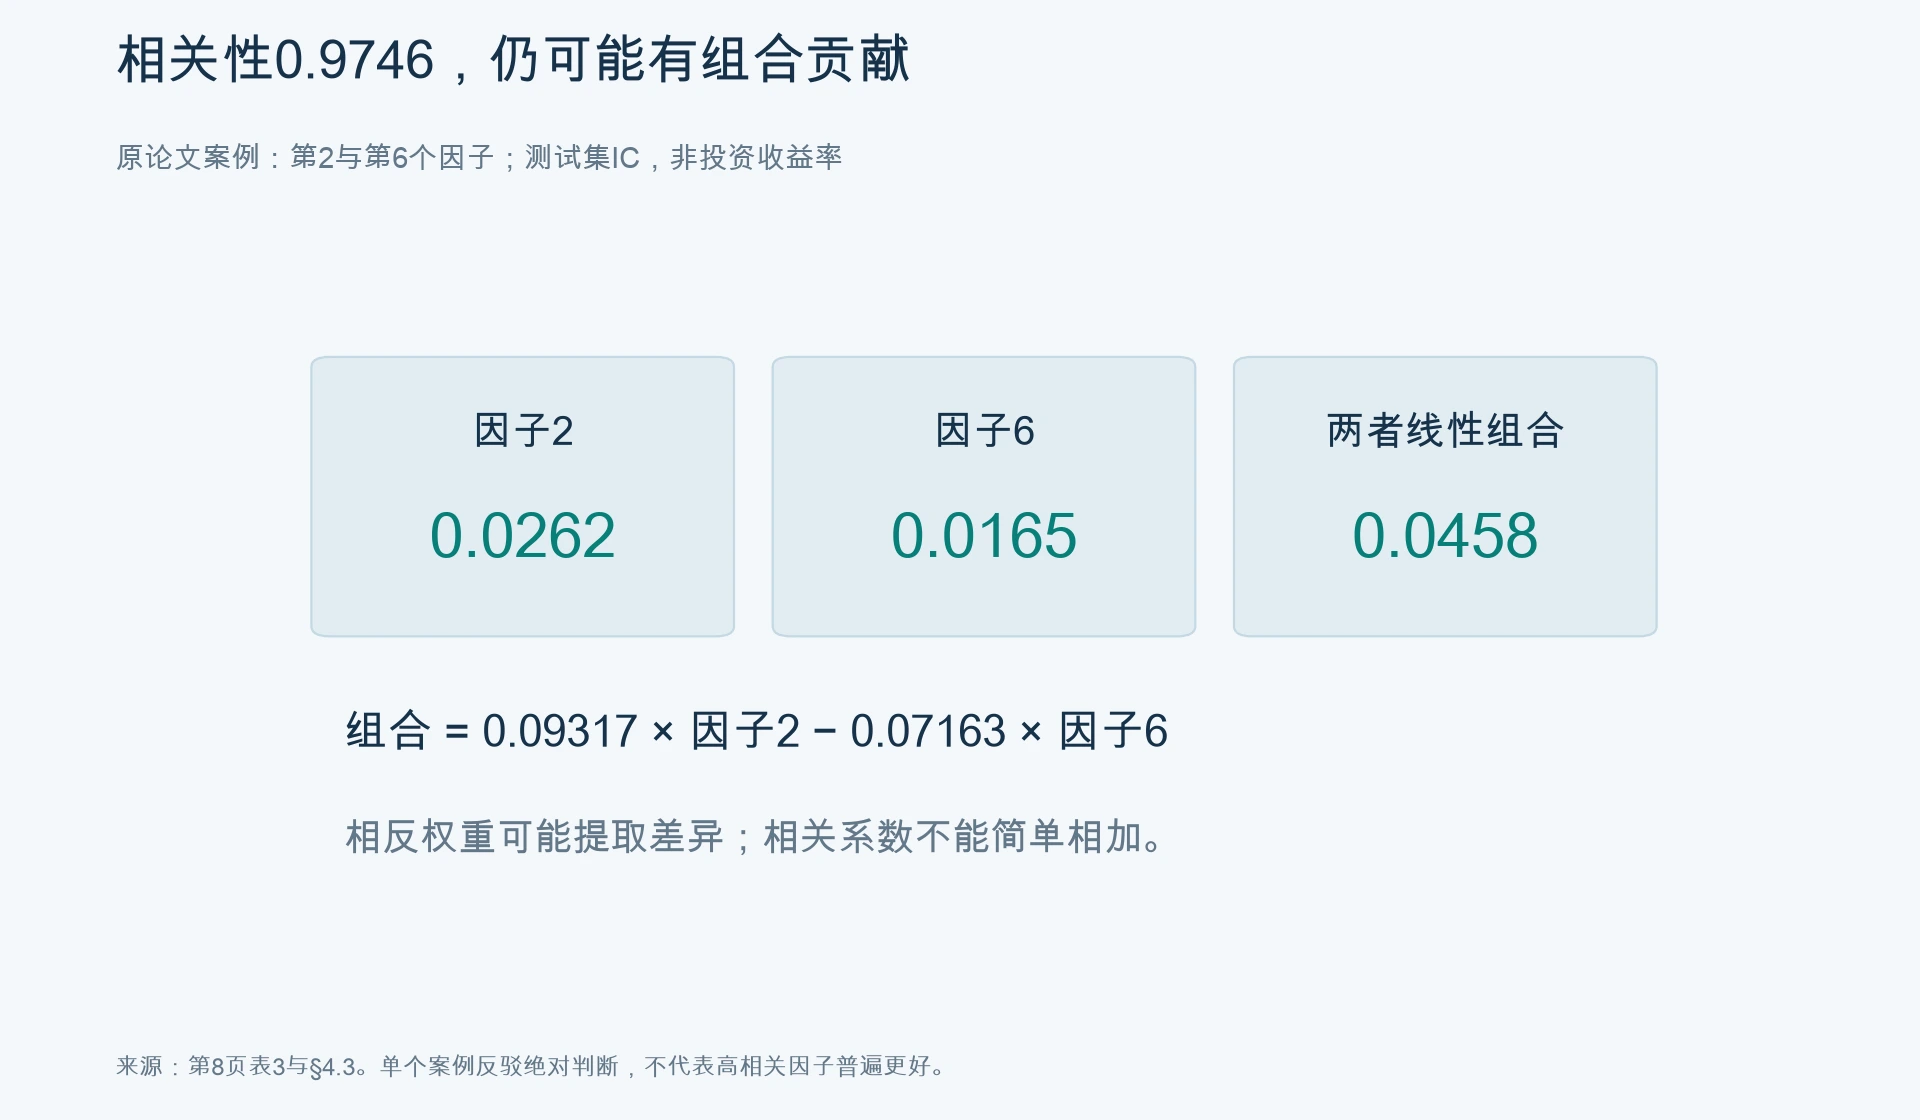
论文第8页给出一组十因子的案例。其中第2个因子与第6个因子的相互IC达到0.9746,单独的测试集IC分别为0.0262与0.0165。按常见的0.7相关性门槛,它们很难同时留下。
但原文构造的线性组合0.09317×因子2−0.07163×因子6,测试集IC为0.0458。这里用了相反方向的权重。组合提取的可能是两个相似信号之间的差异,而非把它们的共同部分再加一遍。
IC是相关系数,不具有简单可加性。0.0458高于两个单因子的IC,不代表创造了同等幅度的投资收益,也不能据此推算年化收益。这个例子的作用,是反驳“相关性高,所以组合中必然没用”的绝对判断。
同一组案例还有一个更容易被筛掉的候选:第1个因子的单独IC只有0.0011。十因子组合IC为0.0511,移除它并重新训练剩余权重后,组合IC降到0.0447,相差0.0064。这个差值来自论文案例,不是本文复算的普遍平均效果。
单因子IC问的是“自己与目标有多相关”;组合贡献问的是“在别人已经存在时,还能补上什么”。两者评价的对象不同。
图相关与组合
相关与组合
因子工厂的奖励,可以直接来自组合
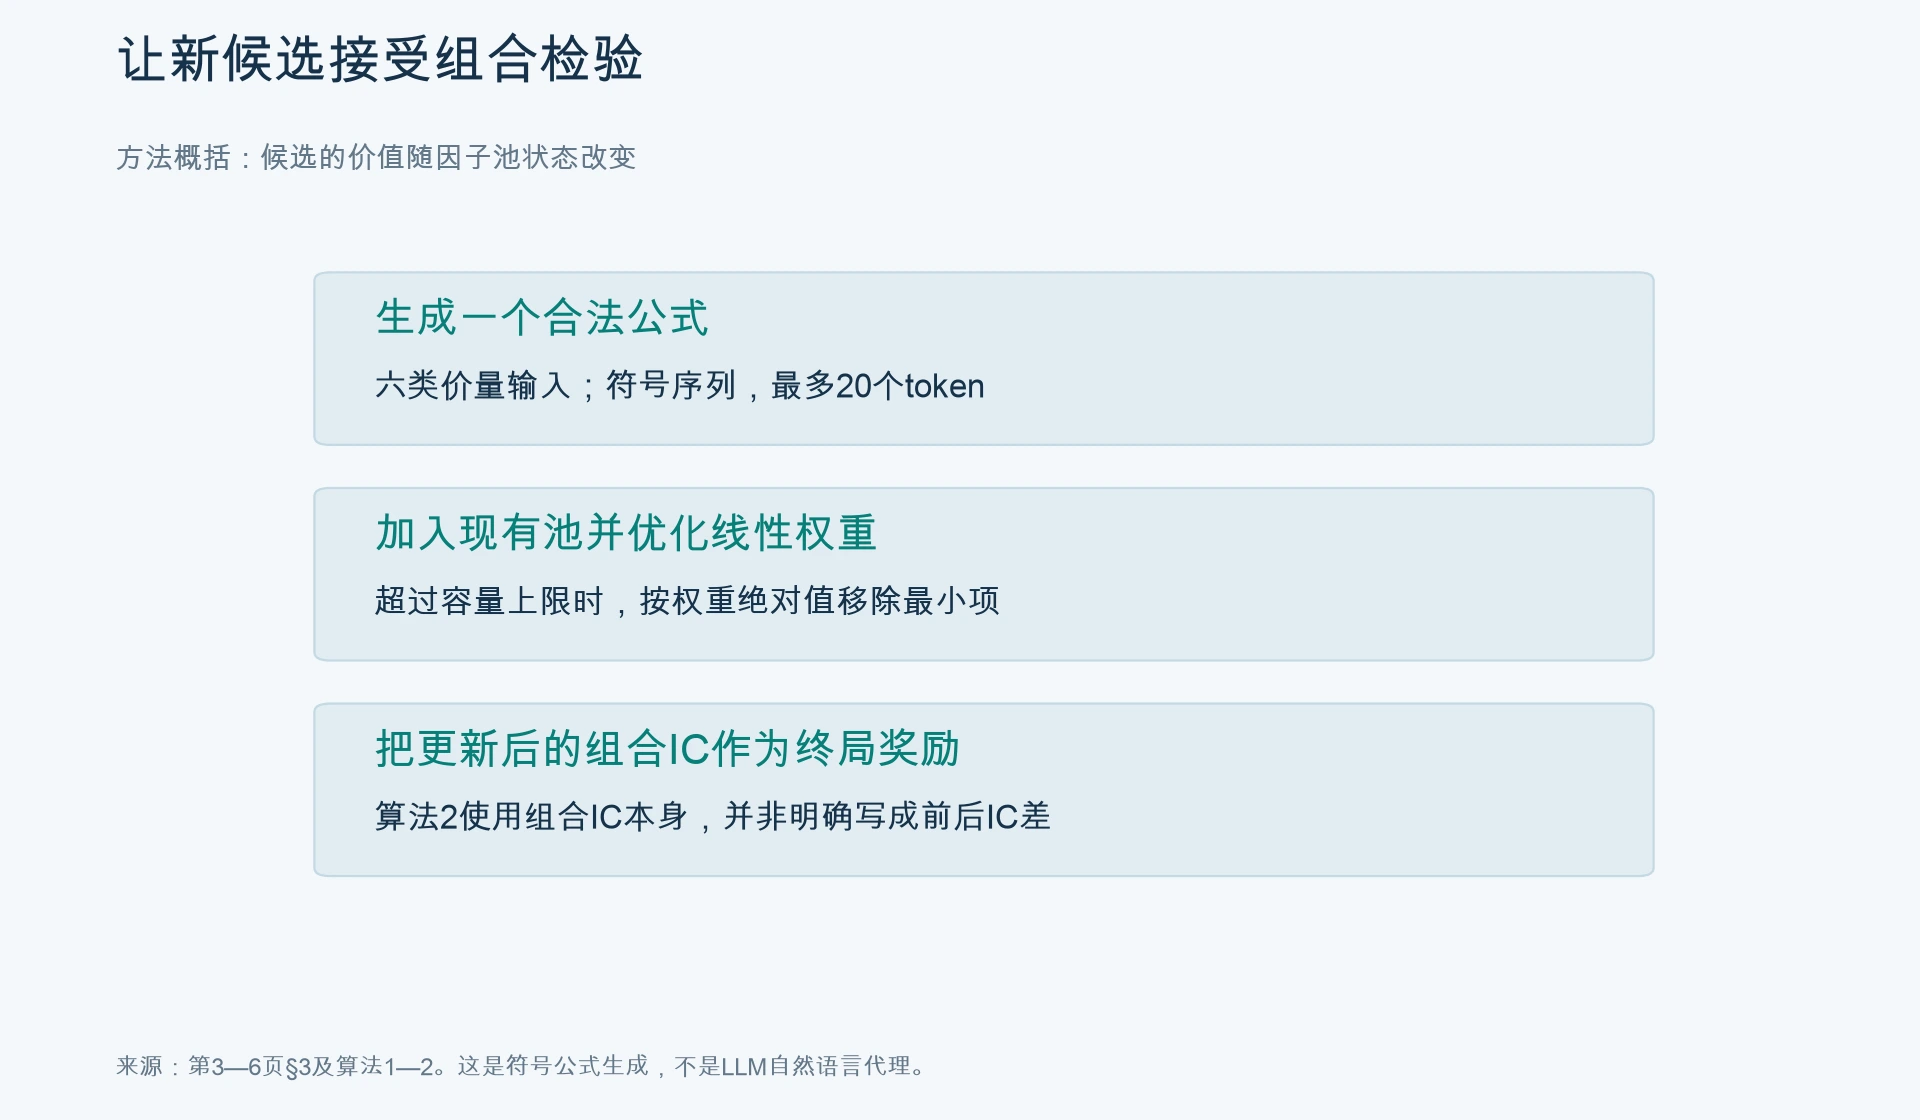
AlphaGen的生成器逐个选择符号,形成一条公式。公式采用逆波兰表示,并通过动作屏蔽约束语法合法性;表达式长度上限为20个token。输入是开、高、低、收、成交量和成交量加权均价六类价量特征,并非大语言模型生成自然语言研究报告。
新候选进入池后,框架重新优化线性组合权重。池容量超过上限时,按权重绝对值移除最小项。强化学习用更新后的组合IC作为终局奖励,中间未完成表达式的奖励为零。奖励会随因子池改变,因此同一个公式在不同池状态下,价值也可能不同。
这里有一个需要读细的实现口径:论文行文多次强调“贡献”或“改善”,但算法2实际写的是更新后的组合IC本身,并没有写成前后IC相减。复现时应分别记录旧池、新池、权重与奖励,不能把“组合IC”和“边际IC差值”当成同一个字段。
组合器的训练也不是每天都重新遍历全部股票去算损失。论文先把每日横截面信号和目标中心化并归一化,再利用各因子与目标的平均IC、因子之间的平均相关性来表示均方误差。这样可以复用统计量,降低权重优化的计算负担。因子两两关系仍按池容量平方增长,池越大并非越划算。
图组合反馈
组合反馈
实验支持了什么,尚未支持什么
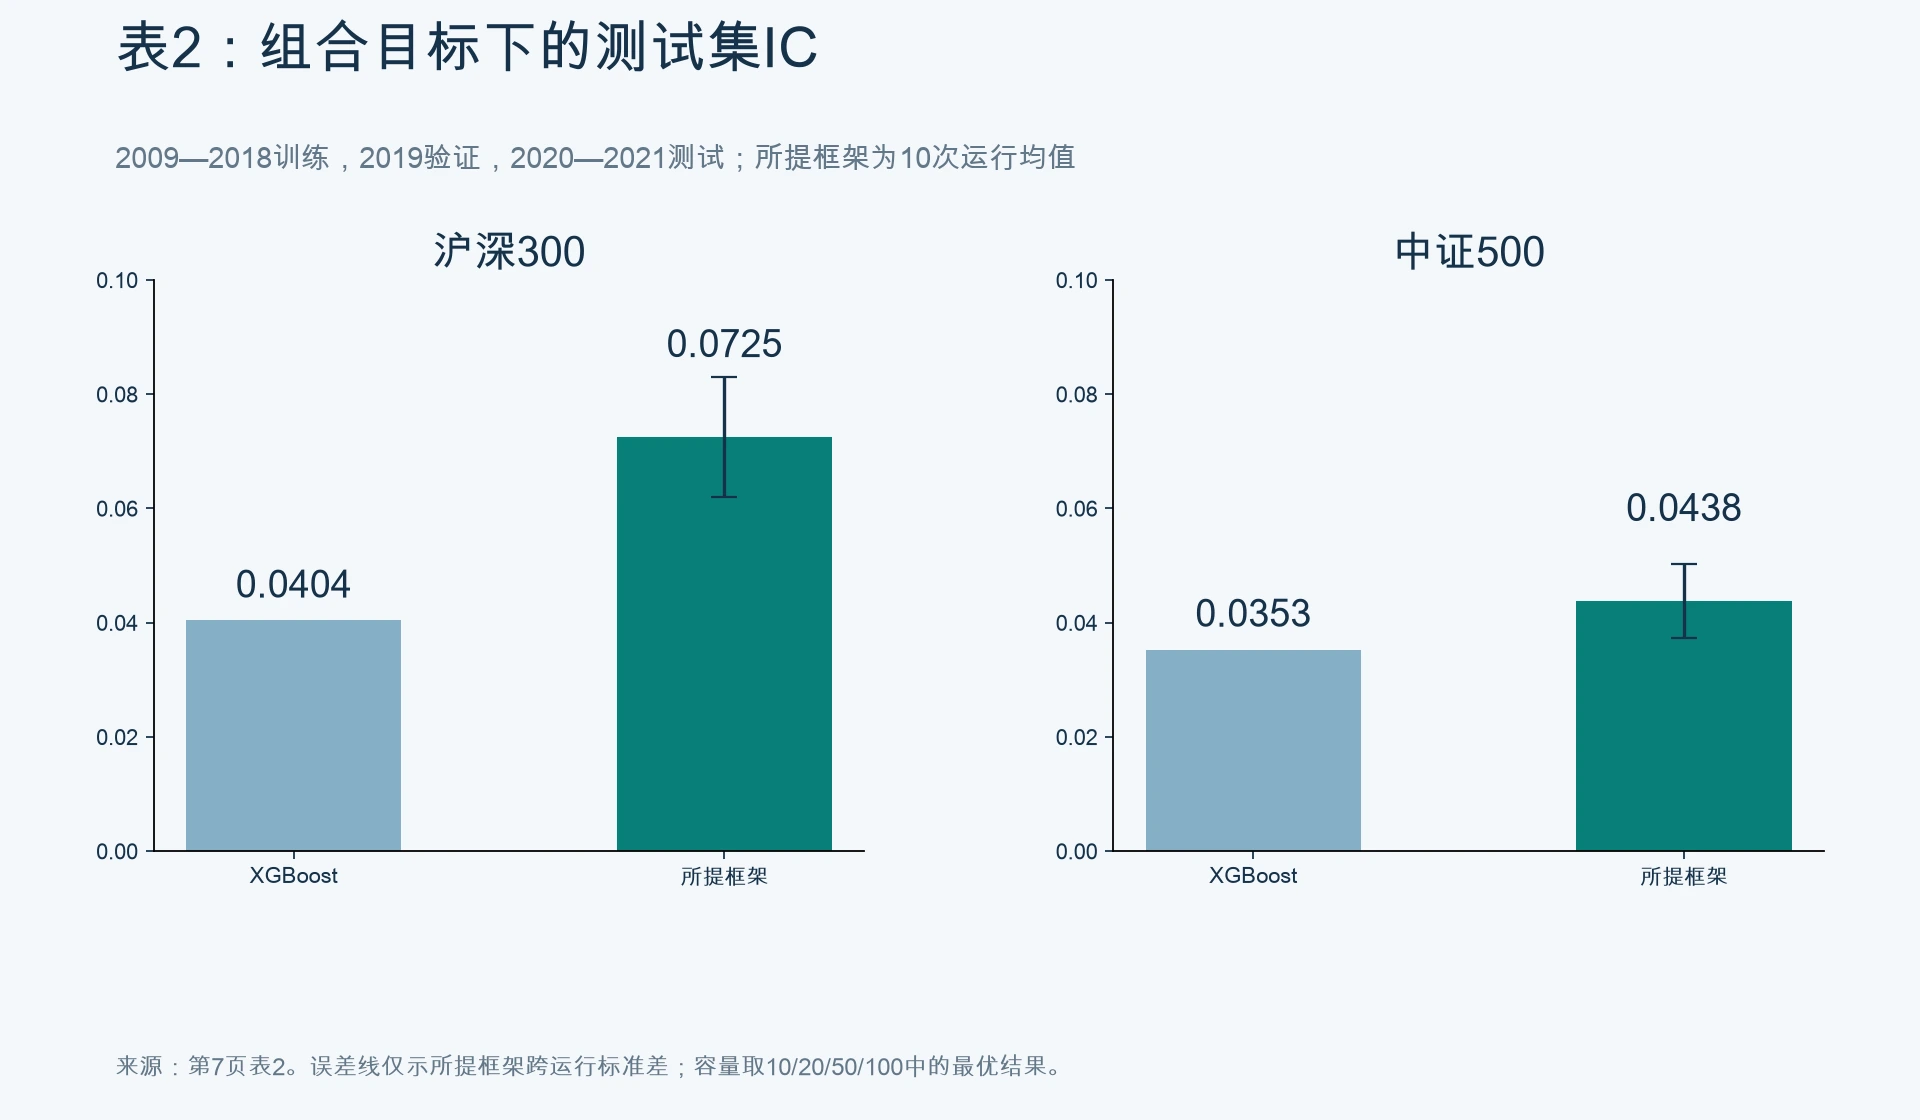
实验使用中国A股沪深300与中证500成分股,训练期为2009—2018年,验证期2019年,测试期2020—2021年。预测目标是收盘价计算的未来20日收益。带随机训练的实验配置使用10个随机种子。
论文表2中,所提框架的测试集IC均值在沪深300为0.0725、标准差0.0105;中证500为0.0438、标准差0.0064。XGBoost对应IC为0.0404与0.0353。Rank IC则分别为所提框架0.0806与0.0727、XGBoost 0.0576与0.0639。
表中公式生成方法使用的是10、20、50、100这些容量中的最优组合结果。这个脚注必须一起保留:它不是“任意选一个容量都能获得表中表现”的证据。复现者还应核对最优容量在哪个数据区间选定,并固定选择规则,避免测试集参与参数挑选。
对照还包含“单因子生成后选前k个”与“加上相互IC不得高于0.7的过滤”。结果显示,相关性过滤并没有在所有设置中稳定解决协同问题。这支持用组合反馈改进搜索目标,不能扩大成“所有降相关规则都无效”或“强化学习在所有市场都胜出”。
论文还做了沪深300测试期的投资模拟:每天选排名前50只股票,尽可能等权,每天最多买卖5只以控制交易。图5给出净值比较,但相应段落没有完整列出可直接迁移的手续费、滑点与成交限制参数。本文不从图上估算年化收益,更不把预测IC提升等同于实盘净收益提升。
图主实验结果
主实验结果
高相关留下的,也可能是脆弱差异
两支麦克风都录到了相似的背景声,相减后可能突出其中一支多录到的声音。这个类比帮助理解相反权重为什么能提取共同部分之外的信息。
但麦克风的差异可能有稳定物理来源,市场因子的微小差异可能只是样本噪声。类比到这里就该停止。两个几乎重复的因子用正负权重抵消,既可能提取有效残差信息,也可能放大估计误差、数值误差和市场状态变化。
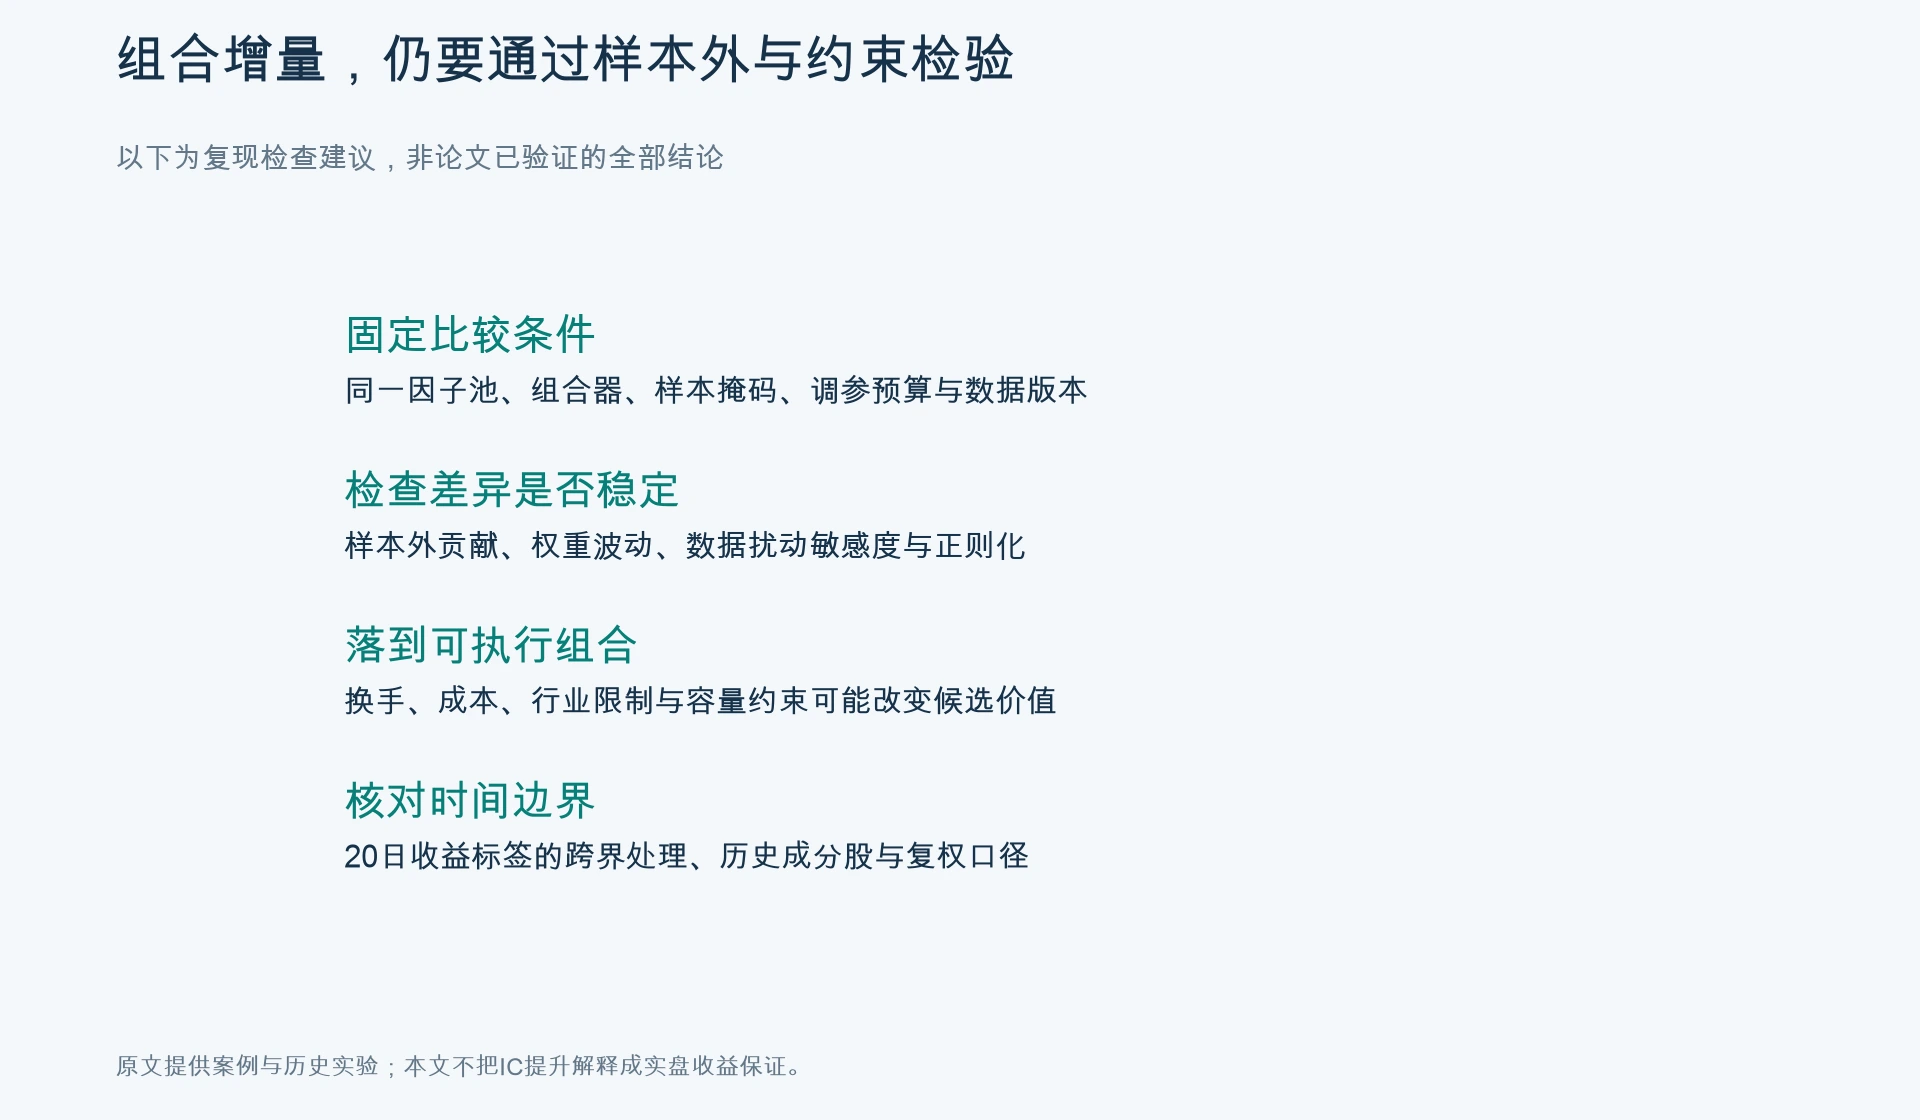
因此,确认了样本内的边际贡献之后,还需要检查样本外是否延续、权重是否剧烈变化、对微小数据扰动是否敏感。必要时加入权重约束或正则化,并在约束后的模型里重新评估贡献。不能一边用无约束线性组合证明有用,一边假设受换手、行业或交易容量限制的组合必然得到相同结果。这些是本文提出的复现检查,不是原论文已经完成的验证。
另一个容易忽略的地方是20日标签。复现时应核对训练、验证与测试边界附近的标签处理,确认标签没有跨界参与训练,并记录成分股的历史时点口径与复权数据版本。原文提供了时间划分和数据复权说明,但这些细节仍需结合代码和数据实际核验;不能只凭日历上不重叠,就宣布所有泄漏风险已经排除。
图入池边界
入池边界
入池决策里,保留两个不同的问题
单因子评价仍然需要,它帮助排除异常、检查经济含义并描述信号方向。相关性也仍然需要,它帮助识别重复、条件数问题与集中暴露。变化在于,不再让其中任何一个数字独自决定最终去留。
对一个新候选,可以固定现有因子池、组合器、样本与调参预算,记录加入前后的预测变化;再在未参与挑选的数据上,核对权重、成本和约束后的实际贡献。若换了池子或换了组合模型,就把它当成新的评价条件,而不是把旧结论照搬过去。
这篇论文留下的启发很具体:研究因子集合时,最终要评价的是它们如何共同工作。单独IC低或两两相关性高,是继续检查的理由,尚不足以替代对组合增量价值的检验。
原文:Shuo Yu、Hongyan Xue、Xiang Ao等,Generating Synergistic Formulaic Alpha Collections via Reinforcement Learning,KDD 2023,arXiv:2306.12964v1,DOI:10.1145/3580305.3599831。方法见第3—6页;实验划分见第6页;主结果见第7页表2;案例与投资模拟见第8—9页。本文基于这份本地原文解读,未独立复现论文实验。
本文由AI辅助整理,配图依据论文数字与方法重新绘制;机制类比与复现建议已与原文实证区分。内容仅供研究交流,不构成投资建议;历史回测不代表未来收益。
资料与阅读边界
本文为方法讨论与教学说明。文中示例不等于经独立验证的收益实证;如需具体数据、计算口径或资料来源,可通过官方渠道提出核对请求。
历史结果不代表未来表现。使用前请检查数据时间边界、样本独立性、交易成本及适用条件。
关键结论
- 单因子IC与组合增量价值是不同评价对象。
- 高相关不必然无用,正负权重提取差异也可能放大噪声。
- 在固定池、样本、模型与交易约束下核验样本外贡献。