金融工程多智能体加密资产交易系统
3个AI都说卖,谁说了算?
沿一笔ETH减仓决策追踪多智能体的意见、分权与已有仓位。
本文要点
动作比例与目标仓位不能混读。
同向建议使权重影响幅度,未必改变方向。
2026年6月23日,同样面对一组互相打架的市场材料,两套AI交易系统给出了相反动作。
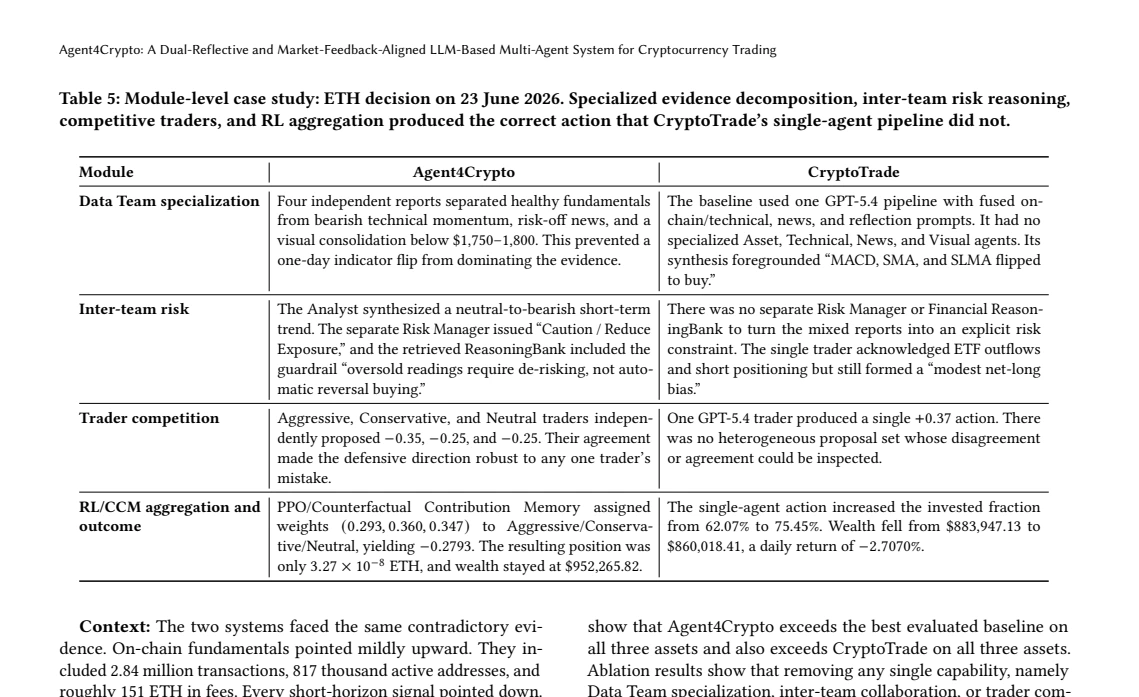
Agent4Crypto里的激进、保守、中性三个交易员分别建议−0.35、−0.25、−0.25。对照系统CryptoTrade建议+0.37。论文记录的下一开盘,ETH从1726.12美元跌至1665.04美元。
这很适合讲成“多智能体躲过暴跌”的故事。但如果负责接入交易系统,我会先问一件小事:−0.35,究竟是卖掉35%的账户,还是卖掉现有持币的35%?
《Agent4Crypto: A Dual-Reflective and Market-Feedback-Aligned LLM-Based Multi-Agent System for Cryptocurrency Trading》在11月9日提交。它的设计重点,是让不同风格的交易员提出建议,再用强化学习分配影响力。顺着这笔ETH决策走一遍,可以看清“多一个角色”和“多一份独立价值”之间还有多远。
图概念示意
三个AI的决策会议
图概念示意
原文表5:ETH单日决策的逐模块记录
交易台上的动作单
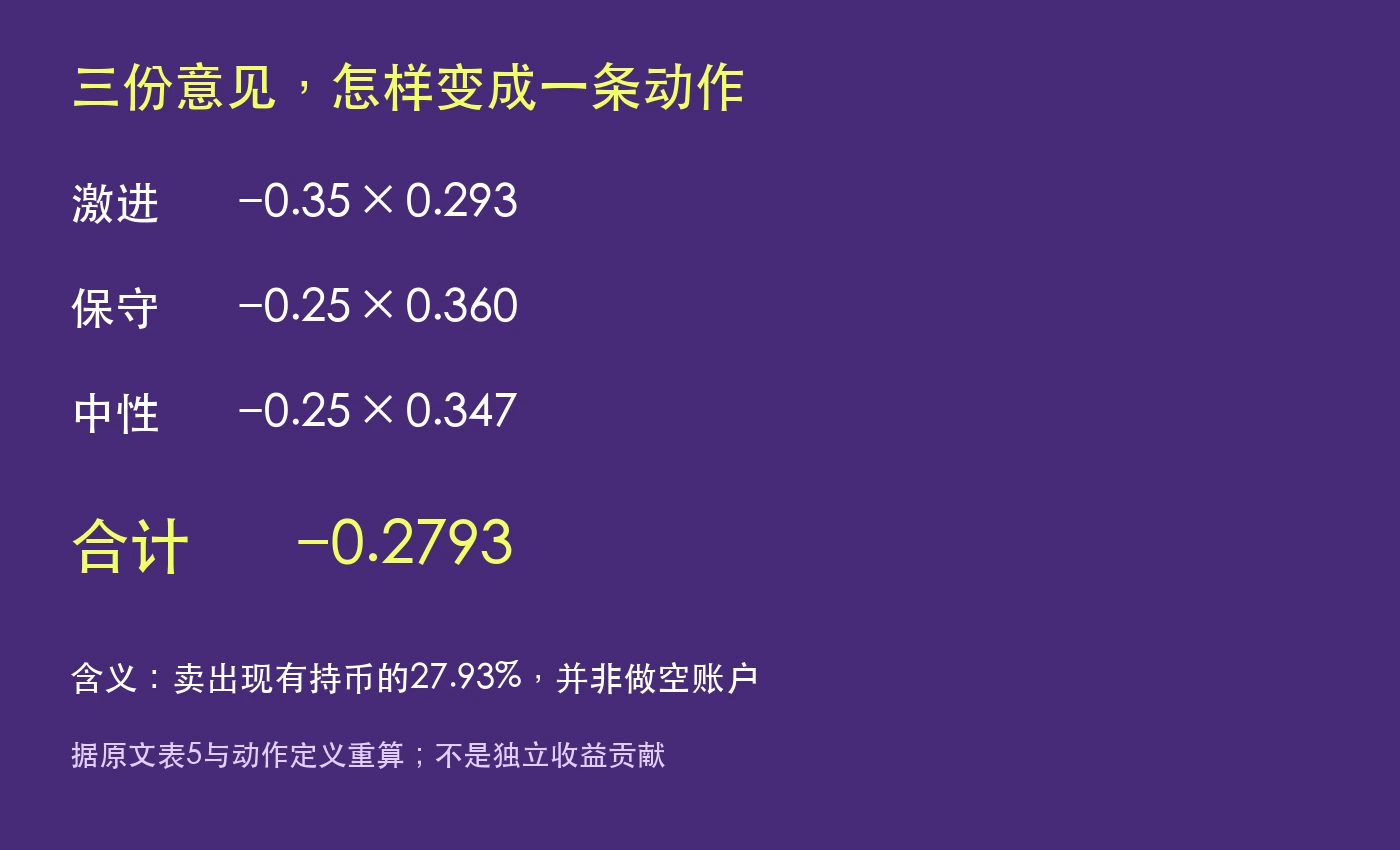
这里的动作范围是−1到1。正数表示拿剩余现金的一部分买币;负数表示卖掉已持有币的一部分;零表示不动。因此−0.35是卖出现有持币的35%,并不等于做空35%,也不是把账户目标仓位直接设成−35%。
三个交易员的意见用非负权重加总,权重合计为1。案例中的权重为0.293、0.360、0.347,算下来最终动作为−0.2793。既然三份建议都在−0.35到−0.25之间,无论怎样在合法权重内分配,这次方向都会是卖。门控决定卖得多一点还是少一点,没有独自决定“该卖还是该买”。
更值得看的是执行前已有多少币。论文表5说,动作完成后Agent4Crypto只剩约3.27×10⁻⁸枚ETH,账户财富保持952265.82美元。按它自己的“卖出已有持币一部分”规则,这不能读成当天一条−0.2793指令把高仓位账户清空。它说明该系统在进入这个案例前已经几乎持有现金。
对照系统则把投资比例从62.07%提高到75.45%,次日账户收益为−2.7070%。两套系统接到相同市场信息,却沿着各自先前交易形成的仓位继续走。单日差距混合了已有仓位和新增动作的影响,不能全部归功于这一次三个AI开会,也不能由此证明门控权重有独立贡献。
如果要补一项真正能隔离当天动作的实验,可以把两套方案放到相同起始仓位上重放。这是本文提出的检查,并非作者已经报告的结果。
图概念示意
根据原文动作与权重计算的最终指令
谁在给谁打分
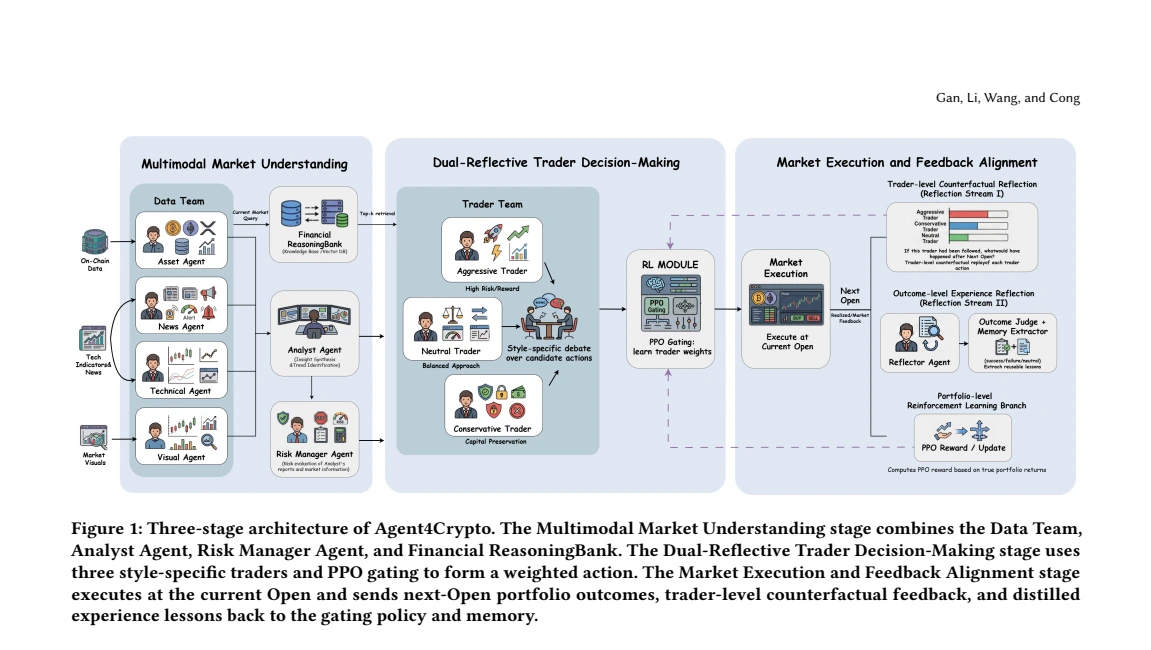
系统前端把资产、技术、新闻、图像分给不同角色处理,分析员汇总,风险经理提供文字判断,再把可检索的经验交给三位交易员。这里的风险经理是一段定性报告,不是独立账户限额;文字写着“谨慎”,并不等于程序已经保证最大损失不会越界。
交易后的反馈分两路。一路把已完成轨迹整理成成功、失败或中性的经验,存进ReasoningBank,之后按相似度检索。另一路给交易员算最近五步的假想贡献,再交给PPO门控。门控学习的是交易员权重,论文并没有在此过程中训练三个语言模型本身的参数。
“假想贡献”也不是每位交易员独立账户的净利润。原文公式对买入建议按动作乘下一步市场收益计分;对卖出建议,只在后续市场下跌时记正贡献,市场上涨时为零。卖出错过上涨的机会成本,没有以对称负分写入这一项。最终账户收益作为另一个奖励信号进入PPO,二者不能混称为同一套盈亏账。
这种评分定义会影响系统愿意信任谁。它是否导致了结果里的防守倾向,需要专门对照才能确定,不能只凭公式就断言有偏或无效。但维护者至少应该知道,排行榜上的“可靠”究竟奖励了哪一种行为。
图概念示意
原文图1:信息、交易员与反馈的关系
把三人会议换成一人,差多少
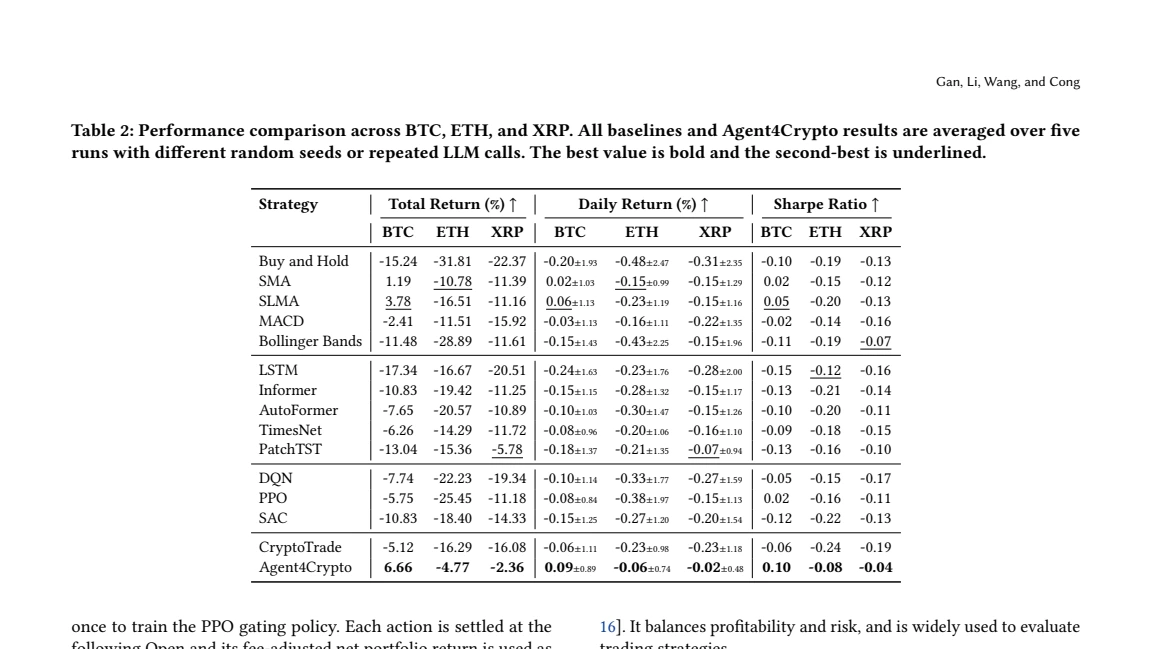
主结果中,系统在BTC、ETH、XRP的总收益分别为6.66%、−4.77%、−2.36%。三个资产的最强对照分别为3.78%、−10.78%、−5.78%。相对排名领先,不代表三种资产都赚了钱,更不是年化收益。(原文表2)
最直接的问题来自表3:只保留中性交易员,并移除PPO与贡献记忆后,BTC收益为6.63%,完整版6.66%,差0.03个百分点;XRP为−2.41%与−2.36%,差0.05个百分点;ETH差0.58个百分点。这个消融同时改变了交易员数量和聚合模块,不能单独拆出每个模块的功劳。
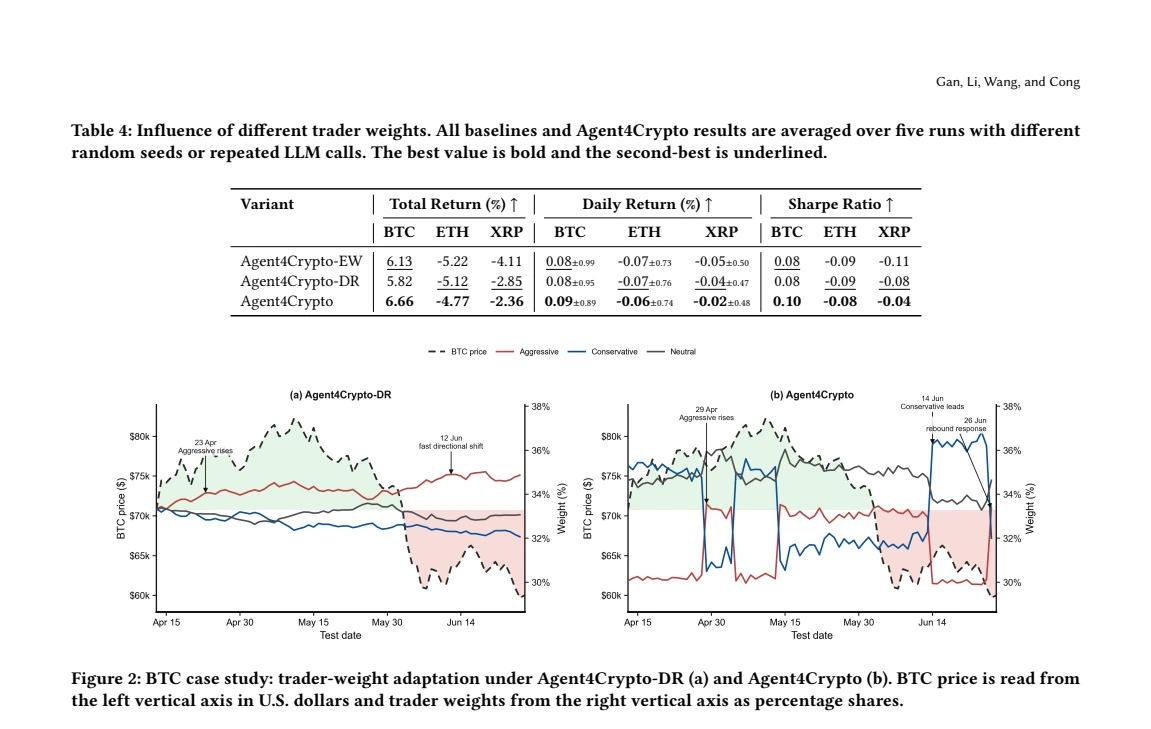
表4另做了一组更匹配的比较:保留同样的交易员,只换分权规则。相对等权,完整版在三个资产上分别多0.53、0.45、1.75个百分点;相对直接按市场方向更新权重,分别多0.84、0.35、0.49个百分点。这里更接近“复杂门控多带来了什么”的问题,但没有据此报告完整的差异置信区间,不能把小数点后的差距写成稳定保证。
论文还有一处值得自己算:文字称移除数据团队专门化后,ETH“略好”,表中却是−4.83%,完整版−4.77%。按收益越高越好的方向,前者实际上更差0.06个百分点。本文沿用表内值,不照抄这句叙述。
到这里,选择已经具体了。如果只是想让决策可解释,可以先把单个交易员的输入、动作和现有仓位记录清楚;若要引入三人会议,就让它在相同输入和成本下与单人、等权、简单分权规则竞争。新增角色应当交付可检查的增量,而不只是更长的讨论记录。
论文每次模拟以100万美元开始,现金与币各一半,按当前开盘执行、下一开盘估值,成交金额收0.1%手续费;报告五次运行平均。它严格限制提示输入的可用时点,测试开始前也重置记忆和仓位、冻结PPO。冻结门控不等于整个系统停止吸收新信息:经验记忆仍可随已完成交易积累。另一个边界是模型知识,测试晚于某模型发布日期,本身不能证明后续调用时的模型参数从未接触测试期历史。本文没有独立核验模型训练内容或复现实验。
三个测试窗口各只有约两个半月,且日期不同。表内夏普按日收益均值除以日标准差、无风险利率取零,没有乘年化因子;0.10不能拿去与一张年化夏普1.5的策略图直接比较。这里也没有提供完整的大模型调用费、延迟与成交冲击核算。
我愿意留下的是这张可以追踪的动作单:读到了什么,三位交易员各提了什么,如何分权,原本持有什么,最后实际成交多少。它让一句“AI判断对了”拆成了能逐项核对的记录。至于这场会议值不值得每天召开,要由同口径的增量结果支付成本。
来源:Guangyan Gan、Jiahao Li、Jiashun Wang、Lin William Cong,Agent4Crypto,arXiv:2611.12269v1,2026-11-09,本地10页版本。动作和贡献公式见第5页,协议和主结果见第6页,消融见第7页,分权比较见第8页,案例见第9页。原图节选与动作重算均已注明,数字为作者报告,未独立复现。论文:https://arxiv.org/abs/2611.12269 。
图概念示意
原文表2:主结果与对照方法
图概念示意
原文表4与图2:分权规则和BTC权重轨迹
资料与阅读边界
本文为方法讨论与教学说明。文中示例不等于经独立验证的收益实证;如需具体数据、计算口径或资料来源,可通过官方渠道提出核对请求。
历史结果不代表未来表现。使用前请检查数据时间边界、样本独立性、交易成本及适用条件。
关键结论
- 动作比例与目标仓位不能混读。
- 同向建议使权重影响幅度,未必改变方向。
- 单日案例需要区分初始仓位与新增动作。