金融工程强化学习风险控制大模型量化
AI想下单,风控凭什么放行?
强化学习提出配置,风险证书决定放行;收益代价与证书边界分别验收。
本文要点
零证书违规不等于零亏损。
触发式投影在本实验保留更多收益。
投资模型提交了一组新权重。预期收益不错,解释也完整,风控台上却还有一个更具体的问题:这组配置遇到已经看到的流动性或行业冲击,是否越过了预先约定的风险边界?
11月10日的《Conformal Risk Certificates for Portfolio Optimization Under Uncertainty》试着把这个判断放在执行前。强化学习提出配置,语言模型从新闻提取风险状态,另一层数学约束决定原方案能否通过。读这篇论文,我更关心放行依据,而不是先问收益排行榜。
图概念示意
居中标题封面:强化学习交易的风险闸门
放行单上,不能只写“模型有信心”
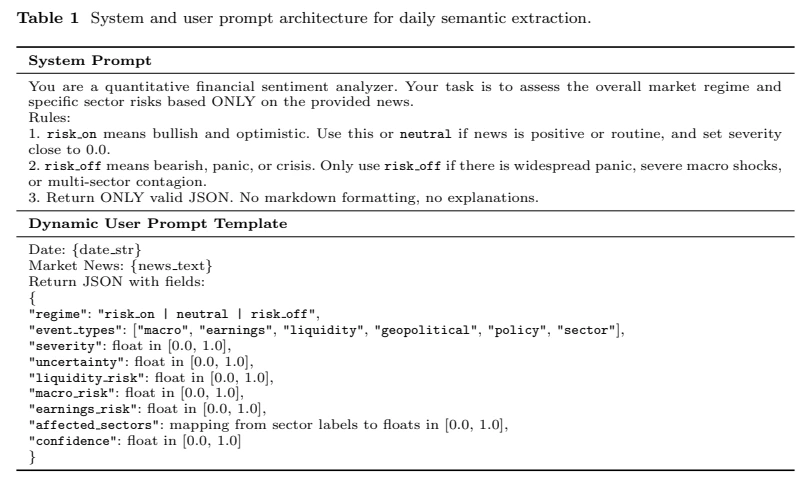
论文用Llama-3-Instruct提取严重程度、宏观压力、流动性、盈利及行业风险等字段。输入是带时间的新闻标题和正文片段,每天最多20条;输出要求符合JSON结构。温度设为零,并不能把模型置信度变成统计上校准过的概率。格式失败时进入中性回退,也不表示市场没有风险。(第12—13页)
这些字段随后改变不利冲击集合的中心和形状,再用滚动历史分数校准集合半径。可以把它理解为:系统先规定要检查哪一类压力、覆盖多大范围,再计算拟议持仓在这个集合内可能承受的最坏语义损失。
如果方案满足预算,直接放行;超出预算,才求解一组修正配置。这里的“最坏”只针对构造出的冲击集合,并不是所有现实灾难的上界。新闻抽取错了、风险映射漏了、未来冲击落在集合之外,都不会因为数学求解正确而自动消失。
图原文图节选
原文表1:风险提取提示与字段结构
风控究竟买来了什么
实验使用九只美国行业SPDR ETF,按48个月训练、随后12个月测试滚动,测试年为2019—2023。交易成本按单位交易权重10基点计算。Raw PPO本身也接收语义状态;它与闸门版本的区别,是执行前是否受到证书约束,不能把Raw PPO误称为完全不读新闻的基线。
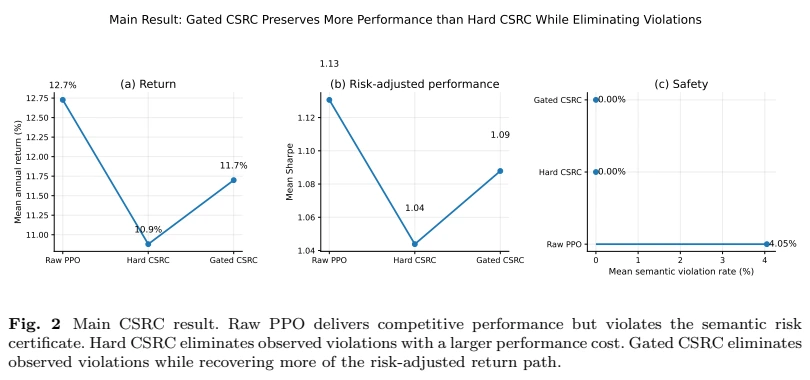
五个年度测试折的平均年收益,Raw PPO为12.7%,每日都修正的Hard CSRC为10.9%,按需介入的Gated CSRC为11.7%。相应平均语义违规率为4.05%、0和0。(第16—17页)
从12.7%到11.7%,代价是1个百分点。它不是整个账户累计只损失1%,更不是固定保险费。这个结果说明,在作者的实验里,按需修正保留的收益比每日修正更多;它并没有证明今后也能以相同代价控制风险。
“零违规”尤其需要读完整。1256个配对测试日中,Raw PPO有51天越过证书边界,闸门版未观察到越界。51/1256约为4.06%,与先分别计算每年再平均得到的4.05%是不同口径。零越界不等于零亏损,也不等于没有回撤。
图原文图节选
原文图2:原始策略、每日修正和触发式闸门的比较
平常可以不动,压力来了才拦?
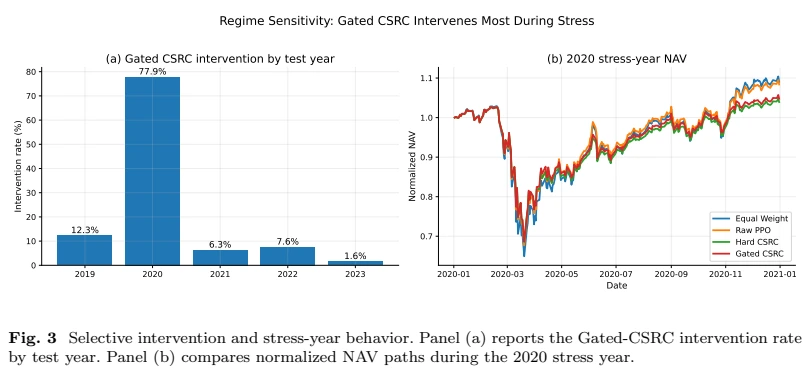
2020年,闸门干预77.9%的方案;2023年降至1.6%。左图表示干预频率,右图仍能看到压力年份的净值下跌。把两边一起看,比只截一条“零违规”结论更容易理解这套系统:它改变的是允许执行的配置,并没有让账户免疫市场损失。
但“每到危机就会有效”尚需更多证据。这里只有一个资产集合和五个测试年,新闻风险状态与后续市场变化也不是天然的因果关系。部署时还要检查材料何时实际可得,以及模型训练知识是否可能含有后来信息;文本按历史日期过滤,本身不能证明消除了参数里的历史知识。
图原文图节选
原文图3:各测试年干预比例与2020年净值
谁来给证书打分
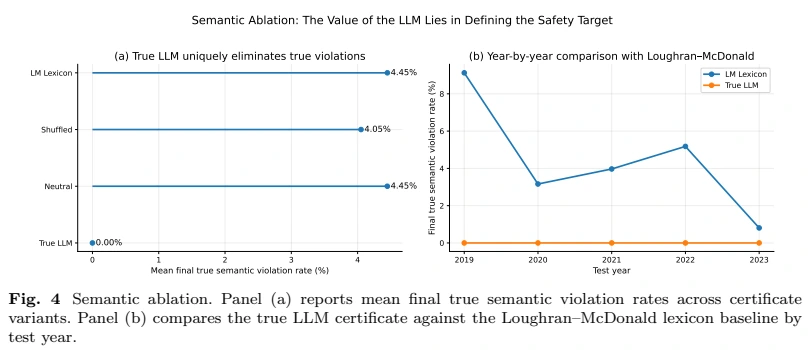
作者把风险输入换成中性状态、打乱时间的模型状态及金融词典,对照方案仍通过同样数学形式的执行层。最终统一按原始、时间对齐的LLM证书评分,违规率分别出现4.45%、4.05%和4.45%;原始证书版本为0。
这里的true是论文定义的参考证书,不是外部观测到的“真实世界风险真值”。按原证书约束的方案,在原证书评分下更合规,支持了约束执行的一致性;它不能单独证明LLM识别的风险比其他来源更接近真实损失。还需要检查独立压力事件、实现损失和覆盖表现。
同样,配对违规检验的显著性与投资收益的显著性需要分开。论文对51对0的违规结果报告很小的McNemar检验p值;收益与夏普比较则未检出显著差异。未检出损失不等于证明收益完全相等,更不能写成免费风控。(第20—21页)
图原文图节选
原文图4:中性、打乱时间与词典证书的对照
最后一道签字,要落在参数上
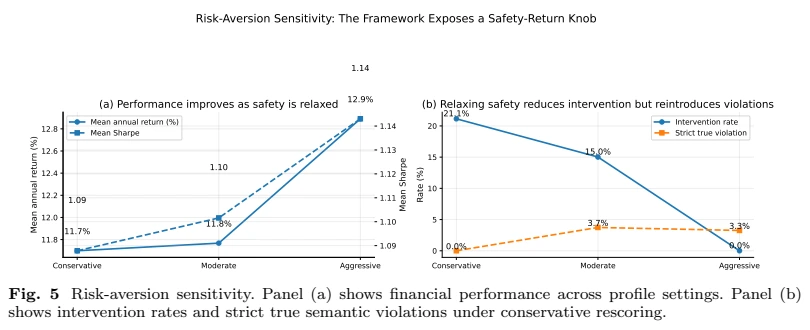
保守、中等、激进配置的平均年收益为11.7%、11.8%、12.9%,干预比例为21.1%、15.0%、0。统一用保守证书重新评分,严格违规率是0、3.7%、3.3%。中等与激进的违规率并没有严格递增,因此不能把三点画成普遍的单调规律。
从风控负责人的位置看,这组结果要求我们明确选择边界。覆盖目标、现金约束和触发容忍度放松了,放行数量会变,收益路径也会变;不能先享受宽松规则,再改用宽松口径宣称“仍然安全”。
论文还给出一个朴素但重要的对照:等权组合在其测试中,不加投影已经是零语义违规。不是每一套策略都需要同样复杂的闸门。对本来就满足规则的方案,控制层的维护、数据和交易代价也应该记账。
我会把这项研究带来的工作变化落在每日执行记录上:保存原配置、新闻可用时点、提取字段、证书参数、干预原因和最终配置。再用独立的实现损失检验证书是否覆盖了真正担心的风险。这是面向实施的建议,并非论文已经完成的实盘验证。
AI可以提议,但放行依据应当能够重算。证书的边界越明确,风控越容易知道自己约束了什么,也越不容易把尚未覆盖的风险误当作已经解决。
来源:Mohammad Zarei、Amirhossein MohammadpourAzari、Moslem Habibi,Conformal Risk Certificates for Portfolio Optimization Under Uncertainty: A Gated Reinforcement-Learning Approach,arXiv:2611.14699v1,2026-11-10。本地26页版本。五幅正文图节选自表1及图2—5;封面为概念插图。数字为作者报告,未独立复现实验。原文:https://arxiv.org/abs/2611.14699 。
图原文图节选
原文图5:风险偏好放松后的收益、干预与严格违规率
资料与阅读边界
本文为方法讨论与教学说明。文中示例不等于经独立验证的收益实证;如需具体数据、计算口径或资料来源,可通过官方渠道提出核对请求。
历史结果不代表未来表现。使用前请检查数据时间边界、样本独立性、交易成本及适用条件。
关键结论
- 零证书违规不等于零亏损。
- 触发式投影在本实验保留更多收益。
- 参考证书不是外部风险真值。