科学评估因子工程科学评估AlphaEval样本外验证
因子IC更高,就值得留下吗?
AlphaEval把预测、稳定、抗扰动、金融逻辑和多样性放在一起评估。结合原文表格,看清快速筛选能回答什么,以及交易验证还缺什么。
本文要点
预测分、排名稳定和抗扰动表现需要分别观察.
逻辑分与多样性不能单独证明因子有价值.
挖出一批新因子后, 最容易做的事是按IC从高到低排个队. IC衡量因子分数与后续收益的相关程度, 数字越高, 看起来越值得留下.
问题常常出在下一步: 分数高的信号, 可能一天换一套排名; 输入数据稍有变化, 结果就变了; 留下的几十个公式, 也可能反复表达同一类信息.
AlphaEval讨论的正是这段研究工作. 它希望在昂贵的组合回测之前, 先把候选因子的预测、稳定性、抗扰动、金融逻辑和多样性分别看清. 这套评估能帮研究者更早发现问题, 但从分数到可交易收益, 中间仍有一段距离.
图因子IC更高就值得留下吗
因子IC更高就值得留下吗
预测分领先, 其他项可能落后
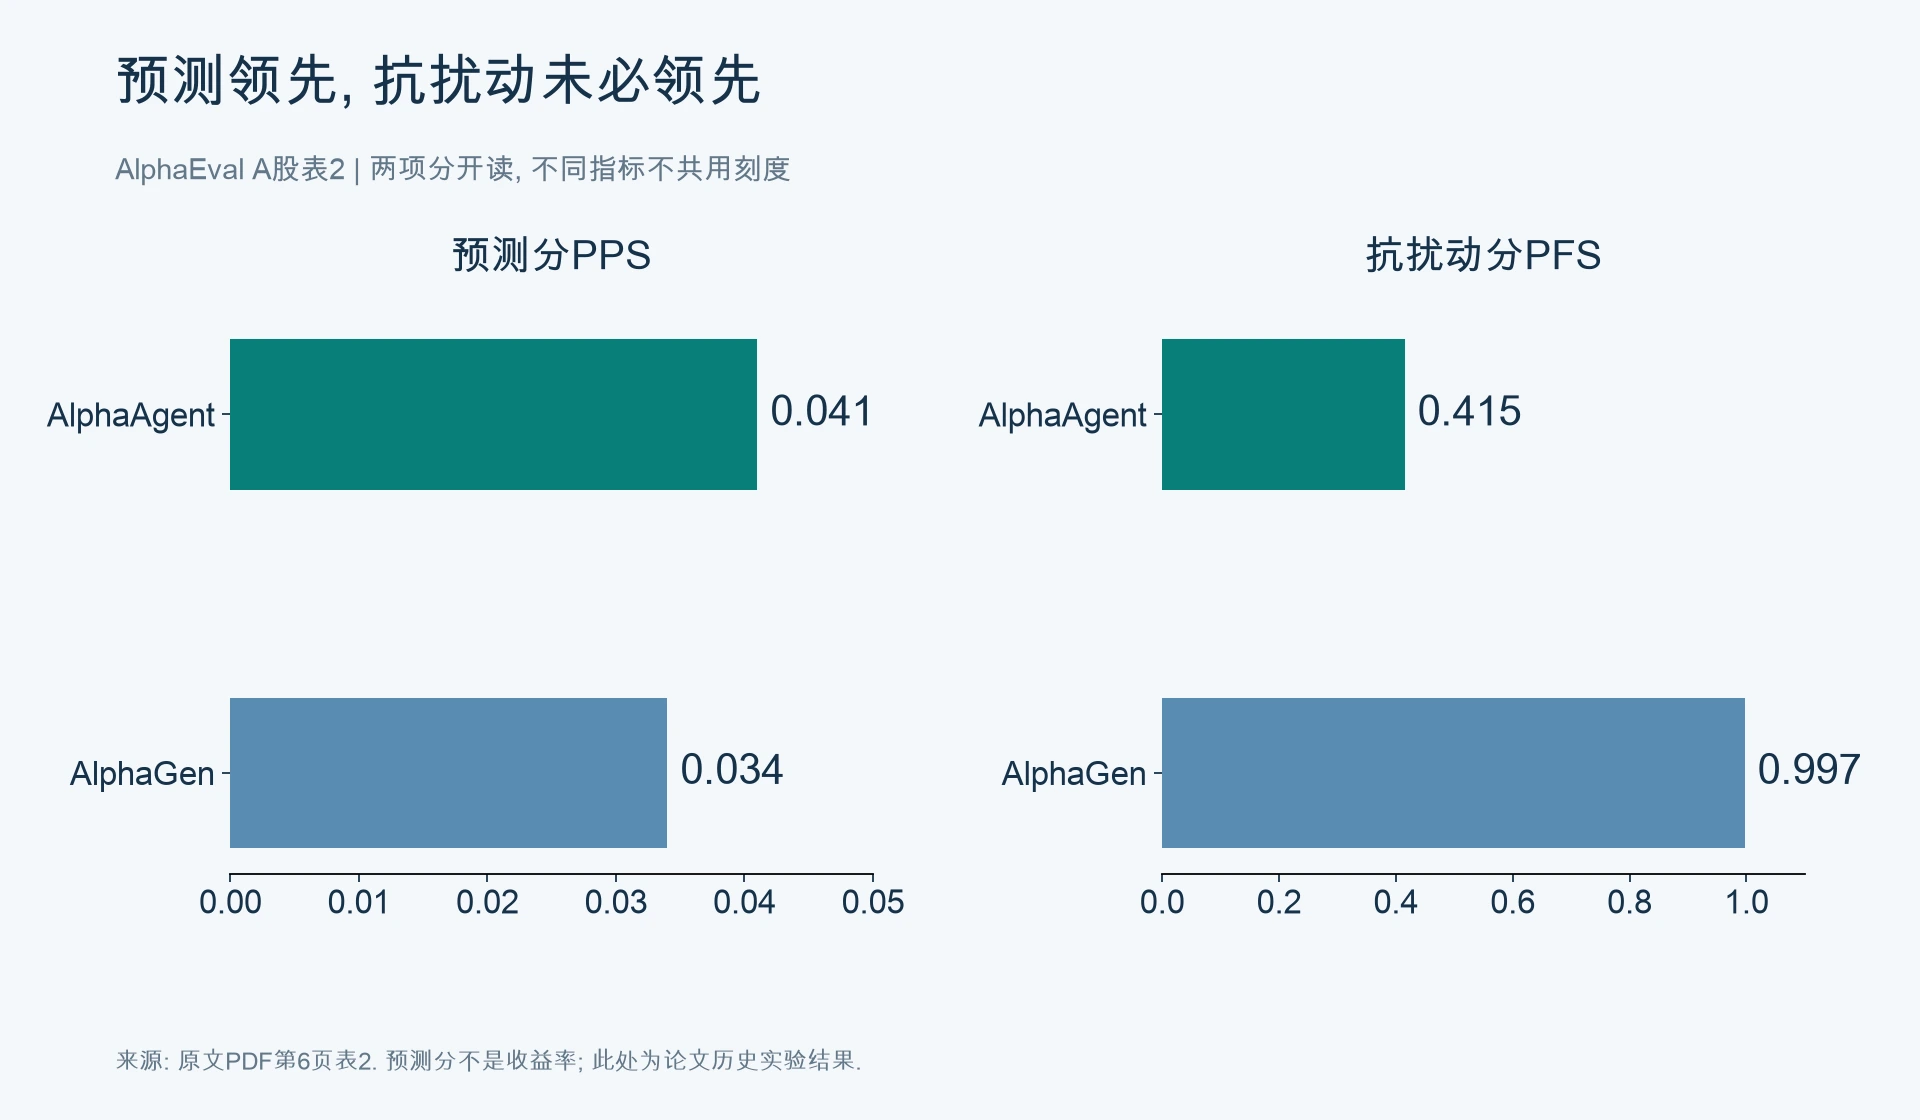
先看论文里一组有用的对比. A股实验的表2中, AlphaAgent的预测分为0.041, AlphaGen为0.034. 如果只按这一项排序, 前者在前.
但两者的抗扰动分分别为0.415和0.997, 排名稳定分分别为0.779和0.978. 预测相关性较高的模型, 在另外两项上落后. 这些数字描述的是论文实现与样本中的输出特征, 并非某类算法的永久排名.
这里的预测分叫PPS. 在论文默认设置下, 它是IC与RankIC各占一半的加权结果. RankIC看的是股票排名与后续收益排名的相关性. 所以0.041既不是4.1%的年化收益, 也不是所有因子的平均IC.
表2还有一个提醒: 随机参考项的多样性分为0.981, 高于表内不少挖掘模型. 差异大可以意味着信息互补, 也可以只是没有共同规律的噪声. 多样性需要和预测能力一起读.
图预测与抗扰动的取舍
预测与抗扰动的取舍
五项检查, 各自回答不同的问题
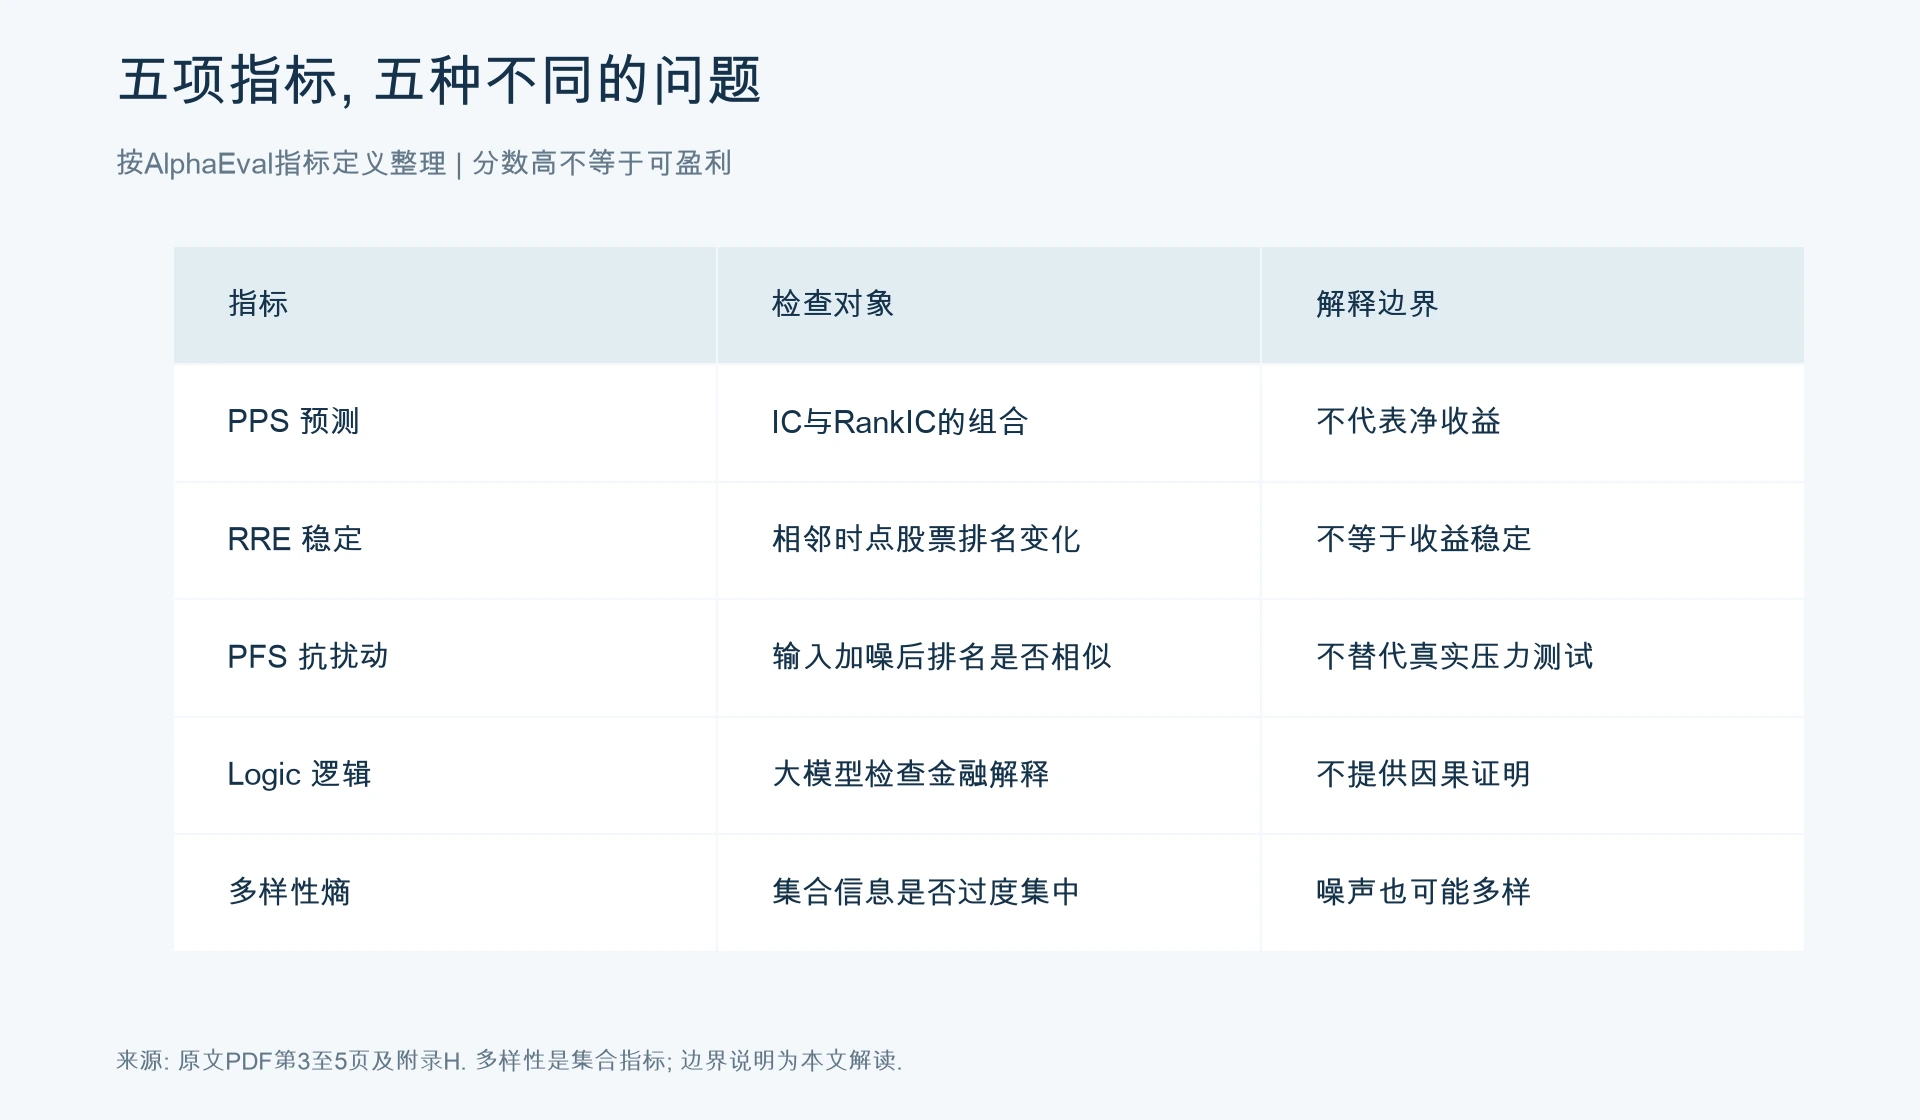
预测能力回答信号与后续收益是否有关. 另外几项进一步检查这种关系以什么形态出现.
排名稳定性RRE比较相邻时点的股票排序. 排名变化较小, 往往意味着调仓需求较少. 论文用排序构造分布, 再由相邻分布的KL散度形成分数. 它观察的是信号排序的连续性, 不能直接当作策略收益稳定性.
抗扰动分PFS则改变输入数据, 观察新旧输出排名还像不像. 研究分别加入高斯噪声和厚尾的t分布扰动, 再取两类结果中较差的一个. 实验把t分布自由度设为3, 并将两类噪声缩放到相同标准差. 高分表示对这套扰动较不敏感, 并不等于已经经历过真实危机.
金融逻辑分让GPT-4o检查公式的经济直觉与解释是否连贯. 附录要求给出50至100分并附解释. 它适合发现逻辑薄弱、难以说明的表达式. 模型能讲出道理, 仍然不构成因果证据.
多样性熵从一组信号的协方差矩阵出发, 检查信息是否集中在少数方向上. 这是集合层面的诊断, 不能给单个孤立因子贴上"与现有库互补"的标签, 更不能脱离信号尺度、标准化方式和比较集合解释分数.
图五项检查与各自边界
五项检查与各自边界
历史实验提供了哪些支持
这篇本地论文是2026年6月2日的arXiv v2版本. 作者在Qlib提供的A股与美股数据上比较了多种公式因子挖掘方法.
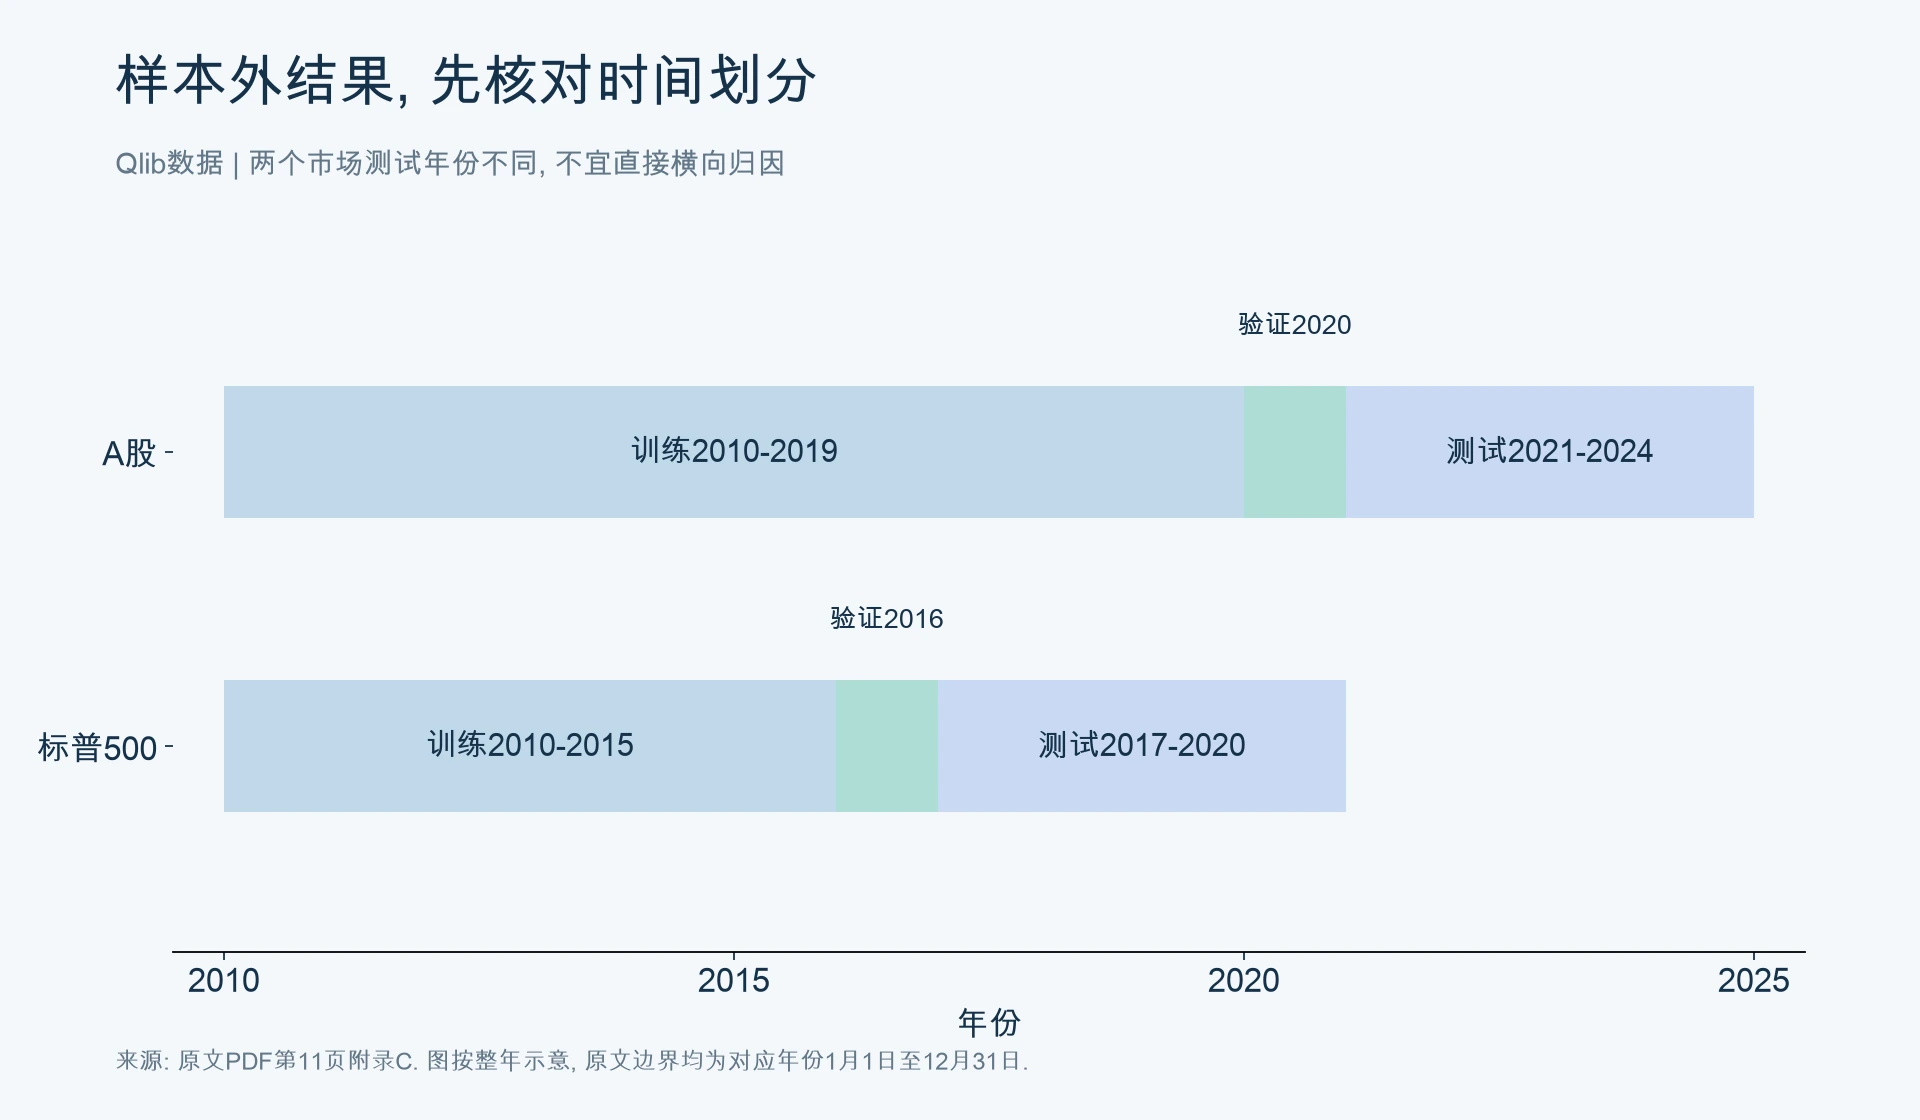
A股训练期为2010年至2019年, 验证期为2020年, 测试期为2021年至2024年. 标普500数据的训练期为2010年至2015年, 验证期为2016年, 测试期为2017年至2020年. 两个市场的测试区间不同, 因此不能把分数差异全部归因于市场本身.
附录E报告, 排名稳定性RRE与年化换手存在负向关系, 单变量回归的R平方为0.815. 这支持将它视作交易活跃度的一个代理指标. 但相关关系不意味着把RRE提高一点, 就能按固定比例减少未来成本. 实际换手还取决于持仓构造与调仓规则.
作者还按PFS是否达到0.9分组, 发现高分组的最大回撤较低, 两种统计检验的p值均报告为0.0001. 这是一组历史样本中的比较结果. 0.9不是市场通用的入库阈值, 更不能作为未来回撤的承诺.
效率实验使用20个进程处理可并行部分, 报告相对评估时间减少超过25%. 这个结论支持把诊断前移, 不能读成25倍加速. 具体能节约多少, 还与数据规模、实现、模型调用和硬件有关.
图按时间保留训练验证测试区间
按时间保留训练验证测试区间
值得借鉴的流程, 也有需要核对的口径
在实际因子工程中, 可以先把这套方法用成诊断表. 对同一批候选, 同时展示预测分、排序变化、抗扰动表现与解释记录, 将集合冗余放在入库或组合阶段检查. 不必急着压成一个总分.
总分会隐藏取舍. 一个极稳定却几乎没有预测信息的信号, 不应因为低换手就自动入库; 一个金融解释漂亮的表达式, 也可能只是在历史数据上碰巧成立.
读原文还要注意几处口径. 表2列出的AlphaGen抗扰动分0.997高于GP的0.983, 因此不宜照搬正文关于GP该项最高的概括. PPS的公式明确是IC与RankIC的权重组合, 调整其中的beta, 不能解释成直接调整鲁棒性权重. 多样性首先针对信号集合定义, 合并到候选评分时也需要说明计算层级.
这些问题不抹去多维评估的价值, 但提醒研究者: 采用一个名字完整的框架之前, 仍应逐项核对定义、数据处理和实现.
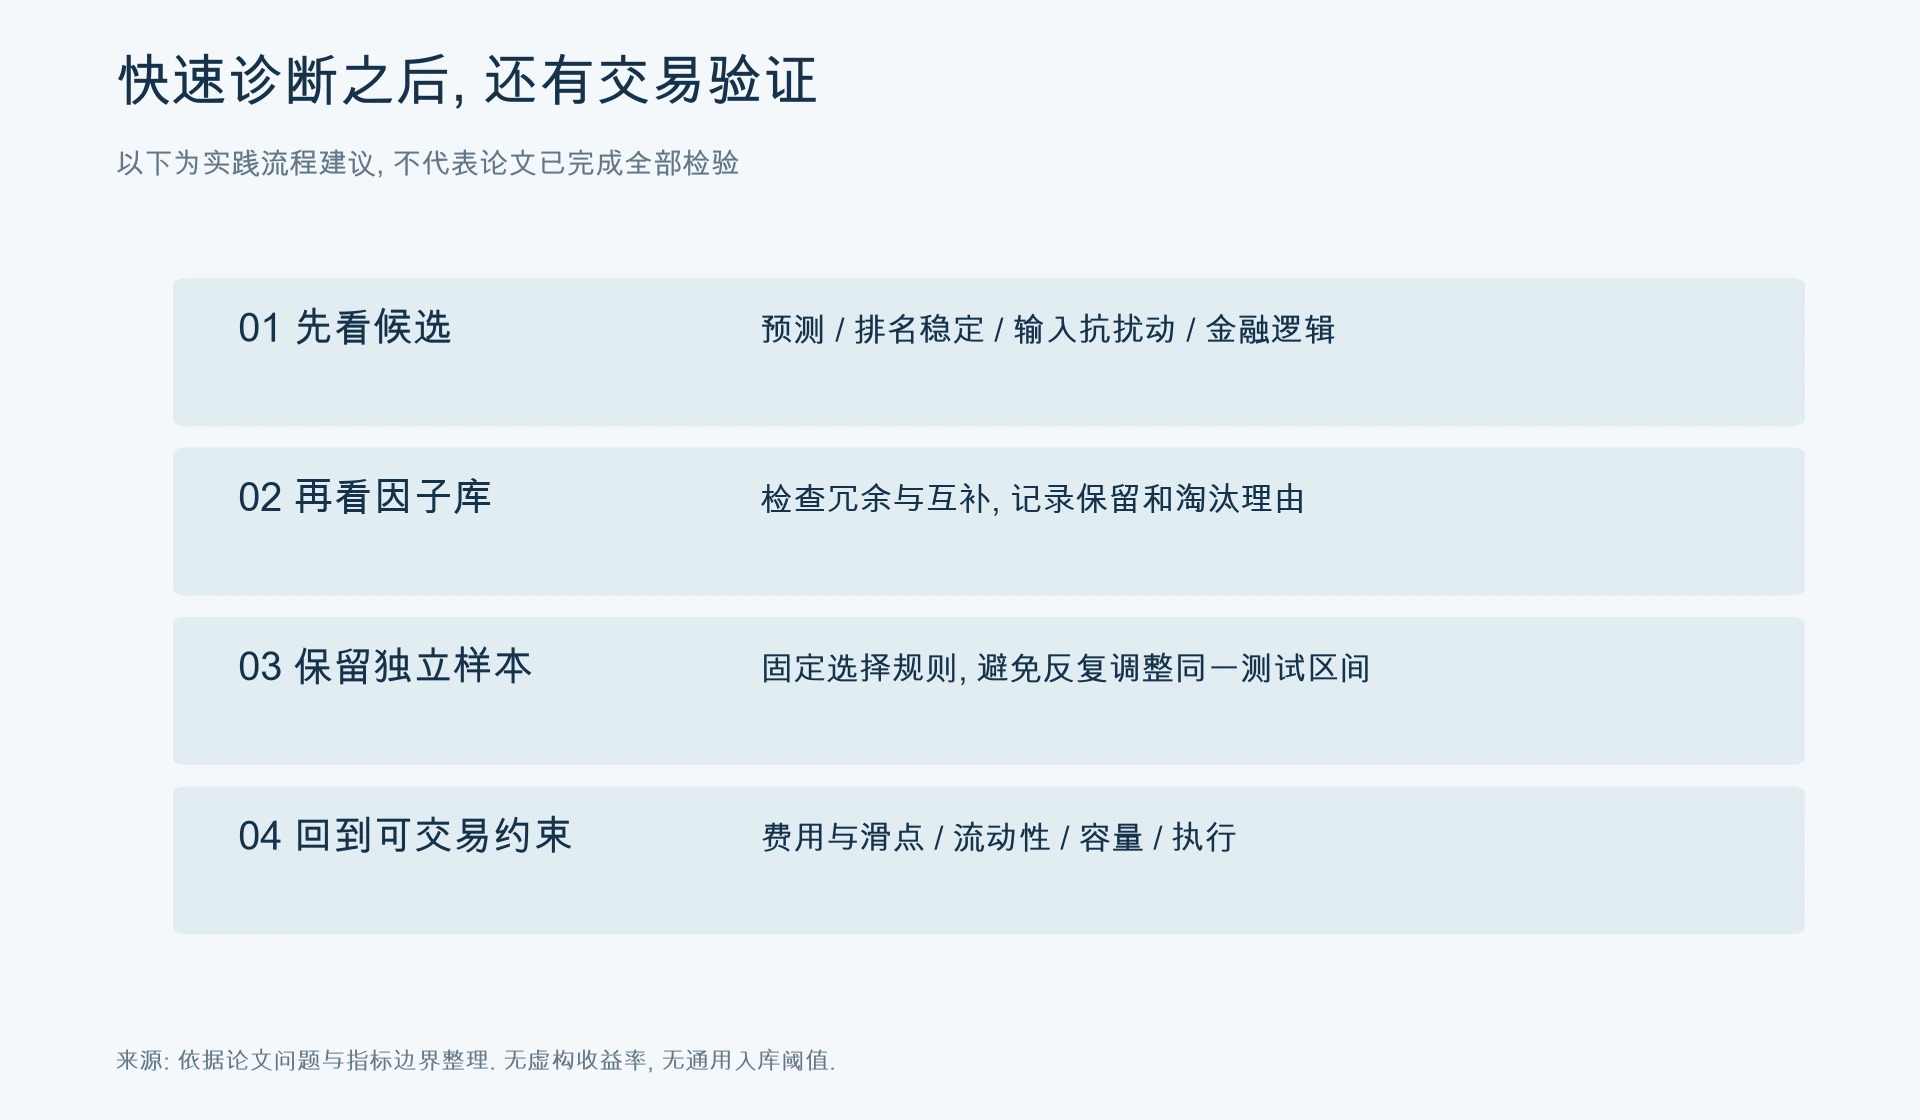
通过前置筛选后, 候选还需要独立的时间区间检验、包含费用与滑点的组合回测, 以及对流动性、容量和执行约束的检查. 反复查看同一个测试集再调整规则, 也会让测试集逐渐变成训练材料. 这些是实践中的后续要求, 不是AlphaEval已经证明解决的问题.
对于一次要处理大量公式的团队, 这篇论文的用处很具体: 更快分辨哪些候选值得继续花时间, 并记录留下或淘汰的理由. 是否值得交易, 仍要放回真实的约束中检验.
图从快速诊断走到交易验证
从快速诊断走到交易验证
论文与说明
Hongjun Ding等, AlphaEval: A Comprehensive and Efficient Evaluation Framework for Formula Alpha Mining. 本文依据arXiv:2508.13174v2, 2026年6月2日版本, 共12页; DOI: 10.1145/3770855.3817727.
论文: https://arxiv.org/abs/2508.13174v2
关键定位: 第4至5页指标定义; 第6页表2; 第8页效率实验; 第11页附录C与E; 第12页附录H. 配图按原文数值重绘或作机制说明, 未重建论文收益曲线.
本文由AI辅助整理与制图, 经原文数字及口径核对. 内容仅供学习研究, 不构成投资建议. 历史结果不代表未来收益.
资料与阅读边界
本文为方法讨论与教学说明。文中示例不等于经独立验证的收益实证;如需具体数据、计算口径或资料来源,可通过官方渠道提出核对请求。
历史结果不代表未来表现。使用前请检查数据时间边界、样本独立性、交易成本及适用条件。
关键结论
- 预测分、排名稳定和抗扰动表现需要分别观察.
- 逻辑分与多样性不能单独证明因子有价值.
- 快速诊断用于前置筛选, 仍需独立样本与可交易约束检验.