科学评估组合决策预测评价机器学习信息时点
组合收益变好,靠的是模型还是信息?
一篇组合优化研究发现,加入方向正确的观点后,简单模型与LSTM表现接近。但观点由未来均值构造,信息价值和预测能力必须分开验证。
本文要点
观点信息与配置算法的增量应分别验证。
未来均值插值的条件实验不是可执行预测回测。
一个组合模型换成神经网络,收益改善了。研究报告很容易把这归因于模型更强。可如果同时换了输入信息,甚至让模型提前知道了未来市场的一部分,这个判断就需要重新拆开。
《Directionally Correct Views in Portfolio Optimization》提出了一个适合组合研究的问题:当两种模型都得到方向正确的前瞻观点,复杂模型还有多少额外价值?
先说结论的边界。作者在自己的实验里看到,简单的Markowitz组合与端到端LSTM表现接近,扣成本后前者还略好。但这些观点是用评价期已经实现的未来均值构造的,决策当时并不知道。这是一项研究“信息给对了会怎样”的条件实验,没有证明有人能在实盘中生产这些观点。
图信息与模型对组合决策的影响
信息与模型对组合决策的影响
先固定信息,再比较模型
Markowitz方法先估计资产收益的均值与协方差,再决定权重。端到端模型则直接从历史窗口输出组合权重,用组合夏普比率训练,跳过显式预测收益分布的步骤。
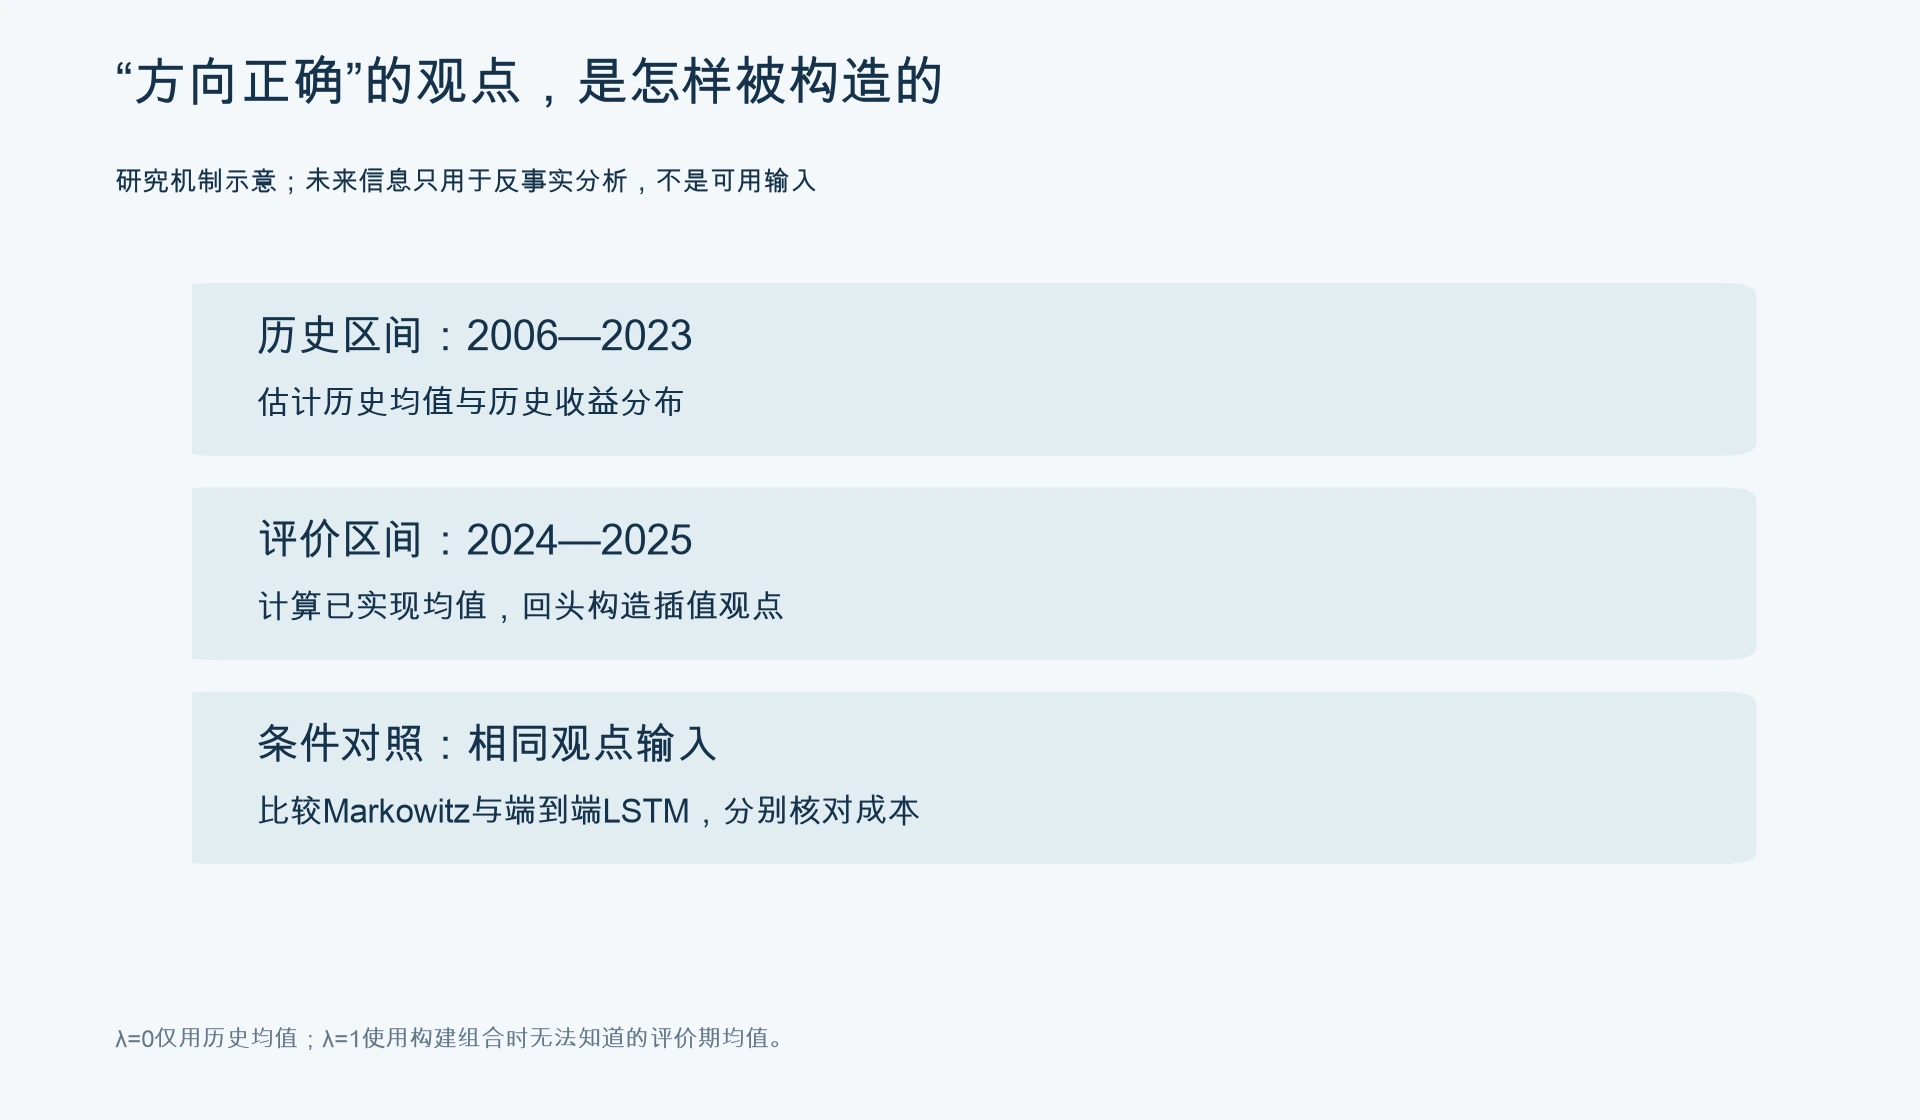
论文给两者施加同一组均值观点。它从2006—2023年的历史均值出发,向2024—2025年的已实现均值逐步插值,用λ表示插值强度。λ=0仅使用历史均值;λ=1对应完全准确的评价期均值,是构建组合时不可得的信息。
λ=0.1尤其不能被读成“专家只有10%的准确率”。它没有统计专家十次判断猜对一次,也不是某个真实预测模型的胜率。它表示沿着已知历史均值与事后未来均值之间的方向移动了十分之一。
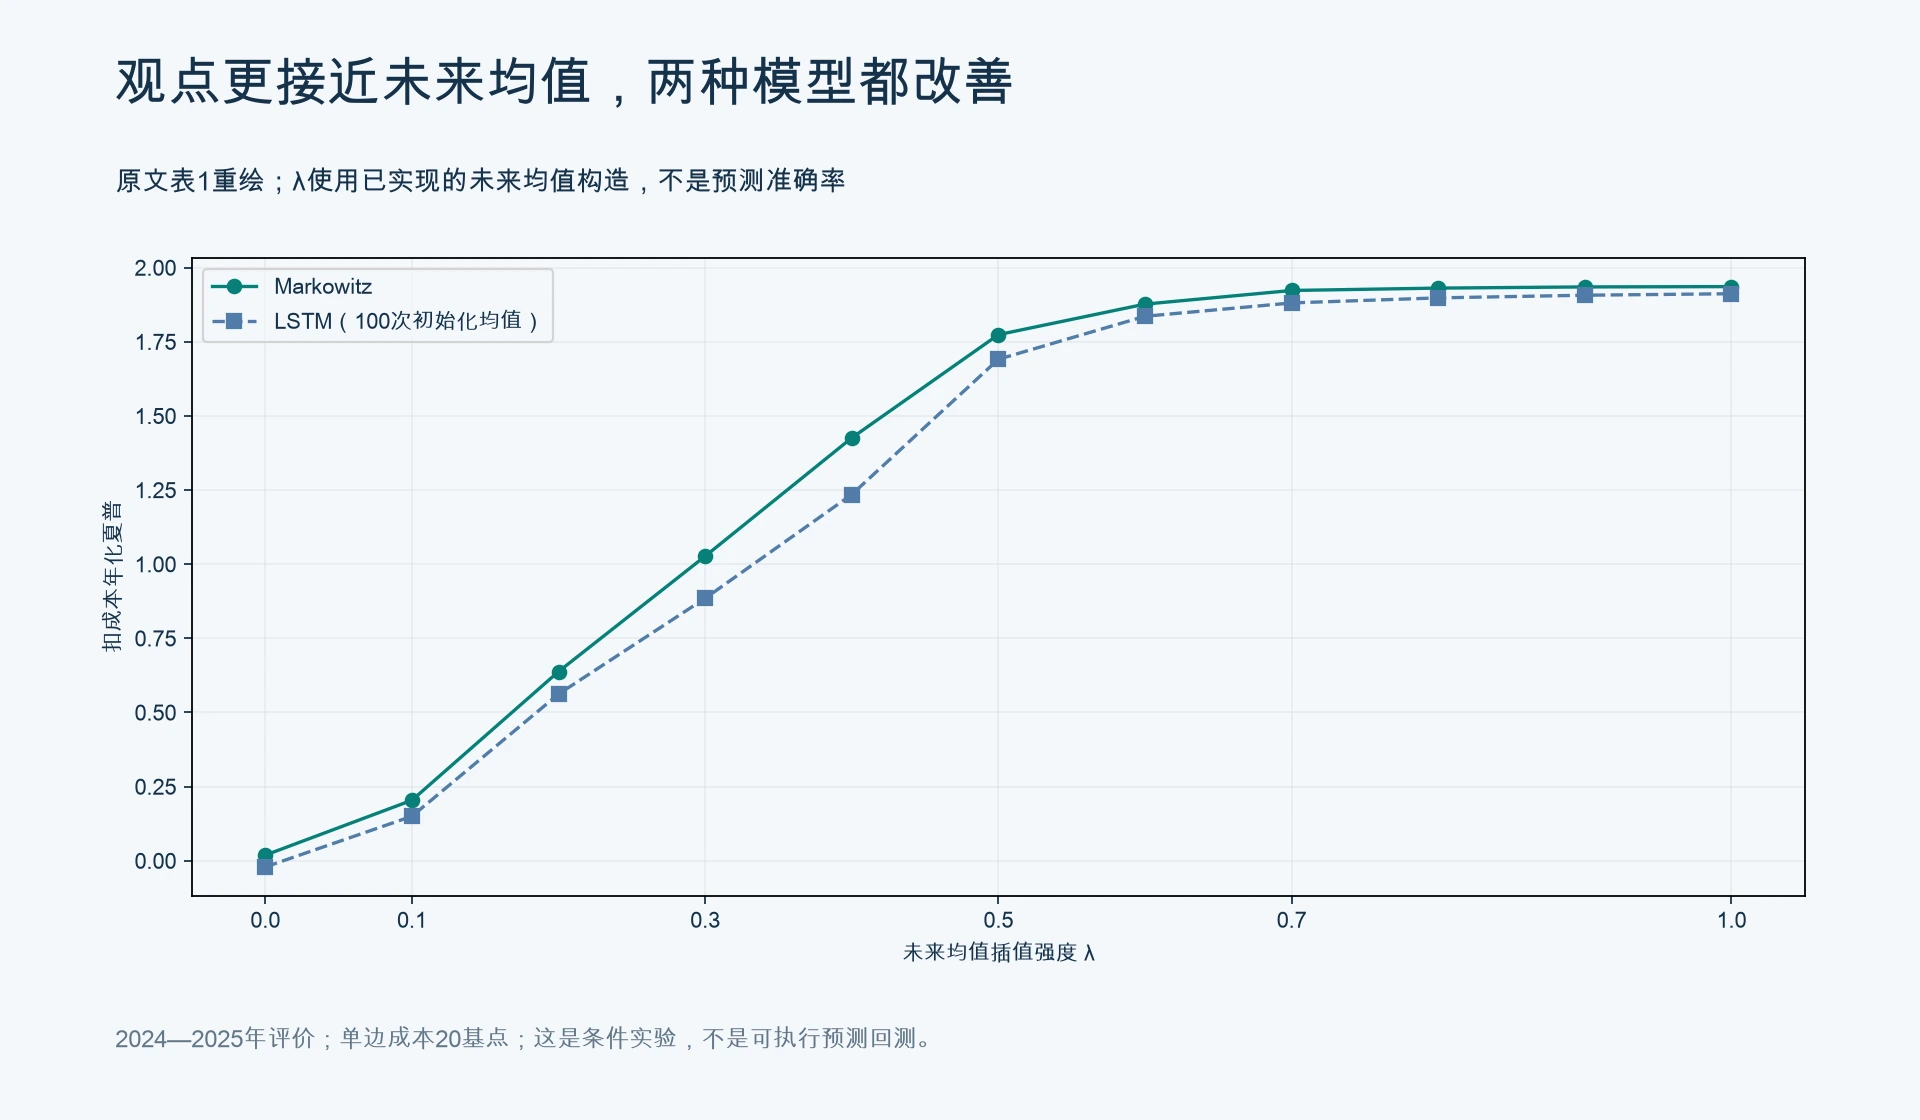
表1中,λ=0时,Markowitz成本后年化夏普为0.019,LSTM为−0.021;λ=0.5时,分别为1.774与1.691。λ=1时,分别为1.936与1.912。LSTM结果是100次随机初始化的均值。
这些数字说明,在这项带有事后信息的实验里,信息条件改变后,两种配置方法都明显改善。它们不是可直接拿去宣传的实盘收益指标,也不能证明简单模型在所有数据上都优于神经网络。
图原表成本后夏普随观点插值变化
原表成本后夏普随观点插值变化
“方向正确”比逐项误差更接近配置问题
论文第2页把夏普损失写成一个角度关系:实际夏普等于最优夏普乘以某个角度的余弦。这个角度经过协方差所定义的风险度量,并非把两组原始收益预测当普通向量画夹角。
直观上,组合在意的是预测最终把权重引向哪里。对所有预测均值作相同的正比例缩放,可能不改变最大夏普组合的方向;某些看似不大的相对预测误差,却可能把资金引向不同资产。单一的预测误差指标,未必足以描述配置结果。
作者还证明,在真实协方差已知且保持相同、插值向量不为零等条件下,均值观点沿特定正确方向改善时,组合夏普不会下降。这是模型中的条件结论。实证部分另加了只做多约束,并用重加权概率估计协方差,不能把理论条件直接等同于实证市场,更不能理解为任意专家观点都能提高收益。
关于曲线形状,原文还区分了接近最优点时的局部凹性与全区间凹性,后者需要额外条件。本文不把“越多信息越好”扩写成普遍的边际收益递减规律。
多调仓,不一定多创造价值
实验使用单层、16个隐藏单元的LSTM,每个λ训练100次随机初始化;报告的单边交易成本为20基点,即0.2%,按交易金额扣除。两种组合都只做多、满仓,Markowitz目标配置固定,LSTM可以每天改变配置。
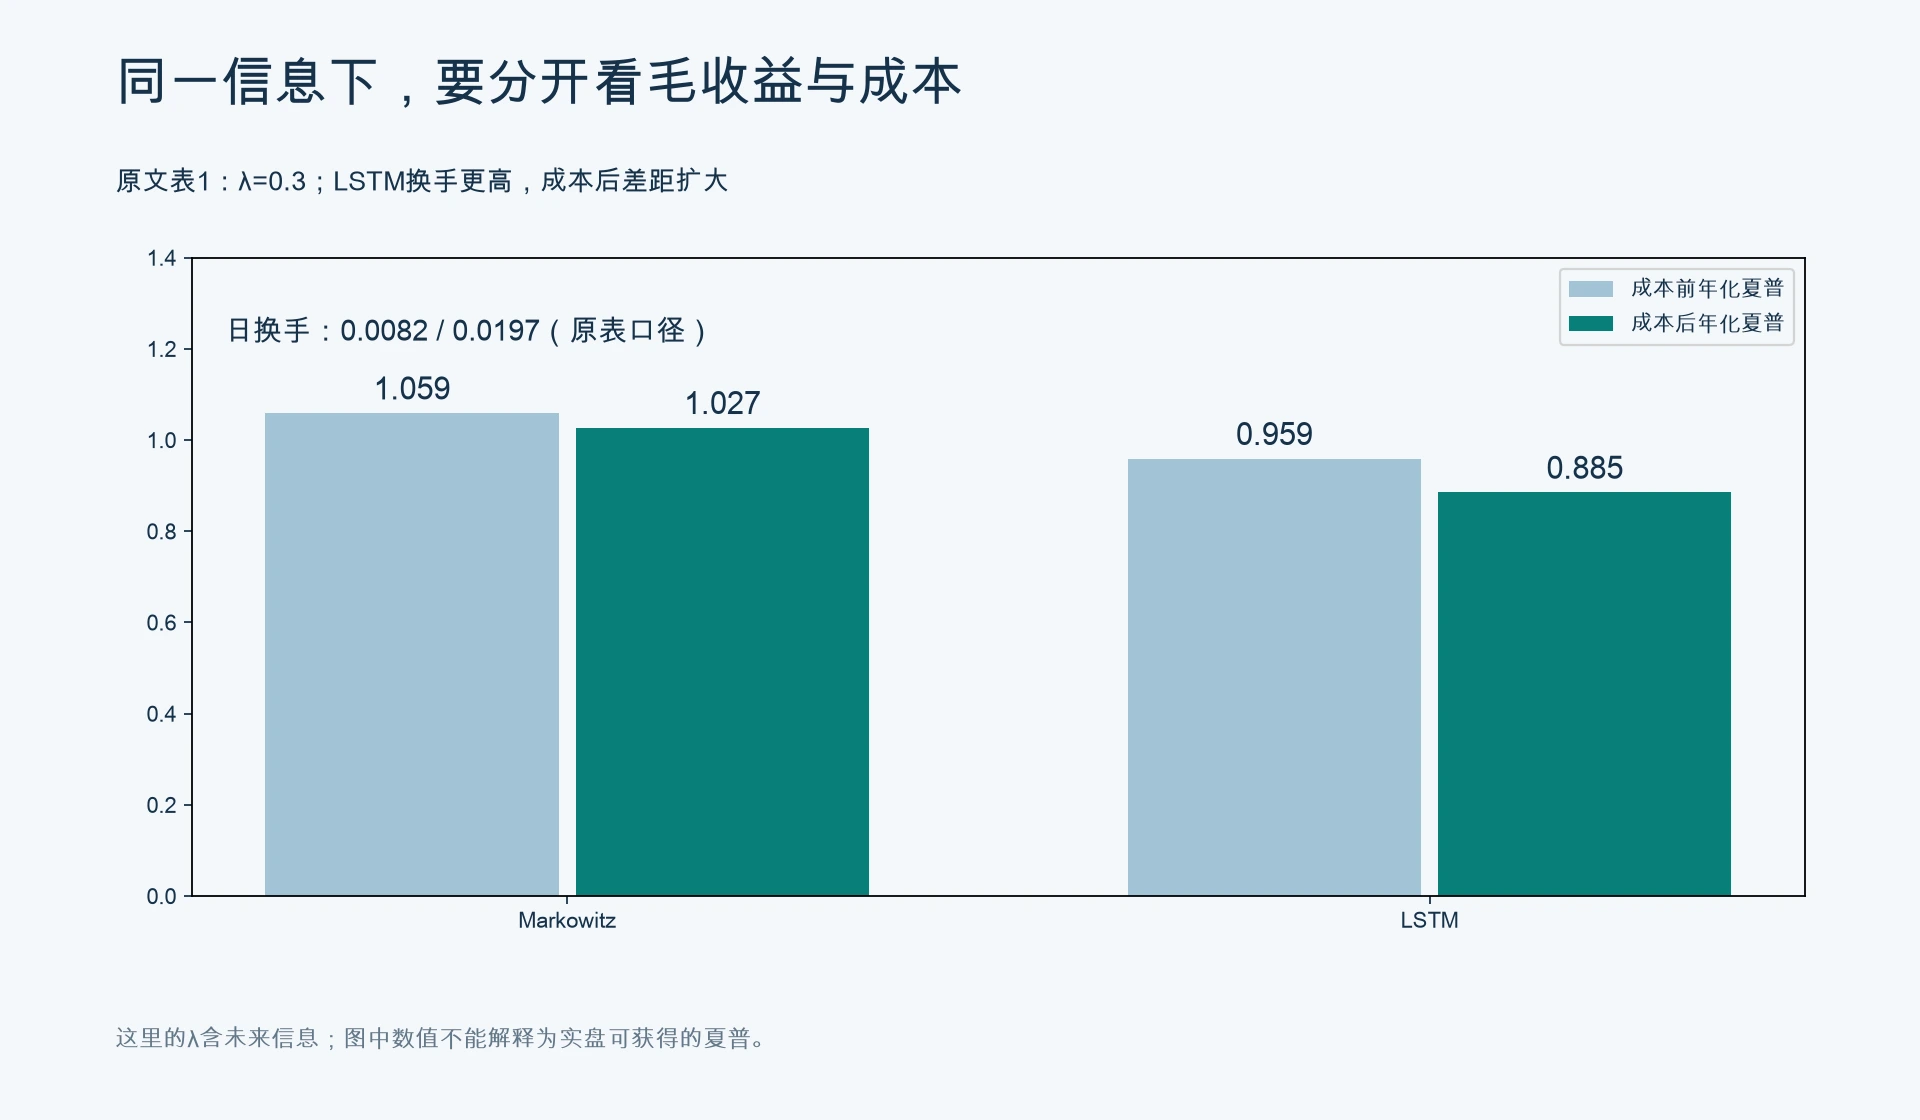
在λ=0.3这一行,Markowitz的成本前年化夏普为1.059,成本后为1.027;LSTM则从0.959降至0.885。原表日换手口径分别为0.0082和0.0197。成本前已有差距,扣成本后进一步扩大,不能把全部差异都归因于交易成本。
这个对照提醒研究者:动态权重只有在带来足够额外收益时才值得支付额外换手。每天输出不同权重,是一种模型行为,不自动构成更强的决策能力。
作者观察到,随着观点越来越接近未来均值,LSTM的配置也逐渐接近固定配置,随机初始化之间的差异收敛。在λ=1时,两类组合都主要集中于BHARTIARTL、MARUTI和SUNPHARMA。信息优势也可能带来持仓集中,并不天然等于风险更分散。
图同一观点条件下的毛收益与成本后对照
同一观点条件下的毛收益与成本后对照
最重要的工作,还在实验之外
论文在结论中明确写道,实际生产这些观点是下一步工作,因为实验构造观点时用了决策当时无法获得的未来信息。
可以把它想成两位司机拿到了同一张更准确的地图,然后比较驾驶方法。两条路线都变好时,先辨别地图的贡献很有必要。但这里的地图有一部分是旅程结束后才画出来的。这个类比不能证明出发时真能拿到它。
资产池也有边界。作者先要求2006—2025年每个交易日都有收盘价,再在合格公司中按2023年底市值选前20家。这种完整面板筛选用到了后续数据可得性,需要留意样本选择与幸存者偏差的可能影响。评价期仅为2024—2025两年,结果不代表其他市场、资产或行情状态。
这不是一场对所有深度学习配置模型的排名。LSTM结构经过探索选择,作者报告其他尝试没有改善;100个随机种子反映的是该结构的初始化波动,不是100个独立市场样本。
图历史信息与事后均值的边界
历史信息与事后均值的边界
怎样把这个问题带回自己的研究
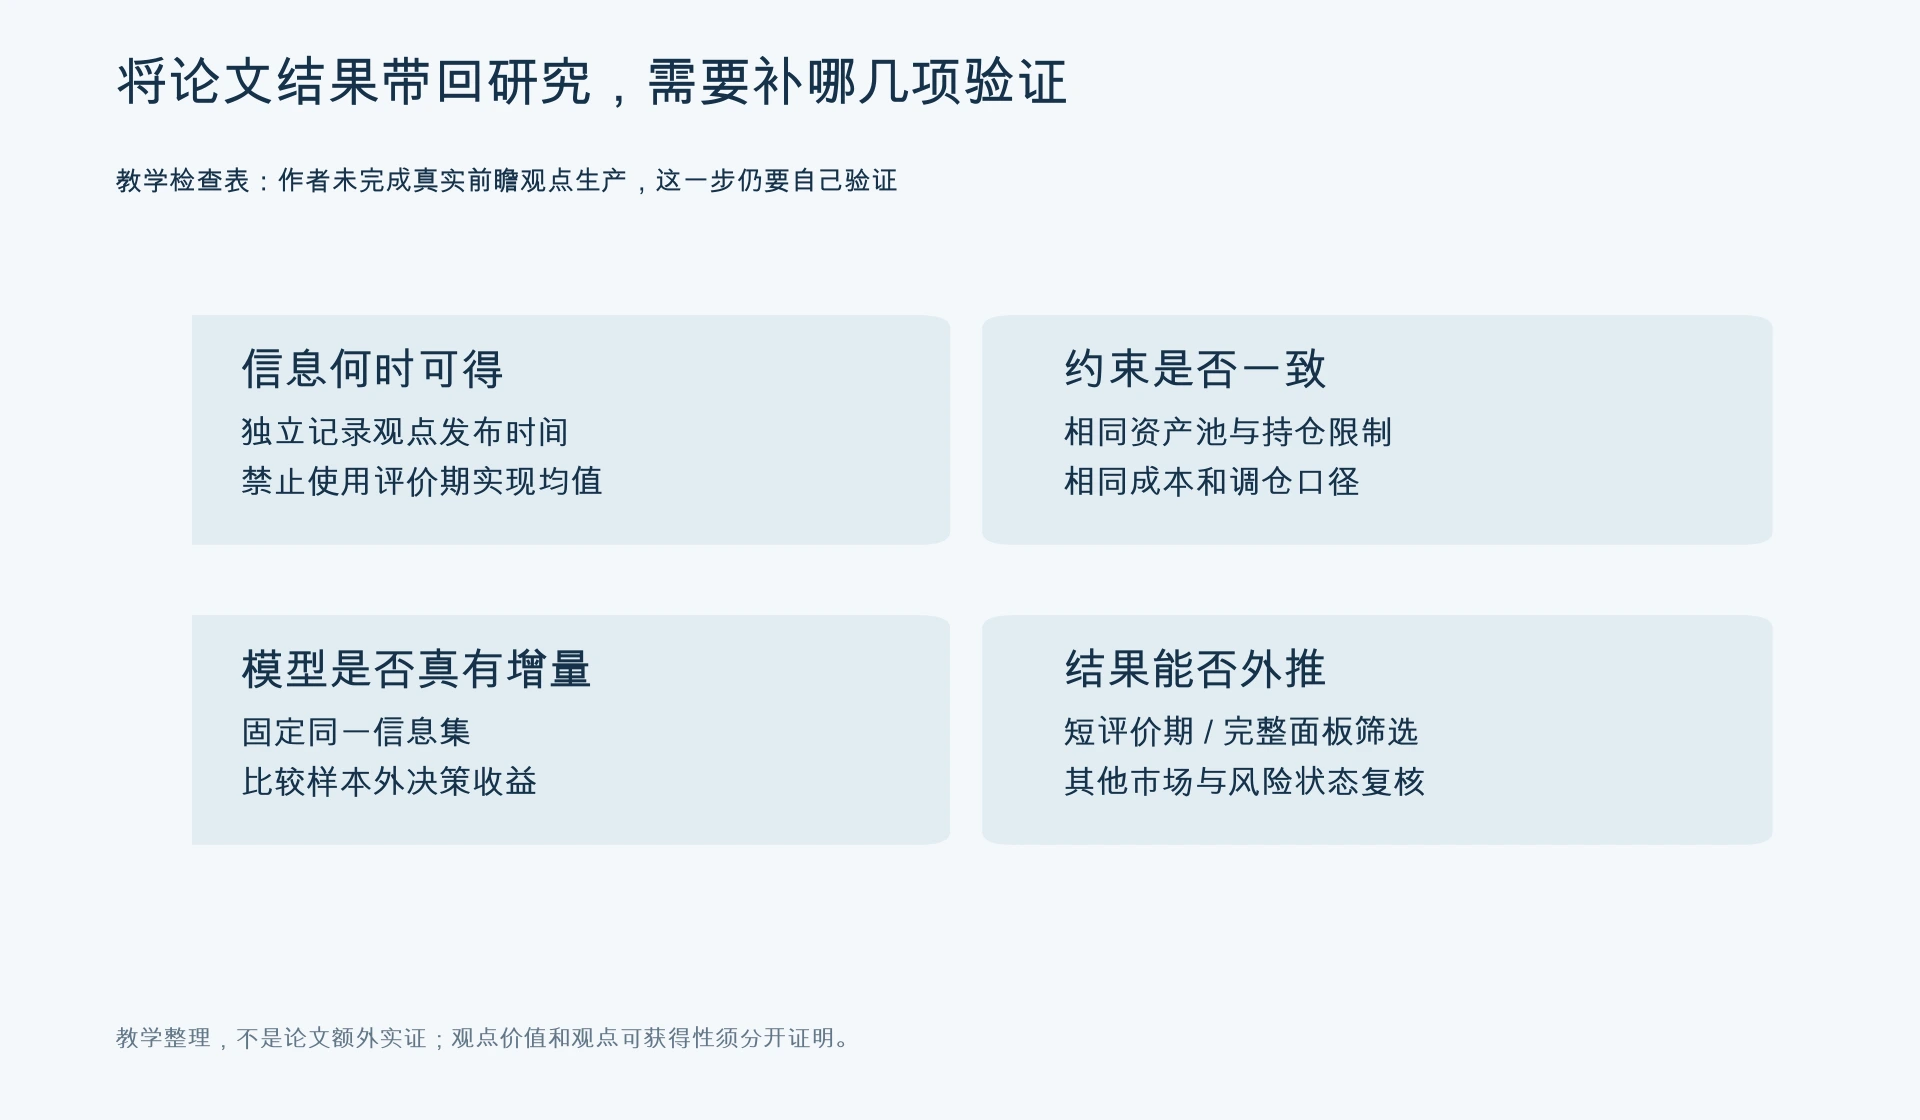
如果要在真实研究中检验观点价值,应先保存观点的生成时间、输入数据版本和发布日期,再检查它在对应决策时刻是否可得。评价期结果只能拿来评分,不能反过来参与观点构造。
接着给简单基准与复杂模型相同的观点、资产池、风险限制、成本和调仓规则,比较成本后样本外结果。若复杂模型的优势只在换了输入后出现,就还不能把改进归给模型结构。
这篇论文值得保留的研究判断是:改善配置,可能先需要改善信息;识别模型价值,要把信息条件固定下来。方向正确的观点从哪里来、能否持续获得,以及用了它之后复杂模型还增加了什么,必须分别给出证据。
来源:Ojas Kumar、Sreejit Dey、Sarvesh R. Iyer、Sandeep Juneja,《Directionally Correct Views in Portfolio Optimization》,arXiv:2610.31074v1,2026年10月预印本。理论见第2—3页,实验设定见第4页,未来信息局限见第5页,资产池见第11页,结果见第13页表1。图表按原文重绘,检查表属于教学整理;本文没有重新运行实证。
本文由AI辅助解读与制图,主要数字及条件已对照原文核查。仅供学习研究,不构成投资建议。条件实验和历史表现均不代表未来可实现收益。
图前瞻观点与组合增量的验证检查表
前瞻观点与组合增量的验证检查表
资料与阅读边界
本文为方法讨论与教学说明。文中示例不等于经独立验证的收益实证;如需具体数据、计算口径或资料来源,可通过官方渠道提出核对请求。
历史结果不代表未来表现。使用前请检查数据时间边界、样本独立性、交易成本及适用条件。
关键结论
- 观点信息与配置算法的增量应分别验证。
- 未来均值插值的条件实验不是可执行预测回测。
- 固定同一信息集、成本与持仓约束再比较简单与复杂模型。