 入门 · 12讲
特征工程OHLCV特征工程技术指标量化输入
从 OHLCV 到特征流水线:量化特征工程到底在做什么
解释第一场公开课里的 OHLCV 与技术指标特征工程主线,帮助学习者理解特征工程不是堆指标,而是搭研究输入流水线。
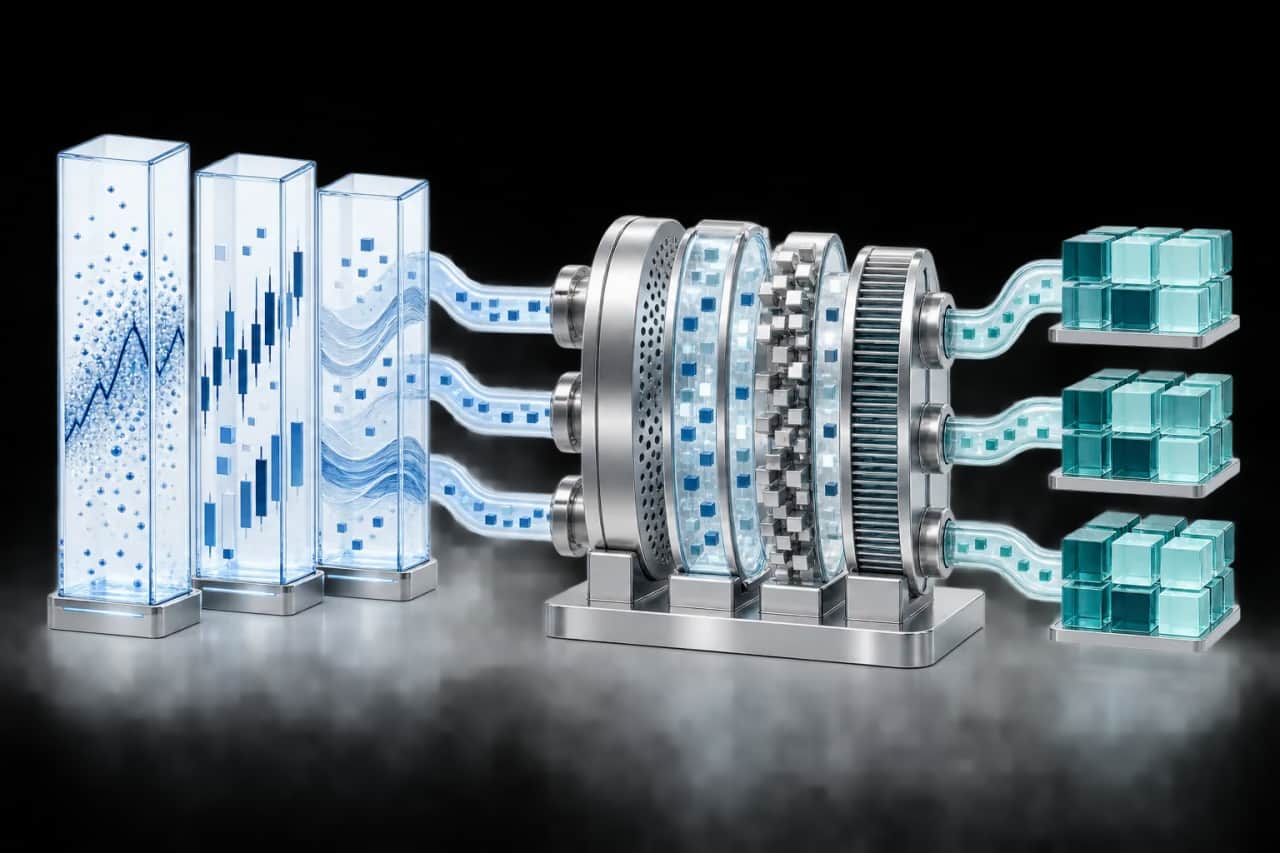
很多初学者做特征工程时,最容易走向一种“指标收集癖”:能想到的都加进去,觉得特征越多越好。但第一场公开课通过 OHLCV 特征和技术指标特征的顺序安排,其实在传递另一种更重要的思路。OHLCV 只是基础原料,真正重要的是你如何把这些原料转成能表达市场状态、价格行为和结构变化的研究输入。
也就是说,特征工程不是统计更多,而是表达更准。某些特征是在描述趋势,某些是在描述波动,某些是在描述成交活跃度,还有些是在描述相对位置与结构关系。把这些角色分清以后,特征工程才真正开始像一条流水线,而不是一锅拼盘。
一条稳的特征流水线,通常要经历四个层次
第一层是原始字段层,比如开高低收量等原始行情数据;第二层是基础派生层,比如收益率、振幅、成交量变化;第三层是结构表达层,比如滚动均值、波动率、动量、趋势偏离;第四层才是模型输入层,也就是经过标准化、去极值、筛选和组合后的特征矩阵。这四层不是形式上的整洁,而是为了让后续研究更容易排障、复用和迁移。
如果没有这种分层,特征工程很快就会变成一堆不可追踪的代码块。未来当模型失真、信号衰减或者需要最小重算时,你会发现自己根本不知道问题出在哪一层。
资料与阅读边界
本文为方法讨论与教学说明。文中示例不等于经独立验证的收益实证;如需具体数据、计算口径或资料来源,可通过官方渠道提出核对请求。
历史结果不代表未来表现。使用前请检查数据时间边界、样本独立性、交易成本及适用条件。
关键结论
- 特征工程的本质是设计输入表达,而不是无止境堆指标
- OHLCV 最终应进入一条分层流水线,而不是直接喂模型
- 分层后的特征工程更利于后续排障、复用和部署迁移
关联课程
如果你想把这篇文章里的方法系统化学习,可以从这些课程继续深入。