大模型量化大模型交易收益归因动量策略
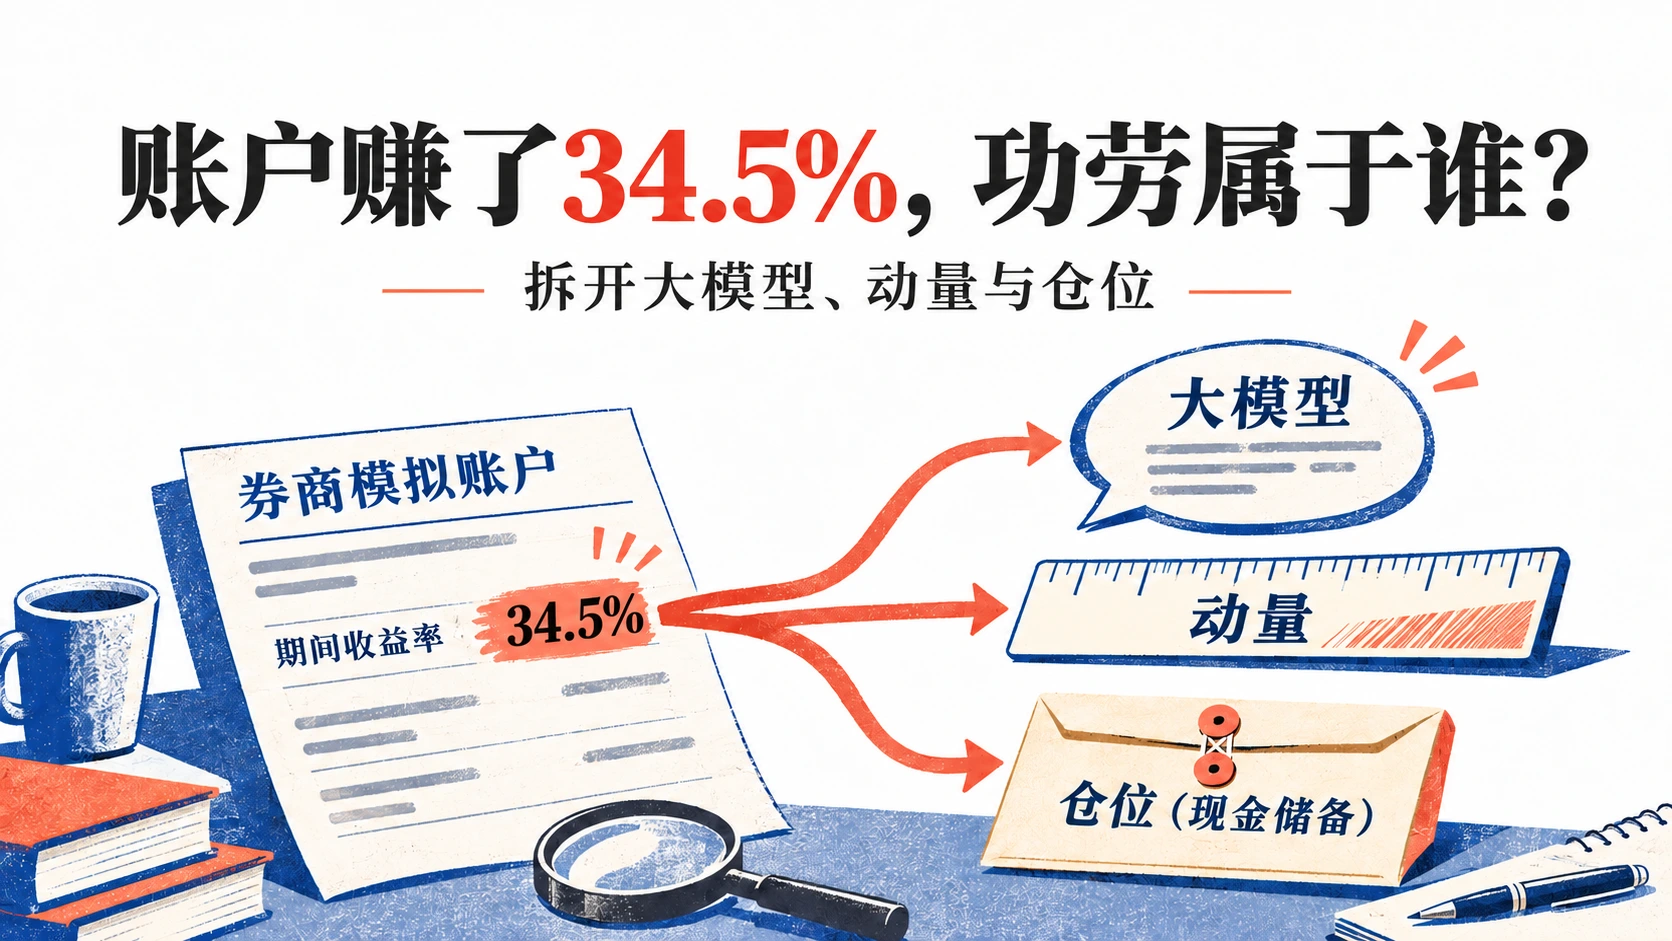
账户赚了34.5%,功劳属于谁?
券商模拟账户、模型重放与固定现金对照,分别能证明什么?
本文要点
34.5%来自确定性回退路径的模拟账户,不能归因于模型。
固定5%现金对照与模型仓位配置的重放终点接近。
一套大模型交易系统,半年左右赚了34.5%,同期SPY上涨14.4%。如果介绍到这里就停下,很容易把这份成绩记在大模型名下。
《Inside the Trading Loop: Markets, Models, and Moves with LLM Agents》提供了一个值得把账翻到底的案例。最关键的信息没有藏在复杂公式里:论文明确写道,这个券商记录的模拟账户,在整个观察期使用的是确定性回退规则。大模型参与决策的效果,来自另外一组事后重放。
账户确实有成绩,模型是否带来了增量,则要另找证据。这篇解读沿着资金和指令走一遍,看看两者在哪里分开,又在哪里容易被混在一起。
图概念示意
账户收益与模型贡献分开验收
先把账户单放在桌上
记录覆盖2026年3月11日至8月28日,以纽约交易日期对齐,初始资金10万美元。模拟账户收益34.5%,SPY为14.4%,QQQ为18.2%。这里没有真实资金交易,也没有多个独立市场周期。(第6—7页)
回撤让这张成绩单换了一种面貌。账户最大回撤26.8%,SPY为6.3%;按零无风险利率计算的夏普,账户1.46,SPY为2.10。收益终点较高,同时承受了更深的下跌。不能把“跑赢指数”顺手写成“风险调整后也更好”。(第37页,表22)
更重要的是,当时运行的是回退路径。这意味着,34.5%能够描述这套组合引擎在该窗口的表现,却不能证明模型读新闻创造了这笔收益。论文在图1、图4和评估协议中都交代了这一点。
顺着一笔目标仓位往回找
系统先用一个月和三个月的动量给股票排序,目标持有十只。后续版本还给已有持仓设置保留缓冲:只要排名仍在前十五,就有机会继续留下。股票名单的主导者是这些规则。
进入名单之后,权重偏好由动量排名值和综合评分共同决定,公式是0.95乘排名值,加上0.05乘综合评分归一化后的平方,再经投资比例缩放、单股上限和再分配处理。0.95与0.05是设计系数,不能据此声称“95%的收益来自动量、5%来自模型”。(第3—4页)
公司新闻分析师提供分数和置信度;宏观分析师提供分数和立场。协调器是固定软件规则,不是一个会自由辩论的智能体。它读哪些字段、允许字段改变什么,事先写在接口里。模型的长篇解释不能越过接口,直接换掉选股名单。
这给研究者留下了一个清楚的实验对象:同样一段分析,放在选股之前、放在权重微调处,或交给现金配置规则,影响范围完全不同。评估模型之前,先看它实际拥有哪一项权限,比数系统里有几个智能体更有用。
一条5%现金规则,成了很强的对手
作者重放了三种配置。L0不用模型,走回退分数;L1让模型评分进入既定接口;L2进一步允许宏观立场直接决定现金目标。
同交易时段的重建结果分别为56.38%、55.54%和58.72%。L1没有高于L0,L2高出2.34个百分点。不过,这组数字属于重建实验,不能接在前面34.5%的账户曲线上。(第37页,表23—24)
L2看起来较好的一个解释,是它经常选择更高的股票敞口。119个日期中,113天的目标现金为5%。作者于是加了一条很朴素的规则:不用模型,始终保留5%现金,股票评分沿用基线。这个对照收益58.95%,与L2的58.72%接近。
这条对照不是事后挑出收益最高的现金比例:5%用来匹配模型最常选择的动作。论文也保留了其他现金配置,其中固定0%现金的同阶段重放收益为61.32%。因此,单看“L2排在三个主配置第一”会漏掉很有解释力的参照。
但两个终点接近,也不能证明模型绝对无用。固定现金与L2的股票输入和可选动作并不完全相同。相对L0的配对区间也很宽:L2的2.34个百分点差异,对应95%配对日期区间为−3.10至15.58个百分点,跨过零。(表24)
在这份材料允许的范围内,更稳妥的判断是:更高股票敞口仍是一个合理解释,模型独有的信息价值尚未被清楚分离。
把交易推迟一天,收益更高了——先别庆祝
原始重放有一处时间错位:部分输入取自当天较晚的盘中快照,模拟成交却统一放在开盘。这会让交易用到当时还拿不到的信息。
作者把评估整体推迟到下一交易日,每条策略沿着自己的持仓路径重新运行。L0、L1、L2的收益变为72.01%、71.05%、78.30%;固定5%现金为77.14%。(第6、36—37页)
这说明结果对评估时点和持仓反馈相当敏感。它没有证明“隔天交易更赚钱”。延迟同时改变了信号年龄、买卖时点和后续持仓,不能看作只修正了一项成交价。
其他限制也还在:历史原始新闻没有完整留存,重建用了按发布时间过滤的替代新闻;模型回复在大多数决策日期之后才收集,给新闻加上历史时间戳,并不能让模型忘掉后来学到的事实。部分价格档案和策略历史缺失,早期版本可以使用保证金,重放除名义交易成本外也没有加入融资费用。
这些限制决定了重放的用途:它能帮助研究接口怎样改变决策,尚不能作为可部署收益的证明。
真正让我愿意留下的,是接口实验
论文还有一组比收益榜更具体的结果。固定回复预算下,新闻条目较多时,完整格式出现解析失败:11—15条新闻的组别为29/300,16—20条为63/300;删除部分解释字段的短格式,在对应实验中均为0/300。(第11页,图9)
短回复确实更容易被程序读取,但推荐本身也变了。两次原始回复的宏观立场差异为7/114,原格式与短格式之间为57/117。分母不同,不能简单相减当作统一误差率;它们共同提醒我们,缩短提示词不是纯粹的传输优化。
另一个实验按宏观分数距离现金门槛有多近来决定何时调用模型。用前60个日期校准门槛,在后59个日期中,选择约68%的日期,覆盖了完整顾问配置约98%的配置差异。(第10页,图8)
这里的98%是配置差异覆盖,不是收益保留率,也不是盈利准确率。它提供了一条值得前瞻测试的调用策略:当模型输出有机会让规则跨过决策门槛时再花计算资源。省下调用以后会错过什么交易、账户路径如何改变,仍要另外验收。
如果由我维护这类系统,下一次实验会把每次决策的信息可用时点、模型或回退来源、目标现金、实际成交和下一次持仓一起记录。还会留着固定现金这个便宜对手,让它在同样的时间、成本和风险约束下竞争。这是本文提出的研究建议,不是论文已经完成的前瞻验证。
一份券商模拟账户记录,比一张无出处的收益截图有价值。但当系统由选股规则、模型报告、现金政策和执行逻辑共同组成,功劳需要逐项核对。这篇论文值得读的地方,正是它提供了足够多的对照,让我们有机会把最吸引人的数字从大模型的名字旁边暂时移开,再问一次:哪一个决策,确实因为模型而变得更好?
来源:Renee Jia、Di Mu、Yao Yu、Tianrui Liu,Inside the Trading Loop: Markets, Models, and Moves with LLM Agents,arXiv:2611.11657v1,2026-11-08。本文依据本地37页版本核对,数字为作者报告值,未独立复现实验。论文:https://arxiv.org/abs/2611.11657 。
资料与阅读边界
本文为方法讨论与教学说明。文中示例不等于经独立验证的收益实证;如需具体数据、计算口径或资料来源,可通过官方渠道提出核对请求。
历史结果不代表未来表现。使用前请检查数据时间边界、样本独立性、交易成本及适用条件。
关键结论
- 34.5%来自确定性回退路径的模拟账户,不能归因于模型。
- 固定5%现金对照与模型仓位配置的重放终点接近。
- 时间一致性、配置权限和接口可靠性需要分别验收。