科学评估组合优化估计误差厚尾风险科学评估
组合风险更低,估计就更可信吗?
均值方差模型只使用前两个矩,但估计误差可能受到四阶矩影响。结合一篇新论文,看清样本内风险、厚尾与稳健优化的边界。
本文要点
样本内最优目标值不能替代样本权重的真实风险或样本外交易表现.
均值方差模型的估计波动可能受四阶矩影响, 正态极限有适用条件.
把历史收益交给优化器,得到一组权重,再看到一个更小的组合方差,很容易产生一个判断:风险已经被压下来了。
但这个数有两层含义。它可能说明,在这份样本和这套约束里,优化器找到了更好的配置;它也可能带着参数估计和反复选择造成的乐观。仅凭最终目标值,很难把两者分开。
Zhaolin Hu的《Mean-Variance Portfolio Selection: Statistical Properties and Distributionally Robust Optimization》讨论了一个容易被忽视的问题:模型只用到均值与协方差,估计结果的波动却可能需要看到收益分布的第四阶矩。文章还把分布稳健优化写成更便于求解的形式,但没有声称证明了实盘收益提升。
图组合风险更低估计就更可信吗
组合风险更低估计就更可信吗
优化器输出的低风险,先属于这份样本
均值方差组合的一种常见写法,是在期望收益达到给定门槛的前提下,寻找方差最小的权重。实际使用时,真实均值和协方差通常未知,需要由历史数据估计,再代入模型。
于是,输入数据的误差不仅会影响风险数字,也会影响权重,以及某个组合是否满足收益门槛。求解器把当前问题算得再精确,也没有替研究者解决输入是否可靠的问题。
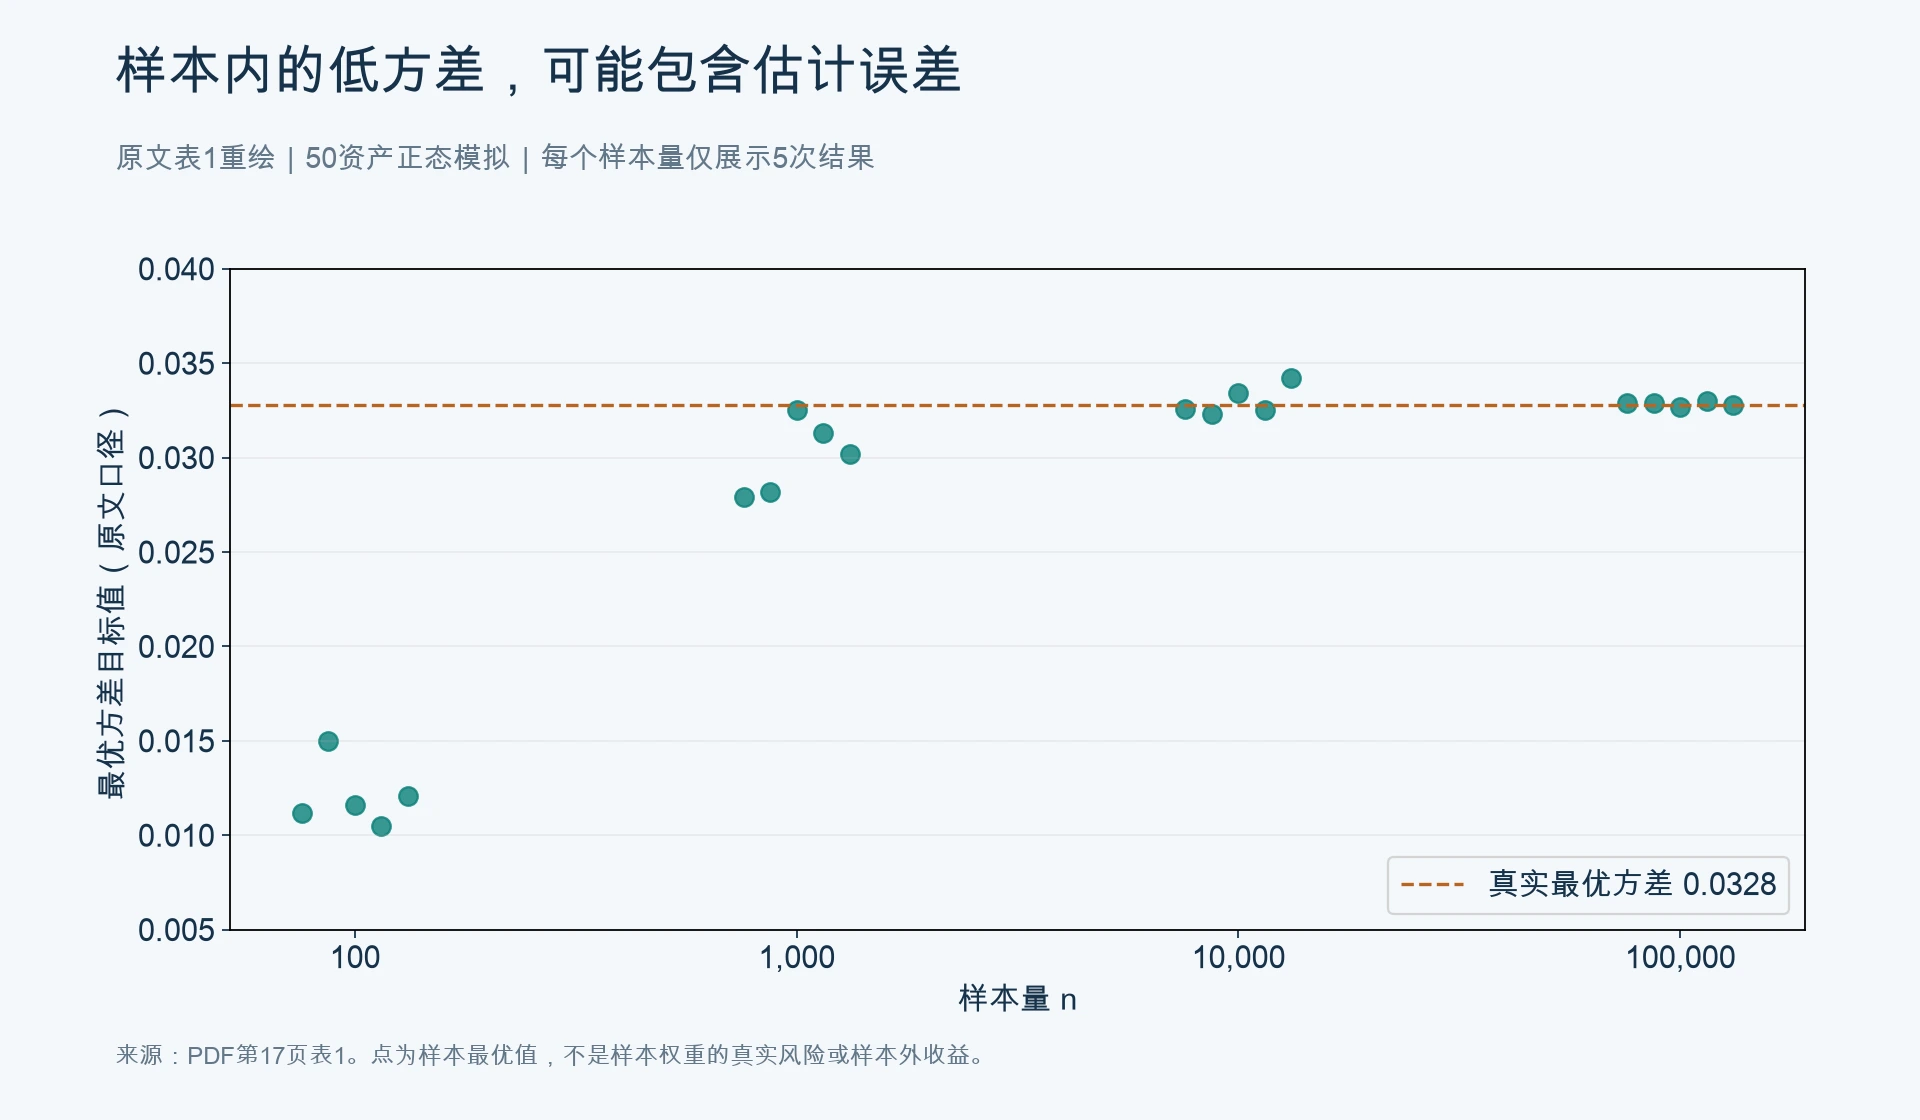
论文第17页给出一个50资产的正态分布模拟。资产之间的两两相关系数设为0.35,作者能够计算真实模型的最优值,再与有限样本估计出来的最优值比较。
表1中的真实最优方差为0.0328。样本量只有100时,五次典型展示分别得到0.0112、0.0150、0.0116、0.0105和0.0121。第一项比真实最优值低约65.9%,这个比例是依表内数字计算的差异,不是风险控制带来的收益。
这里必须区分三个量:样本内估出来的最优目标值、真实分布下的最优目标值,以及把样本权重拿到新数据上的表现。表1比较前两个,没有直接报告第三个。不能把0.0112写成这个组合在真实市场里已经实现的风险。
随着样本增加,表中展示值逐渐靠近0.0328。到10万个观测时,五项落在0.0327至0.0330之间。但这是设定明确的合成实验,不能据此给真实市场规定一个通用的最低样本量。
图表1不同样本量的五次展示
表1不同样本量的五次展示
模型只看两个矩,误差为什么会看到第四个
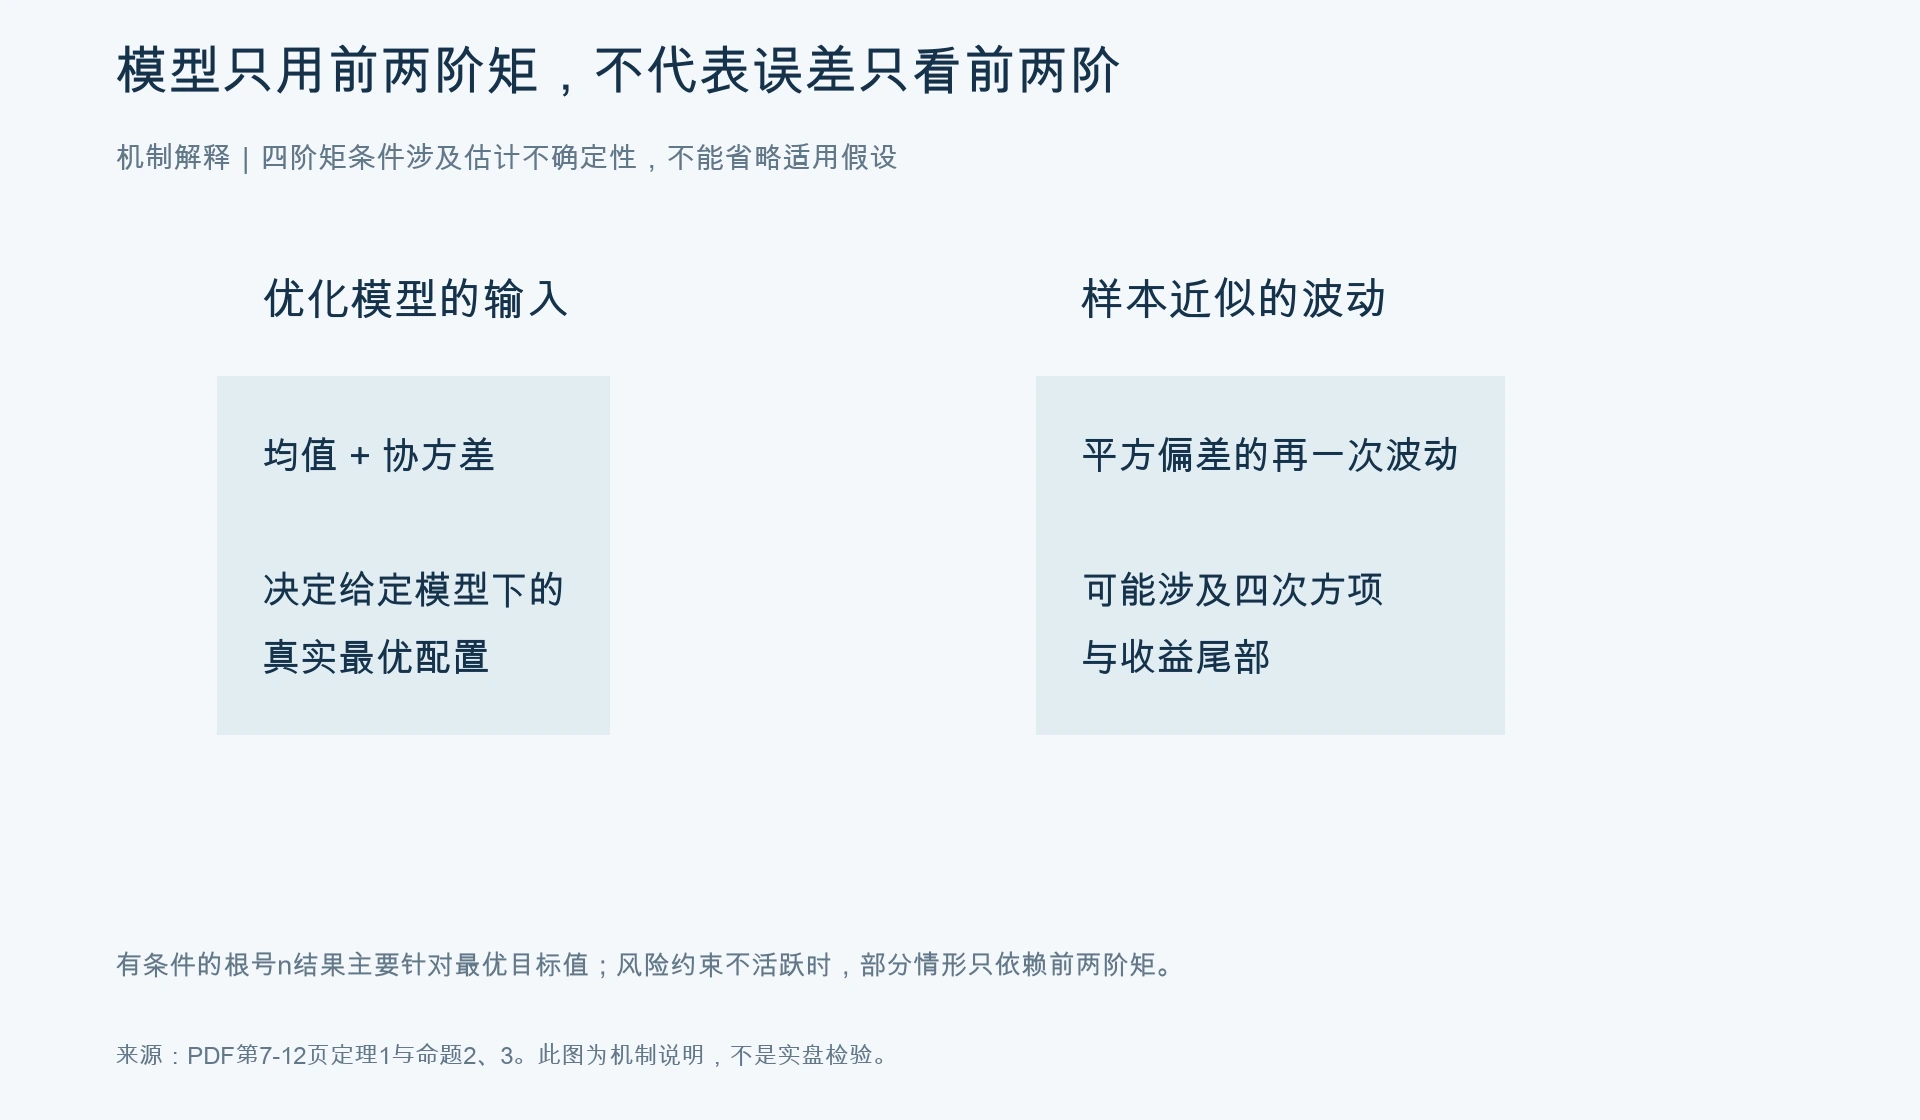
均值刻画平均水平,协方差刻画波动与共同变化。求解真实的均值方差模型,输入这两项就足够了。
估计不确定性是另一个问题。方差本身包含收益偏离均值的平方;再研究这个平方量在重复抽样中有多大波动,就可能遇到四次方项。因此,模型参数需要几阶信息,与参数估计误差需要几阶信息,并不相同。
论文第7页定理1在独立同分布、约束资格条件、支配与矩条件等假设下,讨论样本最优值的一致性与根号n尺度的极限。最优乘子唯一时,才进一步得到相应的正态极限;第12页的另一个模型还涉及最优解集合和乘子集合的唯一性。
这里的根号n结果主要针对最优目标值。不能顺手扩写成每个权重误差都服从同一正态分布,更不能把它理解为交易收益随样本量按某个固定速度提高。
作为尺度直觉,在相关条件和近似适用时,误差量级随1除以根号n下降,想把这类误差量级减半,样本通常需要增加到约四倍。这是由收敛阶推出来的教学解释,不是本文给出的实盘数据预算,也不是有限样本保证。
图模型输入与估计误差的层次
模型输入与估计误差的层次
均值和协方差相同,估计表现仍可能不同
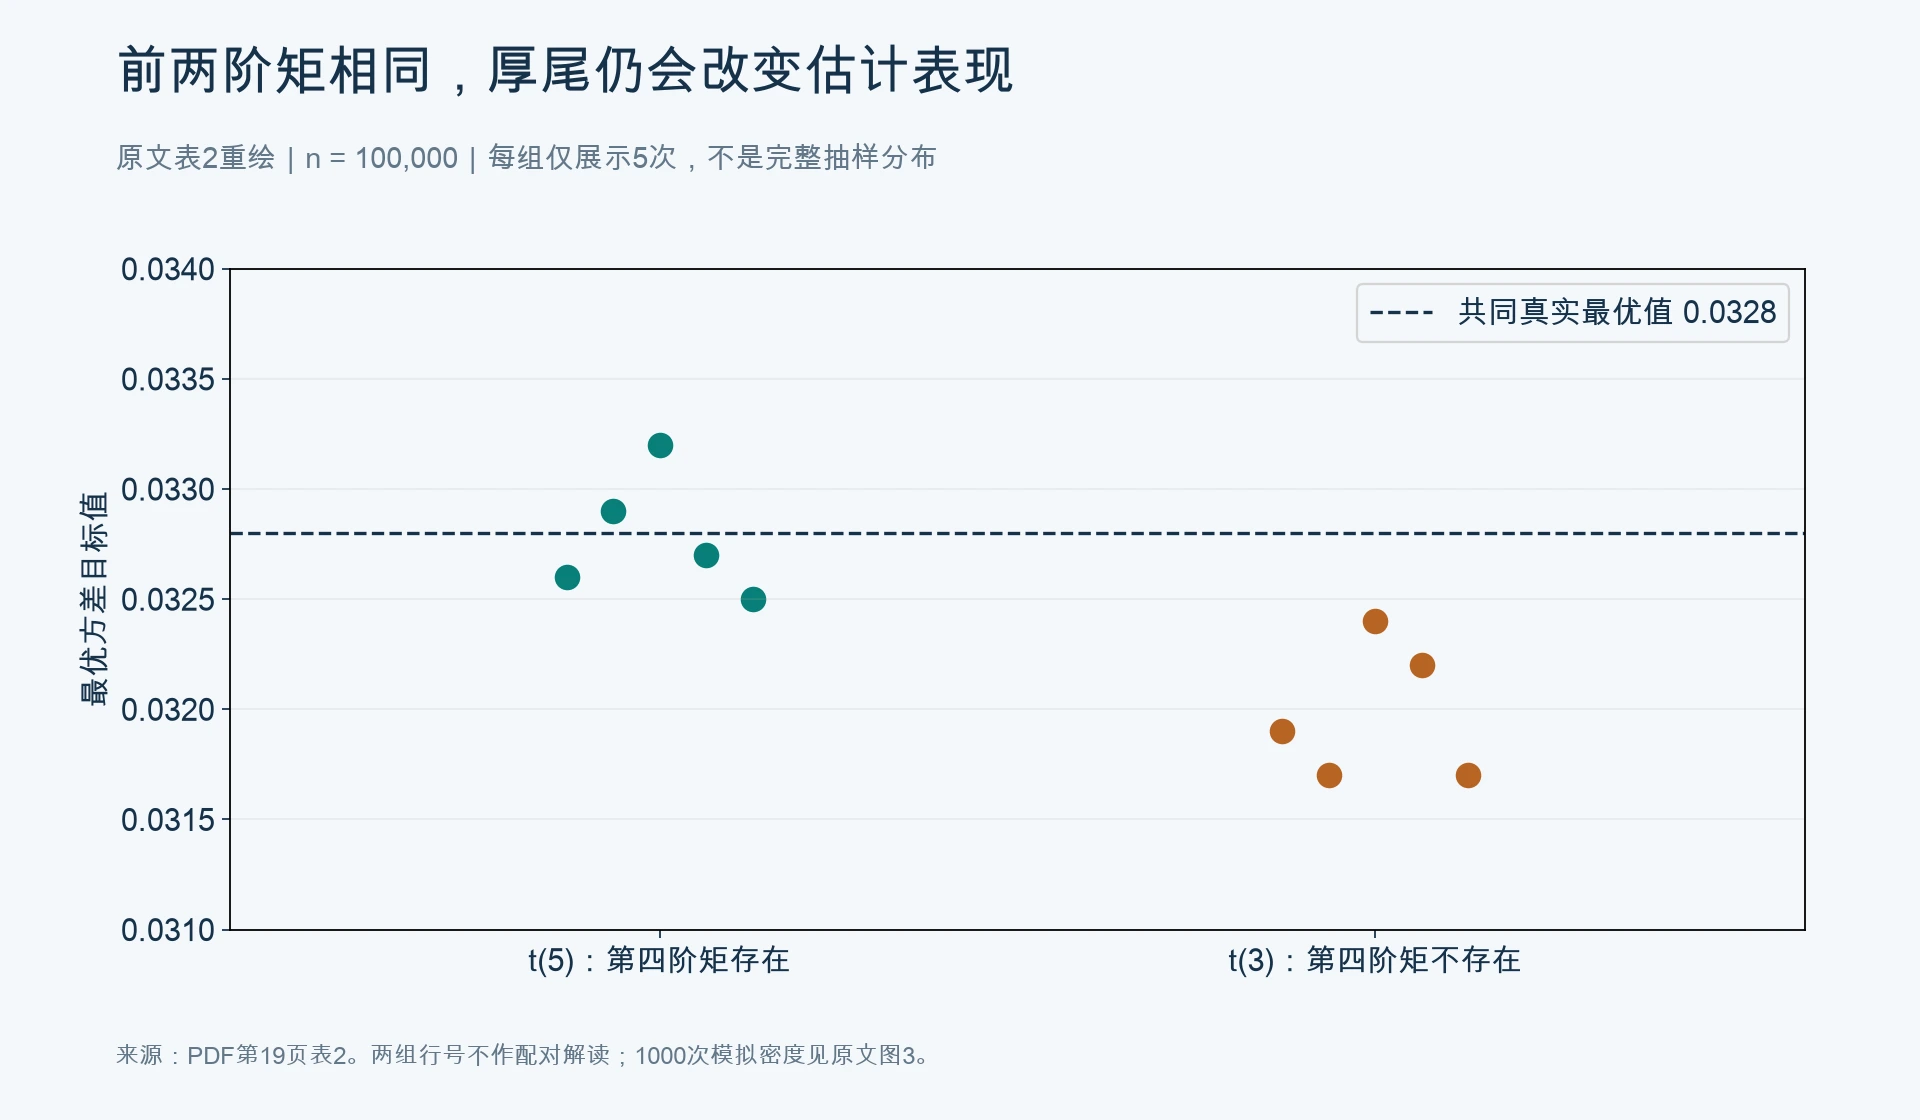
作者接着用不同自由度的t分布构造收益。经过缩放和线性变换,两个实验保持相同均值与协方差,因此真实的均值方差优化问题没有改变。
自由度为5时,第四阶矩存在;自由度为3时,方差仍然存在,但第四阶矩不存在。在后一个设定里,论文所需的某些渐近方差可能不存在,正态近似就失去了原来的依据。
表2在10万个观测下列出的五次典型展示,自由度5的值为0.0326、0.0329、0.0332、0.0327和0.0325;自由度3为0.0319、0.0317、0.0324、0.0322和0.0317。两组真实最优值都是0.0328。
这五项只是论文挑出的展示,不能用来估计整个抽样分布,更不能认为同一行就是成对的同一次随机冲击。作者另外在样本量1万时做了1000次模拟:图3中,自由度3的标准化误差呈非对称与长右尾;自由度5的图形更接近正态。原文没有由此给出自由度3下新的完整极限理论。
对研究流程的提醒很具体:两套资产数据即使看起来具有相近的均值和协方差,极端波动的频率与强度不同,也可能让估计稳定性很不一样。只对照协方差矩阵,未必能解释优化结果为何反复变化。
图相同前两阶矩下的厚尾对照
相同前两阶矩下的厚尾对照
正则化和稳健优化,解决的是不同一层问题
论文讨论在目标中加入凸的权重惩罚,或在可行域中加入范数约束。满足对应条件时,这些做法不改变所讨论的收敛阶,却可以改变最优权重和渐近方差。收敛阶没变,不意味着正则化没有用;反过来,加了正则化,也不意味着厚尾或样本依赖问题自动消失。
分布稳健优化进一步承认,经验分布本身未必可信。它在一个事先定义的分布集合里考虑不利情形。集合如何定义、半径取多大,都属于模型选择,不能因为名称里有“稳健”就跳过验证。
论文第15页给出一种Wasserstein集合下的等价形式:经验标准差上加入与权重范数有关的缓冲,收益约束也需要留出相应余量。半径和距离的定义决定了缓冲的含义;另一个加权均值方差模型的重构形式更复杂,不能直接照搬同一条惩罚公式。
这部分主要贡献是理论表达与可计算重构。作者在第17页明确说明,本文没有再对DRO做数值实验。因此,它不能被介绍为“已经证明稳健组合比普通组合更赚钱”。稳健约束可能更保守,也可能减少机会;是否值得,需要另做样本外比较。
图从样本目标到可交易判断
从样本目标到可交易判断
真正需要留下的,是判断过程
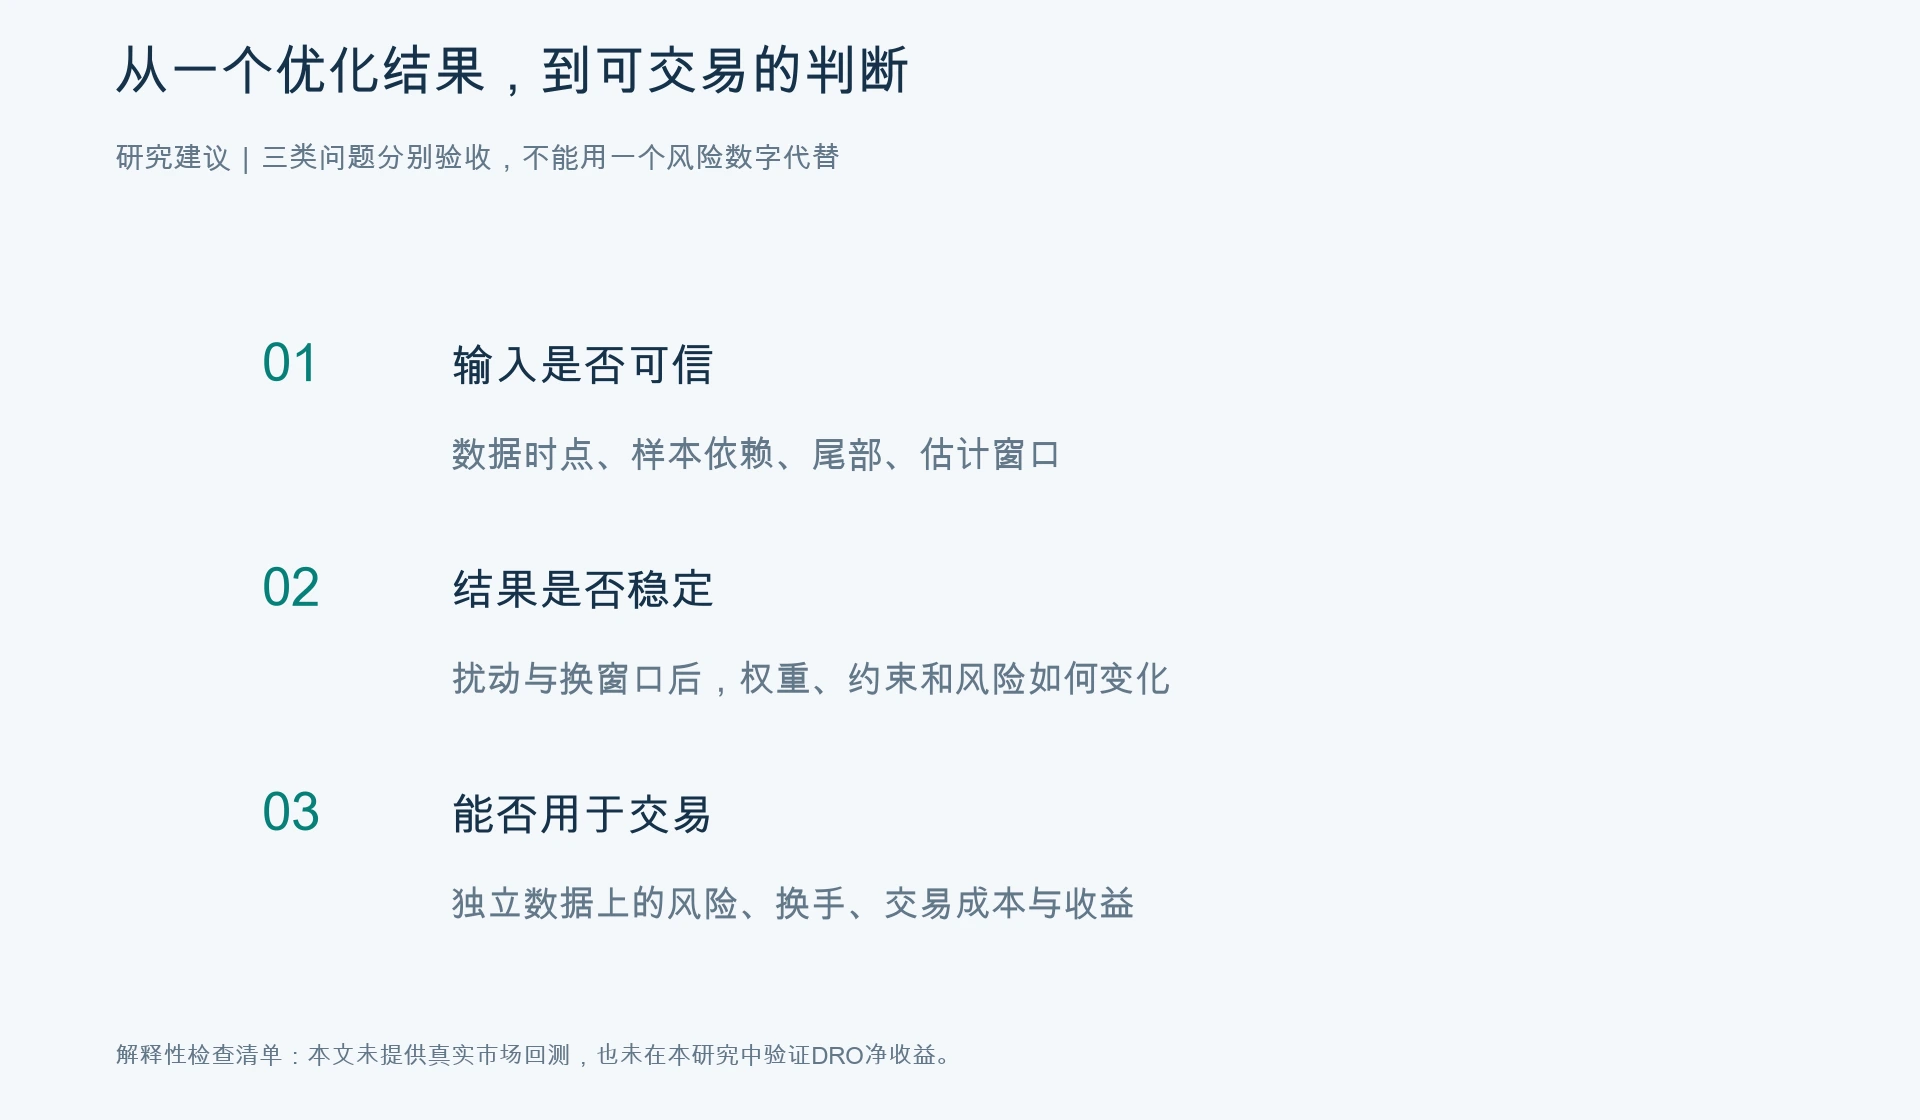
实践中,可以把检查拆到不同层面:先核对数据时点、估计窗口和收益口径,再观察换窗口、扰动样本后权重及风险估计如何变化,最后在未参与选择的数据上比较风险、换手、成本和收益。这里是由论文引出的研究建议,原文没有替这些真实交易环节提供验收结果。
还要留意论文的独立同分布前提。真实收益中的时间依赖、波动变化、市场结构变化,以及资产数量随样本增长的高维问题,都不能仅靠本文的固定问题渐近分析获得保证。原文也没有给出覆盖所有金融厚尾数据的通用置信区间。
下次看到一个更低的优化风险值,可以继续追问:它是在这份样本里变小,还是在独立数据里依然站得住?这两个问题分开回答,优化器的结果才有机会变成可信的组合决策证据。
论文与说明
Zhaolin Hu. Mean-Variance Portfolio Selection: Statistical Properties and Distributionally Robust Optimization. 本文依据arXiv:2610.15025v1,2026年10月10日版本,本地PDF共21页。作者注明较早版本曾于2025年10月上传ResearchGate。
论文:https://arxiv.org/abs/2610.15025v1
关键定位:第4页为样本定义;第7-12页为一致性、极限与正则化条件;第13-17页为DRO重构;第17页表1、第19页表2与图3为模拟证据。表内数据图按原文重绘,机制与检查图属于解释,未编造实盘曲线。
本文由AI辅助整理与制图,并核对原文数字和适用条件。内容仅供学习研究,不构成投资建议,历史模拟与理论结果不代表未来收益。
资料与阅读边界
本文为方法讨论与教学说明。文中示例不等于经独立验证的收益实证;如需具体数据、计算口径或资料来源,可通过官方渠道提出核对请求。
历史结果不代表未来表现。使用前请检查数据时间边界、样本独立性、交易成本及适用条件。
关键结论
- 样本内最优目标值不能替代样本权重的真实风险或样本外交易表现.
- 均值方差模型的估计波动可能受四阶矩影响, 正态极限有适用条件.
- 正则化能改变最优解与渐近方差, 但不自动解决所有厚尾和样本依赖问题.
- 本文DRO部分为理论重构, 没有新增DRO收益实证.