科学评估科学评估多重检验因子研究误报控制
显著信号越找越多,哪些只是碰巧?
研究越多,误报机会也越多。序贯柯西组合检验尝试在相关检验中辨认信号,但它的误报控制有条件,也不能直接证明交易价值。
本文要点
检验家族需要覆盖实际比较的候选, 单项显著性不能代表整组可信度.
SCC的检出能力与实际误报需要一起报告, 渐近保证有条件.
研究过一百个候选, 总能找到几个显著的结果. 因子、交易规则、资产alpha, 甚至盘中每一分钟的异常监测, 都会遇到同一个问题: 检验次数增加了, 碰巧越过阈值的机会也跟着增加.
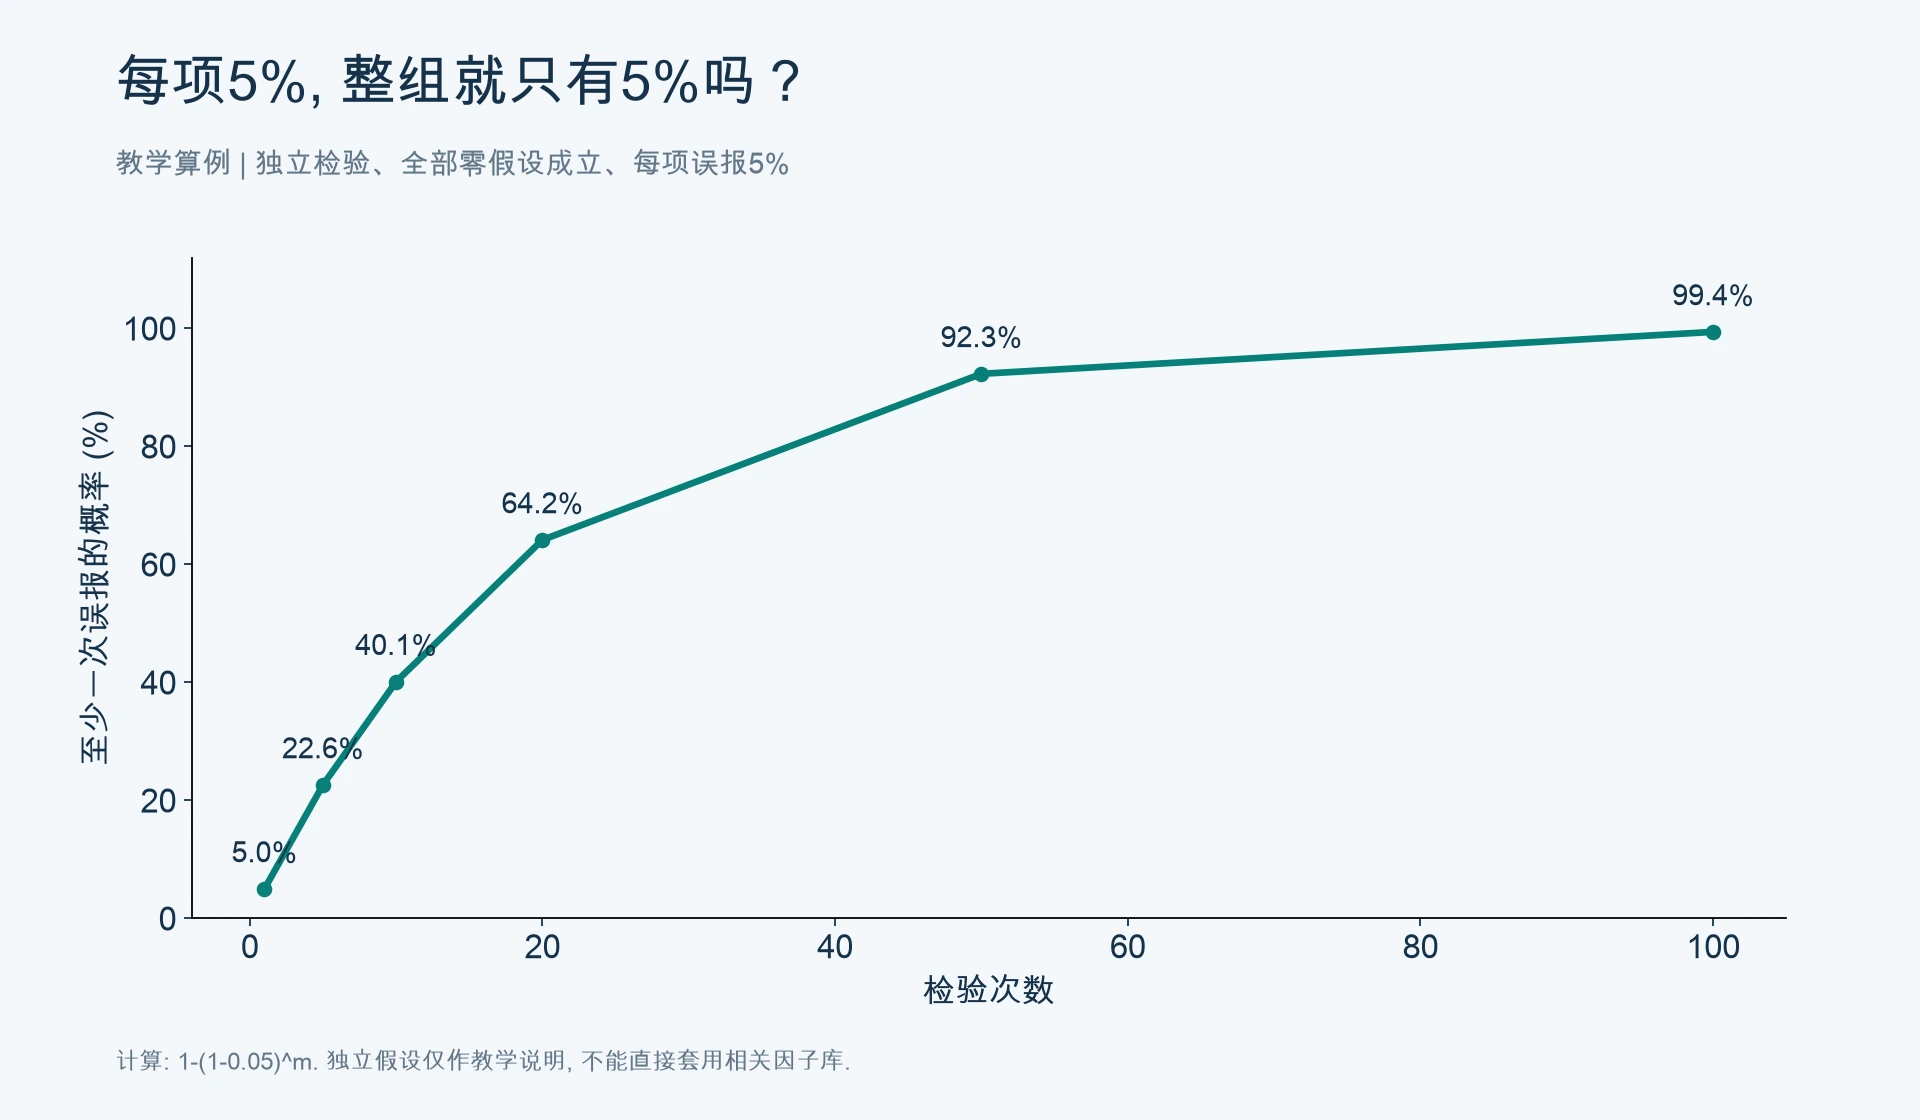
假设一百次检验彼此独立, 所有零假设都成立, 每次误报概率都为5%. 那么至少出现一次误报的概率是1减去0.95的一百次方, 约99.4%. 这是用于说明机制的理论算例, 不能直接套到高度相关的因子库.
《Sequential Cauchy Combination Test for Multiple Testing Problems with Financial Applications》研究的, 是怎样在大量相关检验中辨认单个信号. 它提出序贯柯西组合检验, 简称SCC. 值得读懂的既有它提高检出能力的做法, 也有误报控制背后的条件.
图显著信号越找越多哪些只是碰巧
显著信号越找越多哪些只是碰巧
先明确约束哪一种错误
这篇论文关注族错误率FWER. 它约束的是一整组检验中, 至少错误拒绝一个真实零假设的概率. 这里的"族", 就是研究者事先定义的检验家族.
这与错误发现率FDR不同. 后者关注发现结果中错误所占比例的期望, 并非同一个控制目标. 同样写着5%, 也不能互换解释.
常见的Bonferroni方法把整组额度分给每项. 如果一组有100次检验, 家族阈值为5%, 每项便与0.05除以100, 即0.0005比较. 它对依赖结构要求少, 但在一些强相关场景中会偏保守, 留下较多漏检.
这项代价很实际. 同一套行情构造的因子经常共享信息, 相邻滚动窗口也会共享观测. 原样使用独立检验的直觉, 往往不合适; 放松阈值而不控制整组错误, 又会把误报带回来.
图单次误报与整组误报
单次误报与整组误报
从整组异常, 追到单个信号
柯西组合检验先把每个原始p值做变换, 再加权组合, 得到一个整组检验的统计量. 很小的p值会产生很大的正向贡献. 在适用的尾部近似和分布条件下, 可以用标准柯西分布计算组合p值, 不必先估计完整的相关矩阵.
但整组检验只能回答"这一组是否有证据反对全部为零". 它不能直接告诉研究者, 应当把哪个资产或时点标出来.
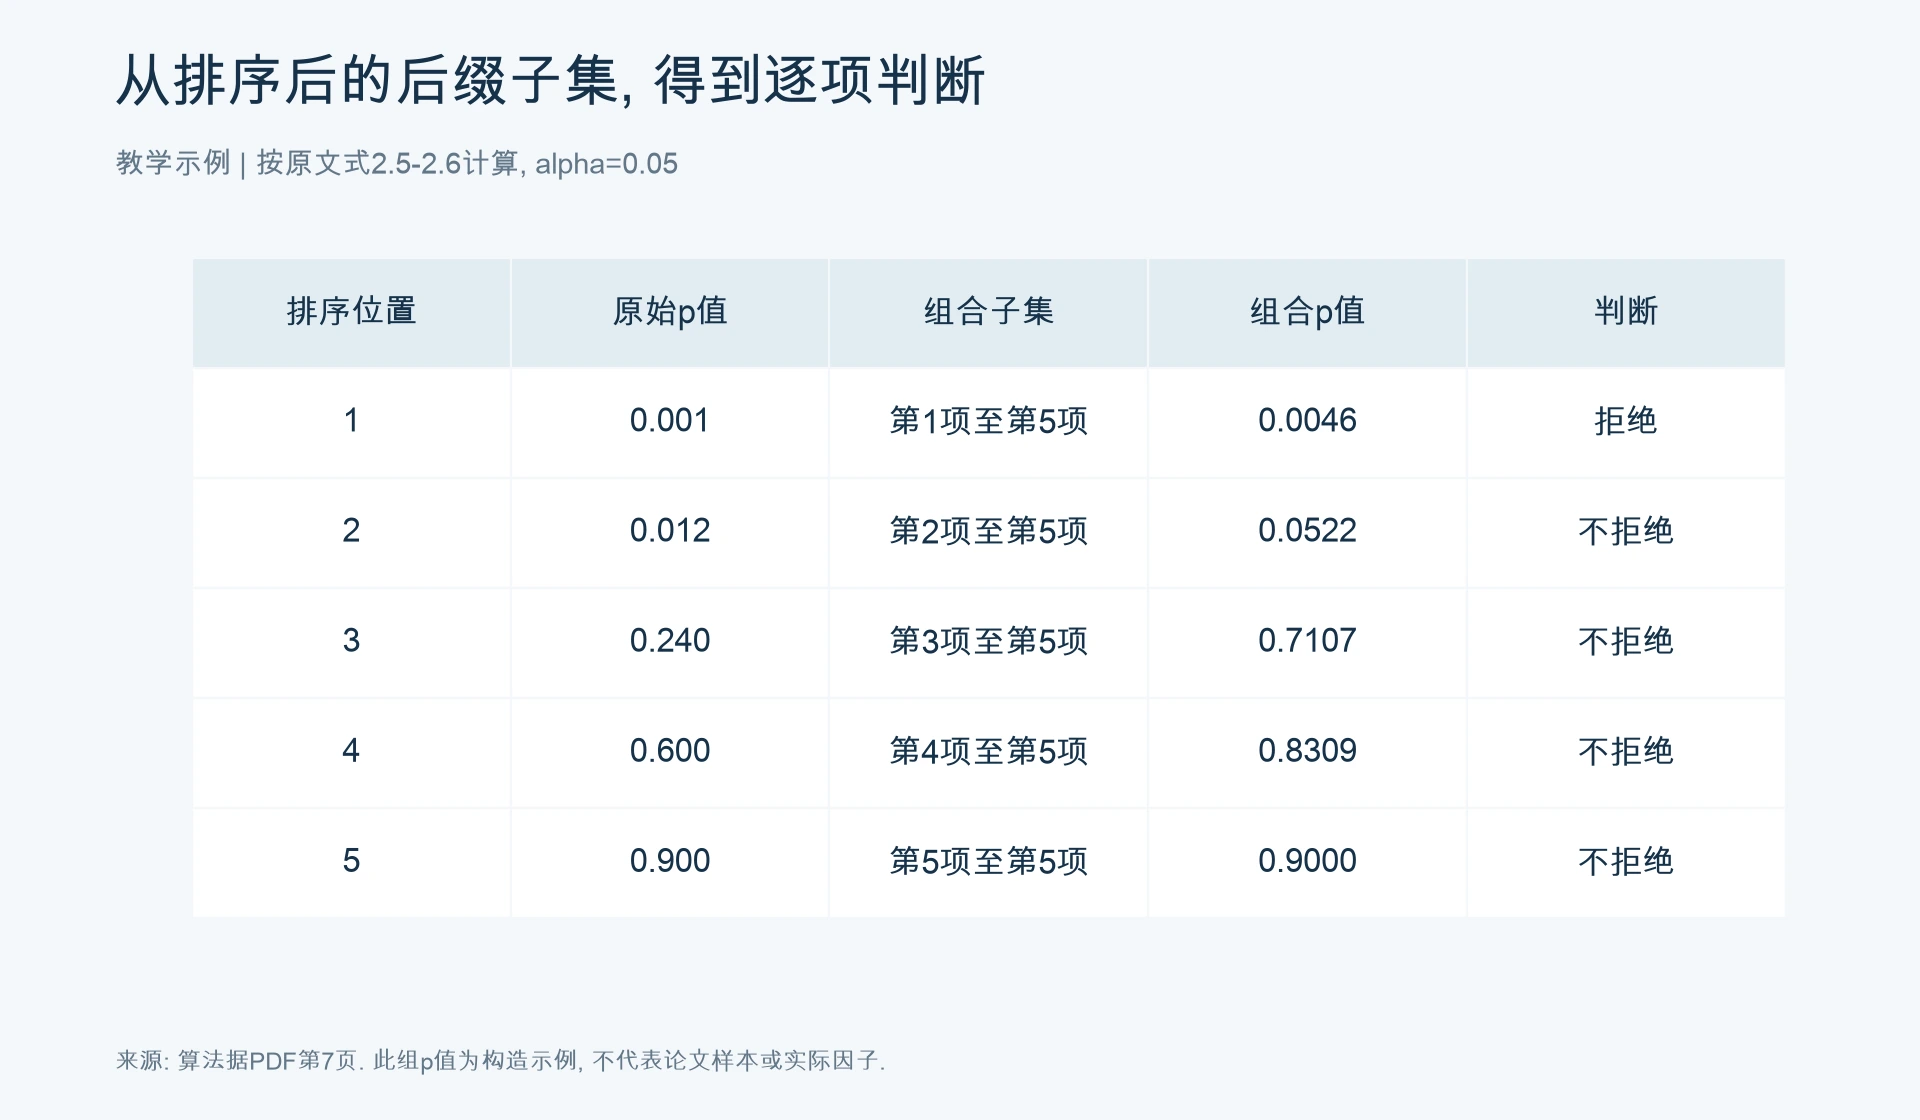
SCC把原始p值从小到大排序. 对第一个位置, 组合全部p值; 对第二个位置, 组合第二项直到末项; 依此类推. 每个后缀子集都得到一个组合p值, 据此判断对应位置的假设. 从计算方向看, 也可以从最大p值起逐步扩展子集.
它借助一组检验的信息寻找具体发现, 并非只把每项p值乘上一个固定次数. 图里的小算例只是按论文公式计算的机制演示, 不是论文实证, 更不是推荐的因子入库阈值.
图按排序后缀组合逐项判断
按排序后缀组合逐项判断
多检出一些, 同时要看多承担了多少误报
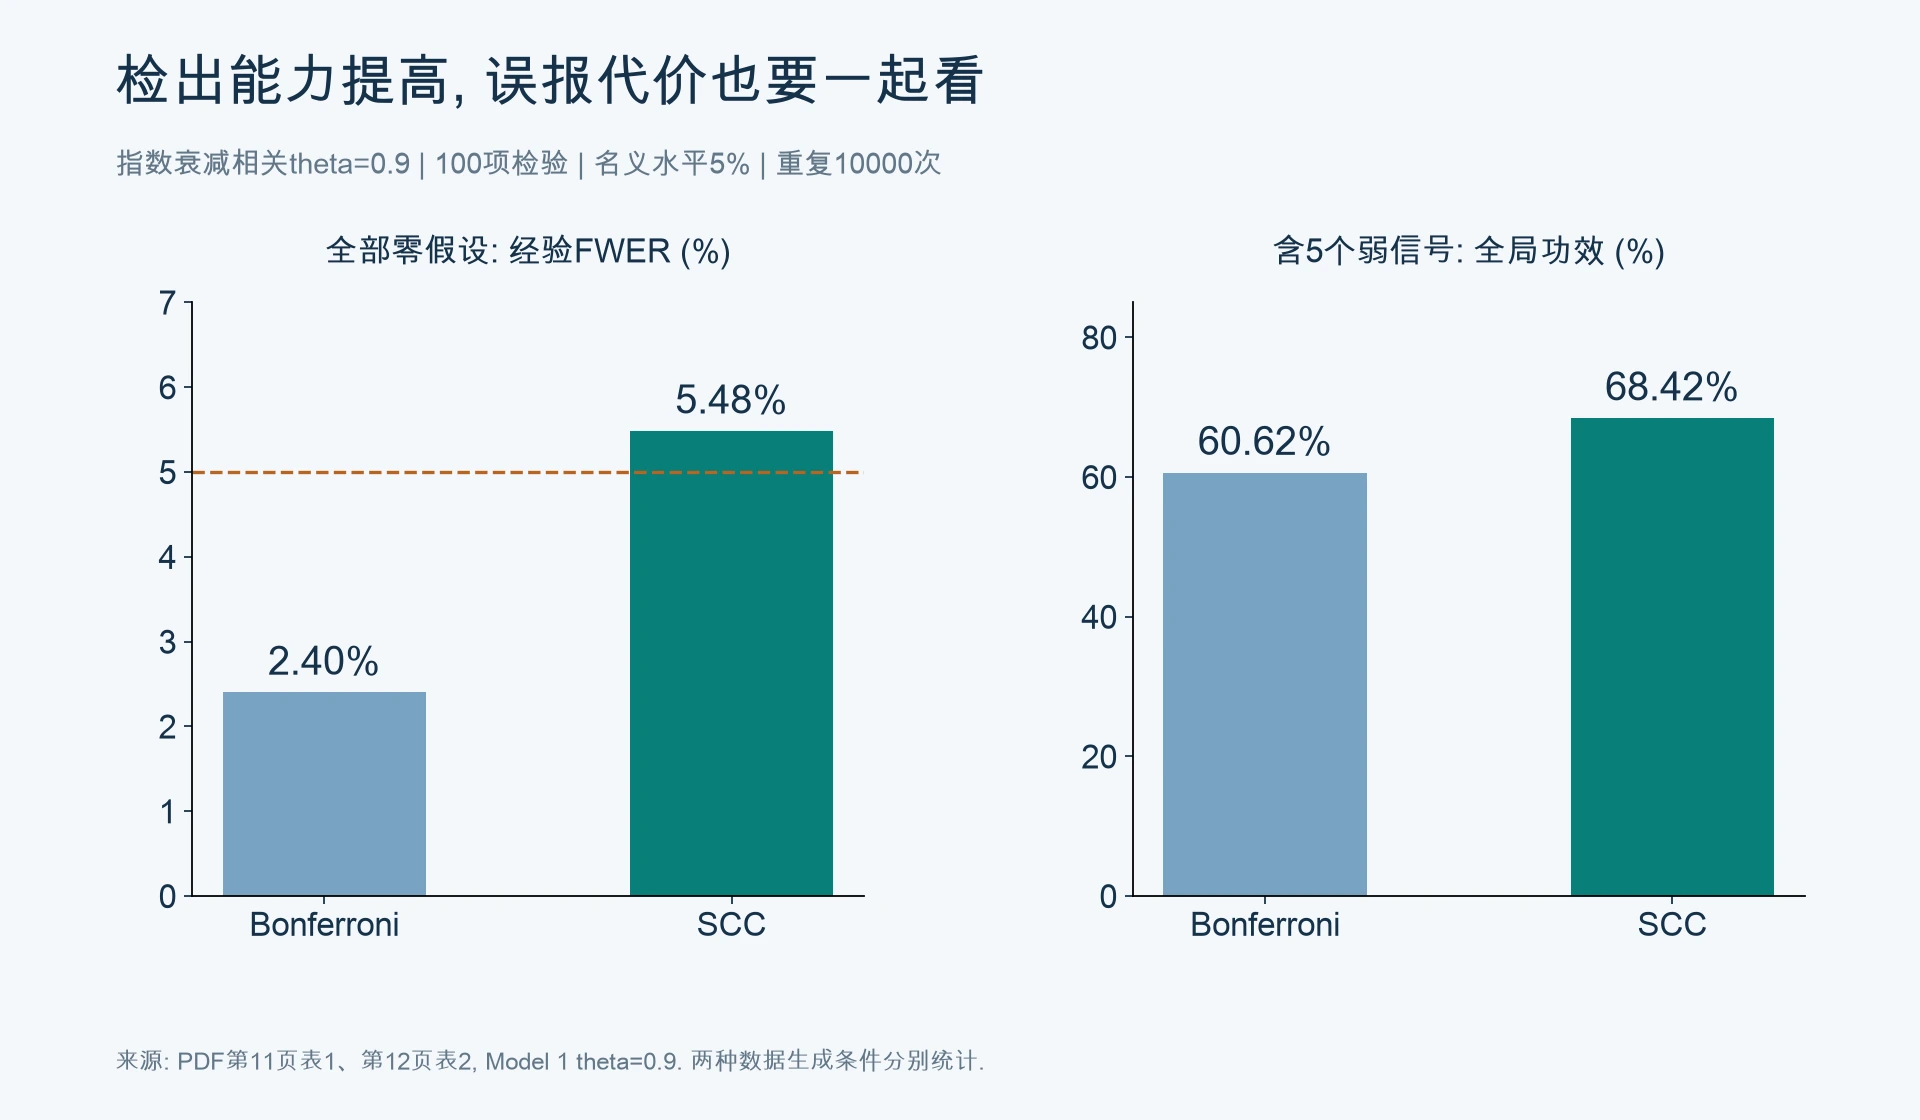
论文用相关的正态统计量做模拟. 在100项检验、名义水平5%的一个指数衰减相关场景中, 相关参数为0.9.
所有零假设成立时, Bonferroni的经验FWER为2.40%, SCC为5.48%. 加入5个弱信号后, 两者全局功效分别为60.62%与68.42%. 全局功效表示一次模拟中至少检出一项的频率, 并非全部信号识别正确的比例.
这一行结果把取舍摆得很清楚. SCC检出的机会提高了, 同时它在有限样本中承担的实际误报也高于Bonferroni. 不能只展示功效的提升, 省略2.40%与5.48%的差别.
尤其不能把名义水平5%写成"实测误报绝不超过5%". 原文表1有多行SCC结果高于5%, 其中一行为5.96%. 论文的理论保证是带条件的小显著性水平渐近结论, 与任意有限样本上的精确上界不同.
图误报与功效需要一起看
误报与功效需要一起看
资产alpha的实证, 发现更多不代表已经能赚钱
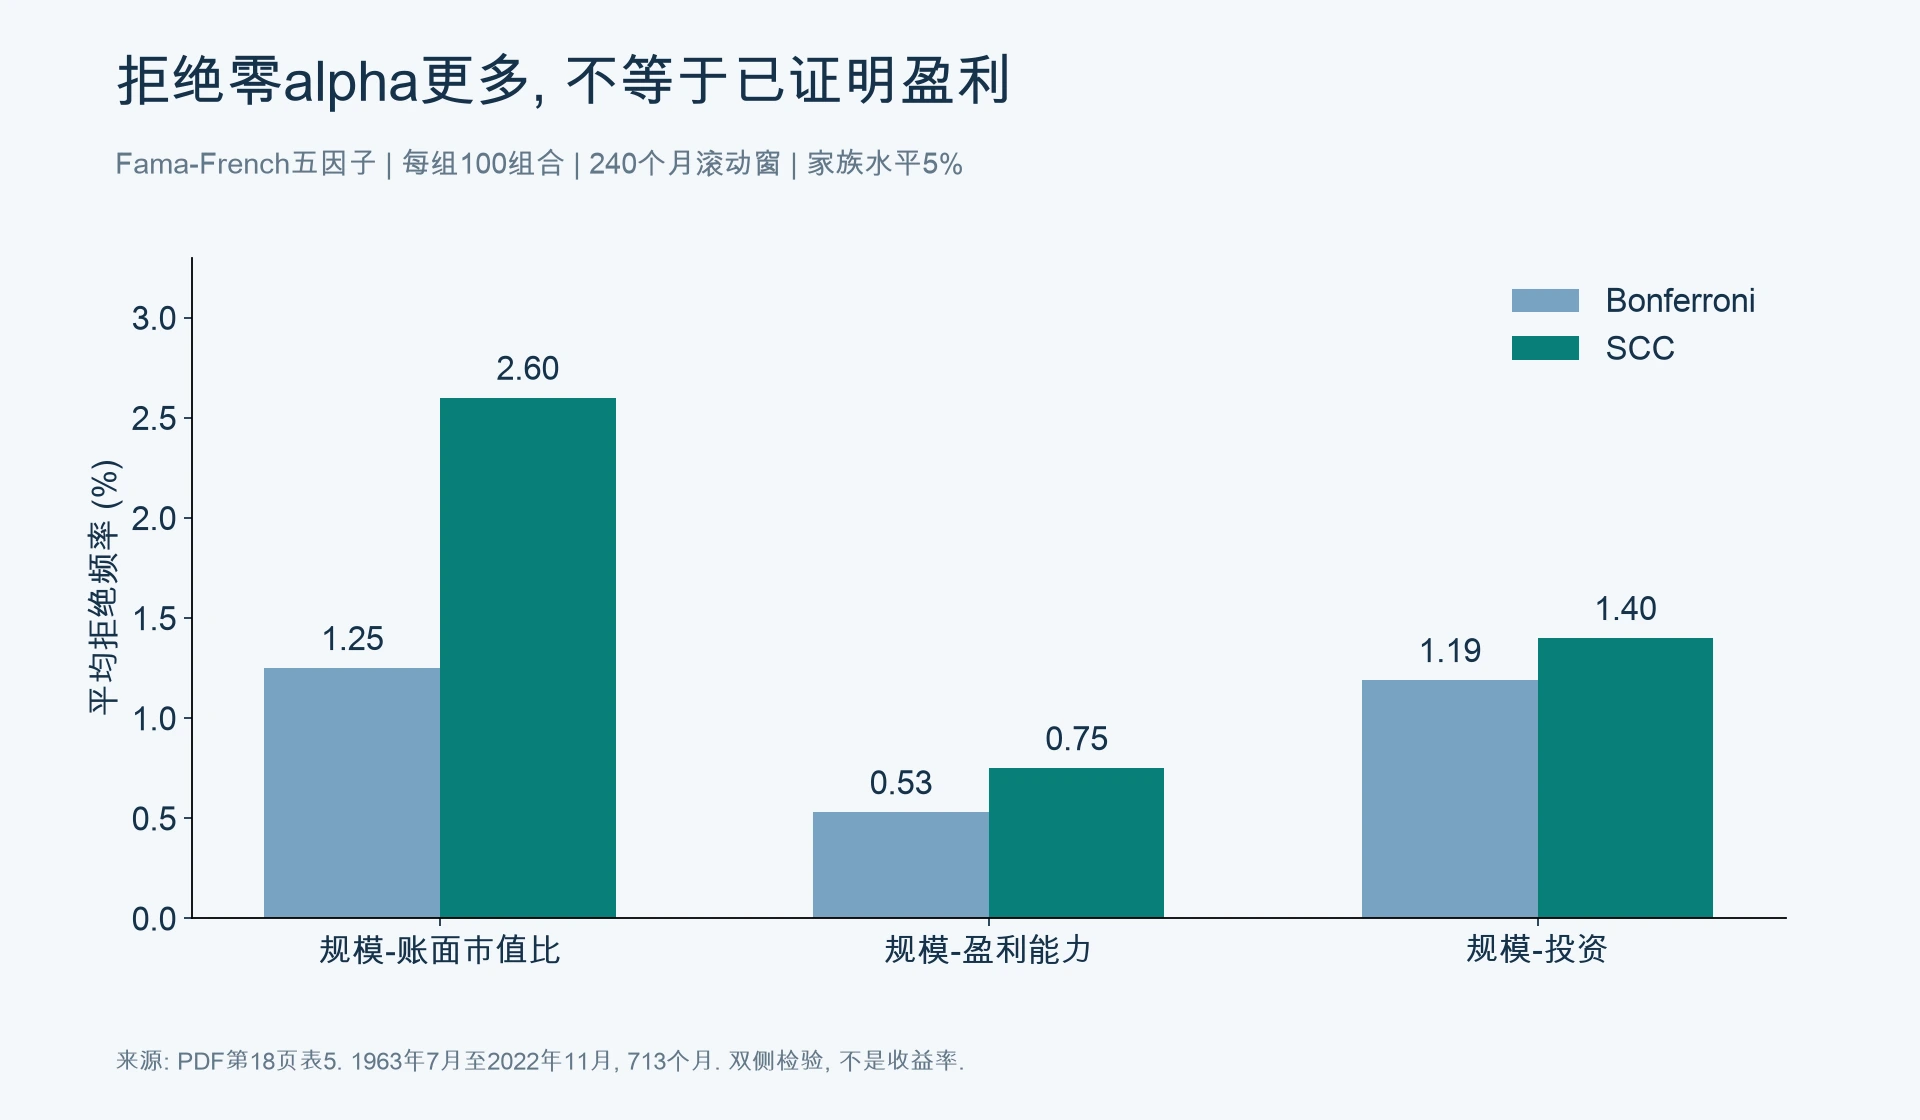
作者还在Fama-French五因子框架下, 检验Kenneth French数据库的组合alpha是否为零. 样本为1963年7月至2022年11月, 共713个月度观测, 使用240个月的滚动窗口.
规模与账面市值比、规模与盈利能力、规模与投资指标三种双重排序, 各形成100个组合. 每一组100个组合被视作一个检验家族, 名义FWER为5%.
规模与账面市值比组中, Bonferroni的平均拒绝频率为1.25%, SCC为2.60%; 规模与盈利能力组为0.53%和0.75%; 规模与投资组为1.19%和1.40%.
这里的2.60%是跨滚动分析的平均拒绝频率, 不是年化alpha, 也不是未来盈利概率. 原检验还是双侧的: 拒绝零alpha, 既可能来自正alpha, 也可能来自负alpha. 而且真实数据没有可供直接核对的"所有真信号名单", 多拒绝一些并不自动证明新增发现都正确.
这些发现说明, 校正方法会影响研究者如何判断一个定价模型的解释范围. 若要把结果转成策略, 还需要看方向、样本外持续性、费用、流动性与容量. 这些交易问题没有被一组显著性检验代替.
图零alpha假设的平均拒绝频率
零alpha假设的平均拒绝频率
用到自己的研究前, 把边界写清楚
SCC不要求研究者先知道完整的相关结构, 但这不等于没有分布假设. 论文理论要求零假设下统计量满足相关的双变量正态等条件; 在检验维度增长时, 还加入最大特征值和相关程度的约束. 原文脚注明确指出, 高维条件并不覆盖极强依赖或共享潜在因子的所有情形.
在alpha应用中, 原始t统计量也不严格满足正态假设. 作者用模拟考察这种偏离, 属于经验支持, 不能写成条件已经自动满足. 实施前, 需要检查自己的原始p值是否校准, 是否受序列相关、异方差或数据泄漏影响.
它也并非在所有场景都比重抽样更强. 补充材料的闪崩模拟中, 重抽样的全局功效为74.45%, SCC为69.75%. 持续上行与短促冲击的结果不同, 方法选择需要对应问题本身.
另一个容易漏掉的边界是时间. 在一个滚动窗口里控制100个组合的家族错误, 不意味着已经控制研究者跨几百个窗口、反复调参和筛选版本所产生的全部搜索风险. 实践中应记录候选总量、检验家族、模型基准、窗口和选择规则, 保留独立验证区间, 同时比较误报与检出结果.
对于批量研究团队, 有价值的改变是把"这次显著了"放回完整搜索过程判断. SCC提供了一种相关检验下的处理思路, 但发现是否可信、是否能交易, 仍需要各自的证据.
论文与说明
Nabil Bouamara, Sébastien Laurent, Shuping Shi. Sequential Cauchy Combination Test for Multiple Testing Problems with Financial Applications. 本文依据arXiv:2303.13406v2, 2023年6月1日版本, 文稿日期2023年5月31日. 本地PDF共35页, 含在线补充材料.
论文: https://arxiv.org/abs/2303.13406v2
关键定位: PDF第5至9页为定义、算法与理论条件, 第11至13页为模拟表1至3, 第18页为实证表5, 第29页为补充表S1. 配图分别标注原文重绘或教学示例, 未编造收益曲线.
本文由AI辅助整理与制图, 经原文数字及口径核对. 内容仅供学习研究, 不构成投资建议. 历史统计结果不代表未来收益.
资料与阅读边界
本文为方法讨论与教学说明。文中示例不等于经独立验证的收益实证;如需具体数据、计算口径或资料来源,可通过官方渠道提出核对请求。
历史结果不代表未来表现。使用前请检查数据时间边界、样本独立性、交易成本及适用条件。
关键结论
- 检验家族需要覆盖实际比较的候选, 单项显著性不能代表整组可信度.
- SCC的检出能力与实际误报需要一起报告, 渐近保证有条件.
- 零alpha的双侧拒绝不等于正收益或可交易机会.